ZeroFS:把 S3 桶挂成本地 POSIX 文件系统,还能在上面跑 ZFS 和虚拟机
阅读时间: 大约 7 分钟
ZeroFS:把 S3 桶挂成本地 POSIX 文件系统,还能在上面跑 ZFS 和虚拟机
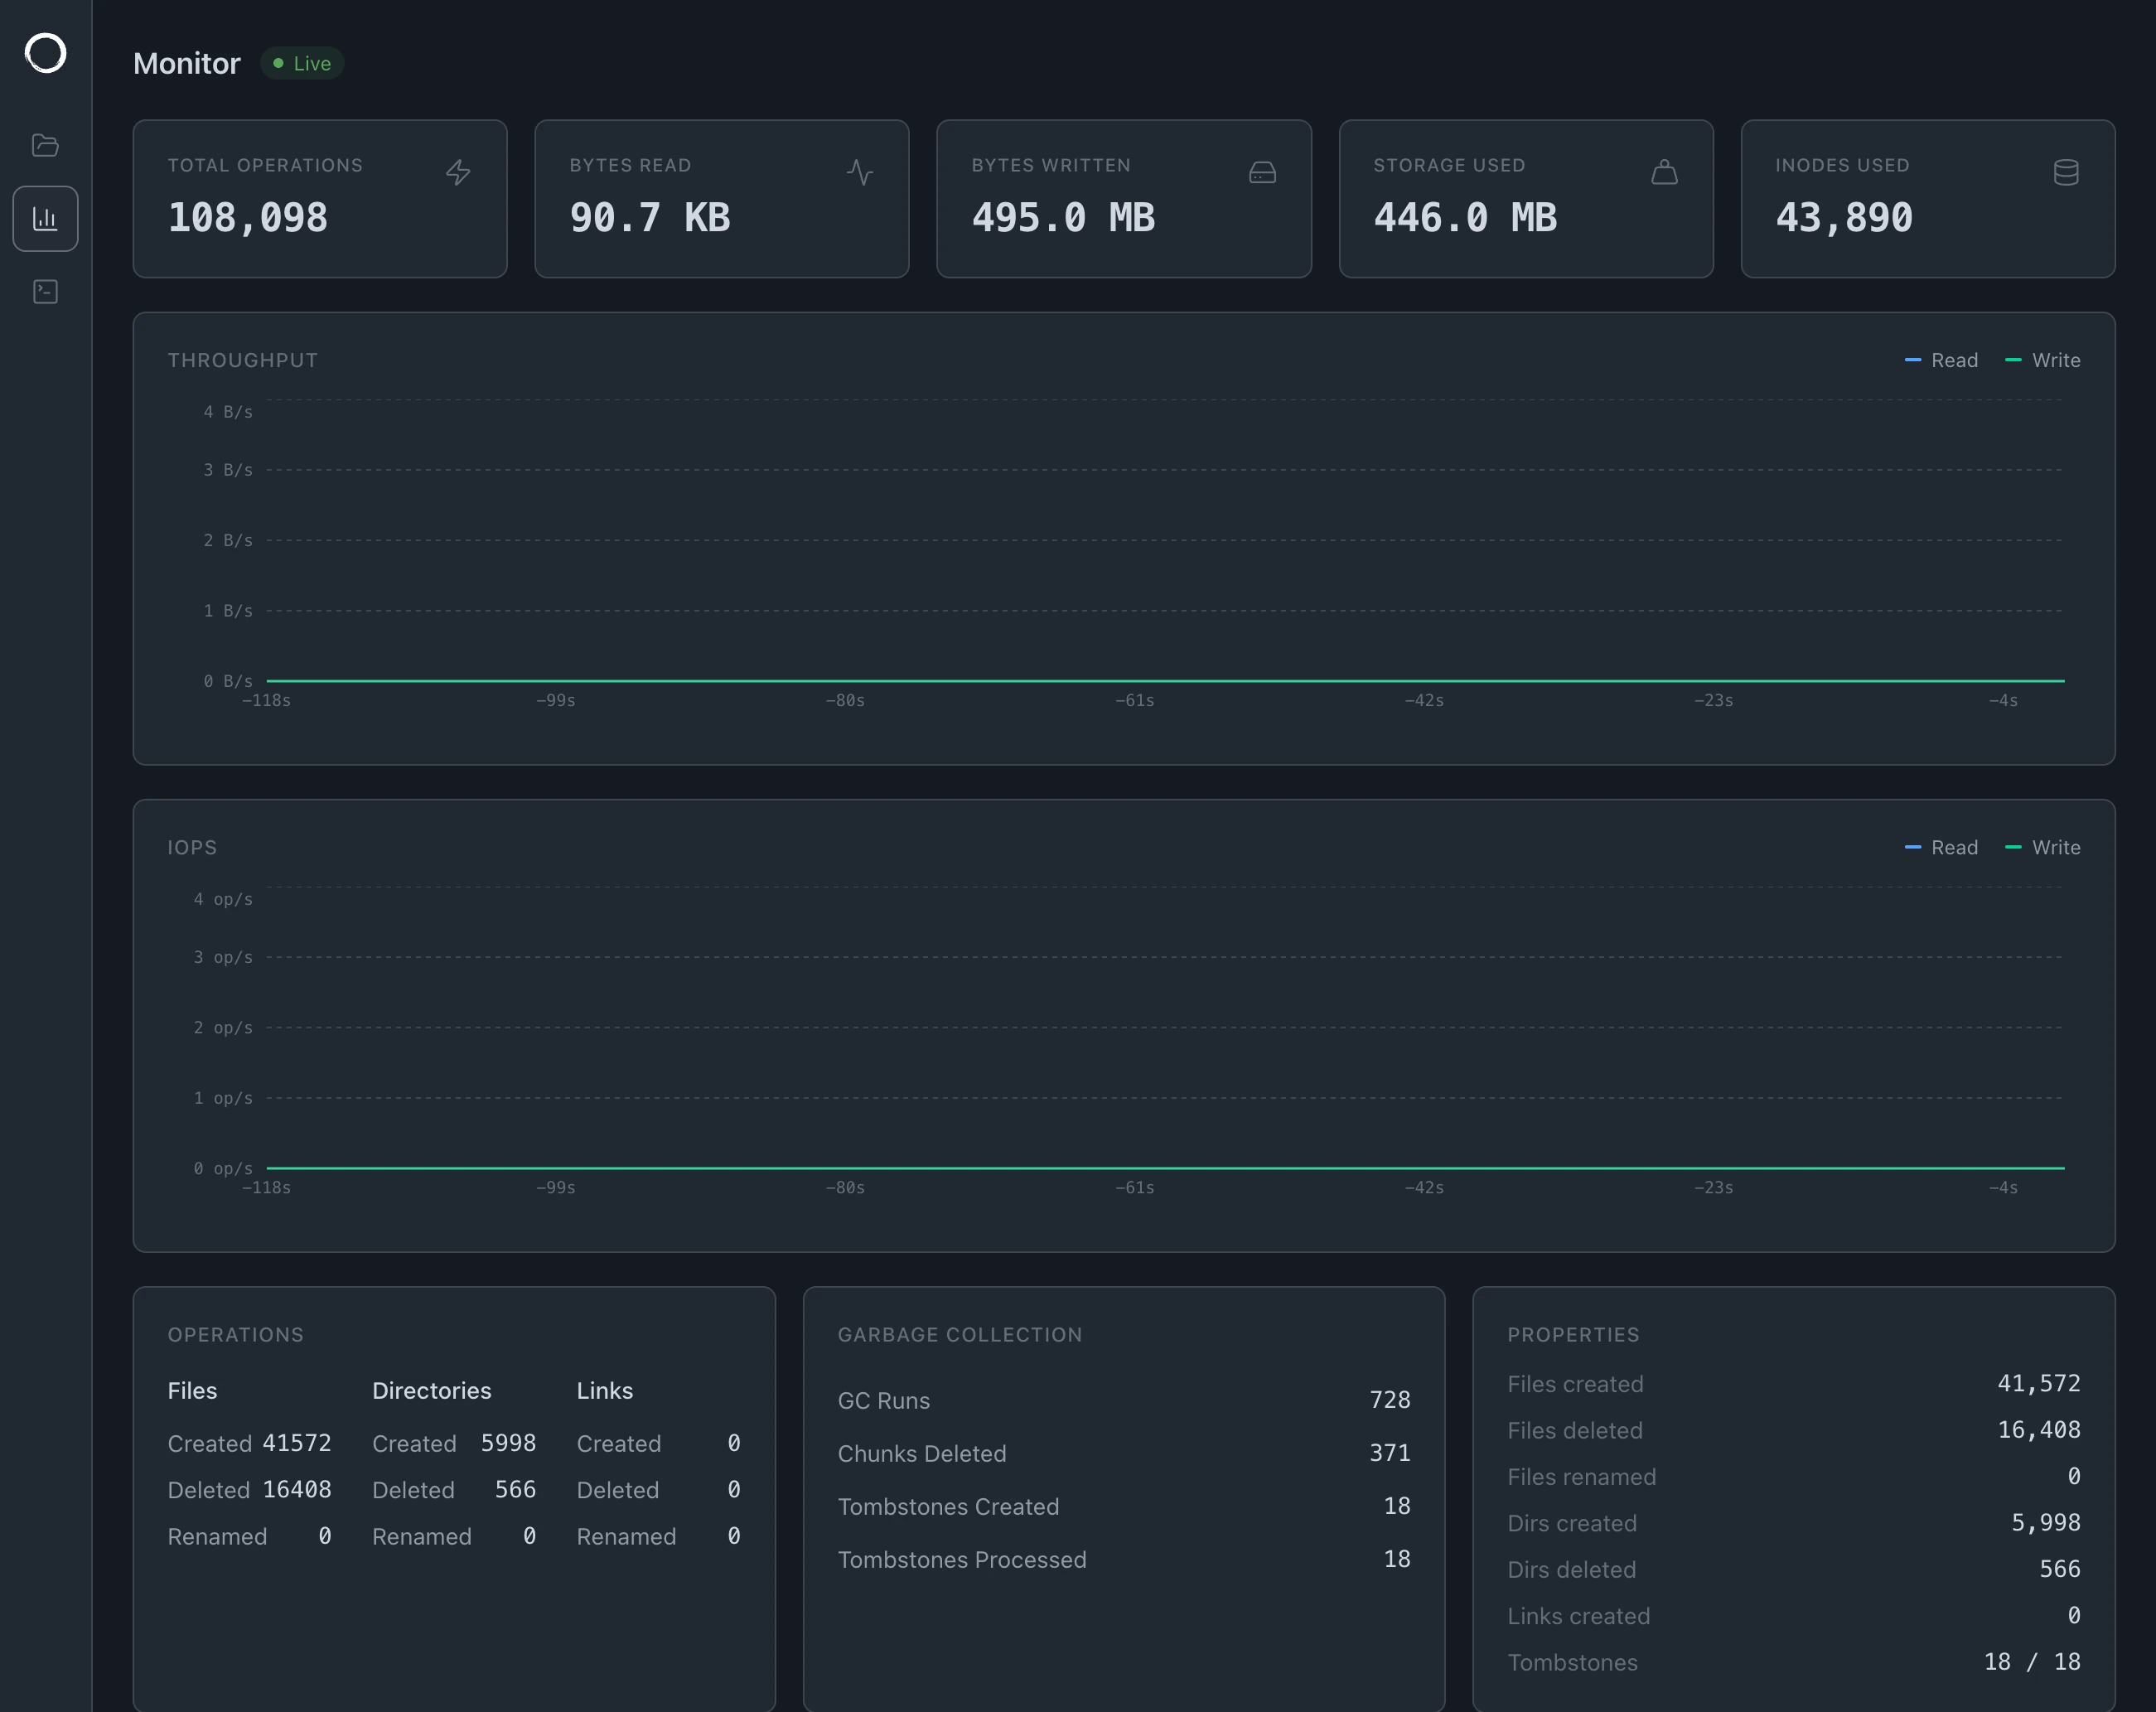
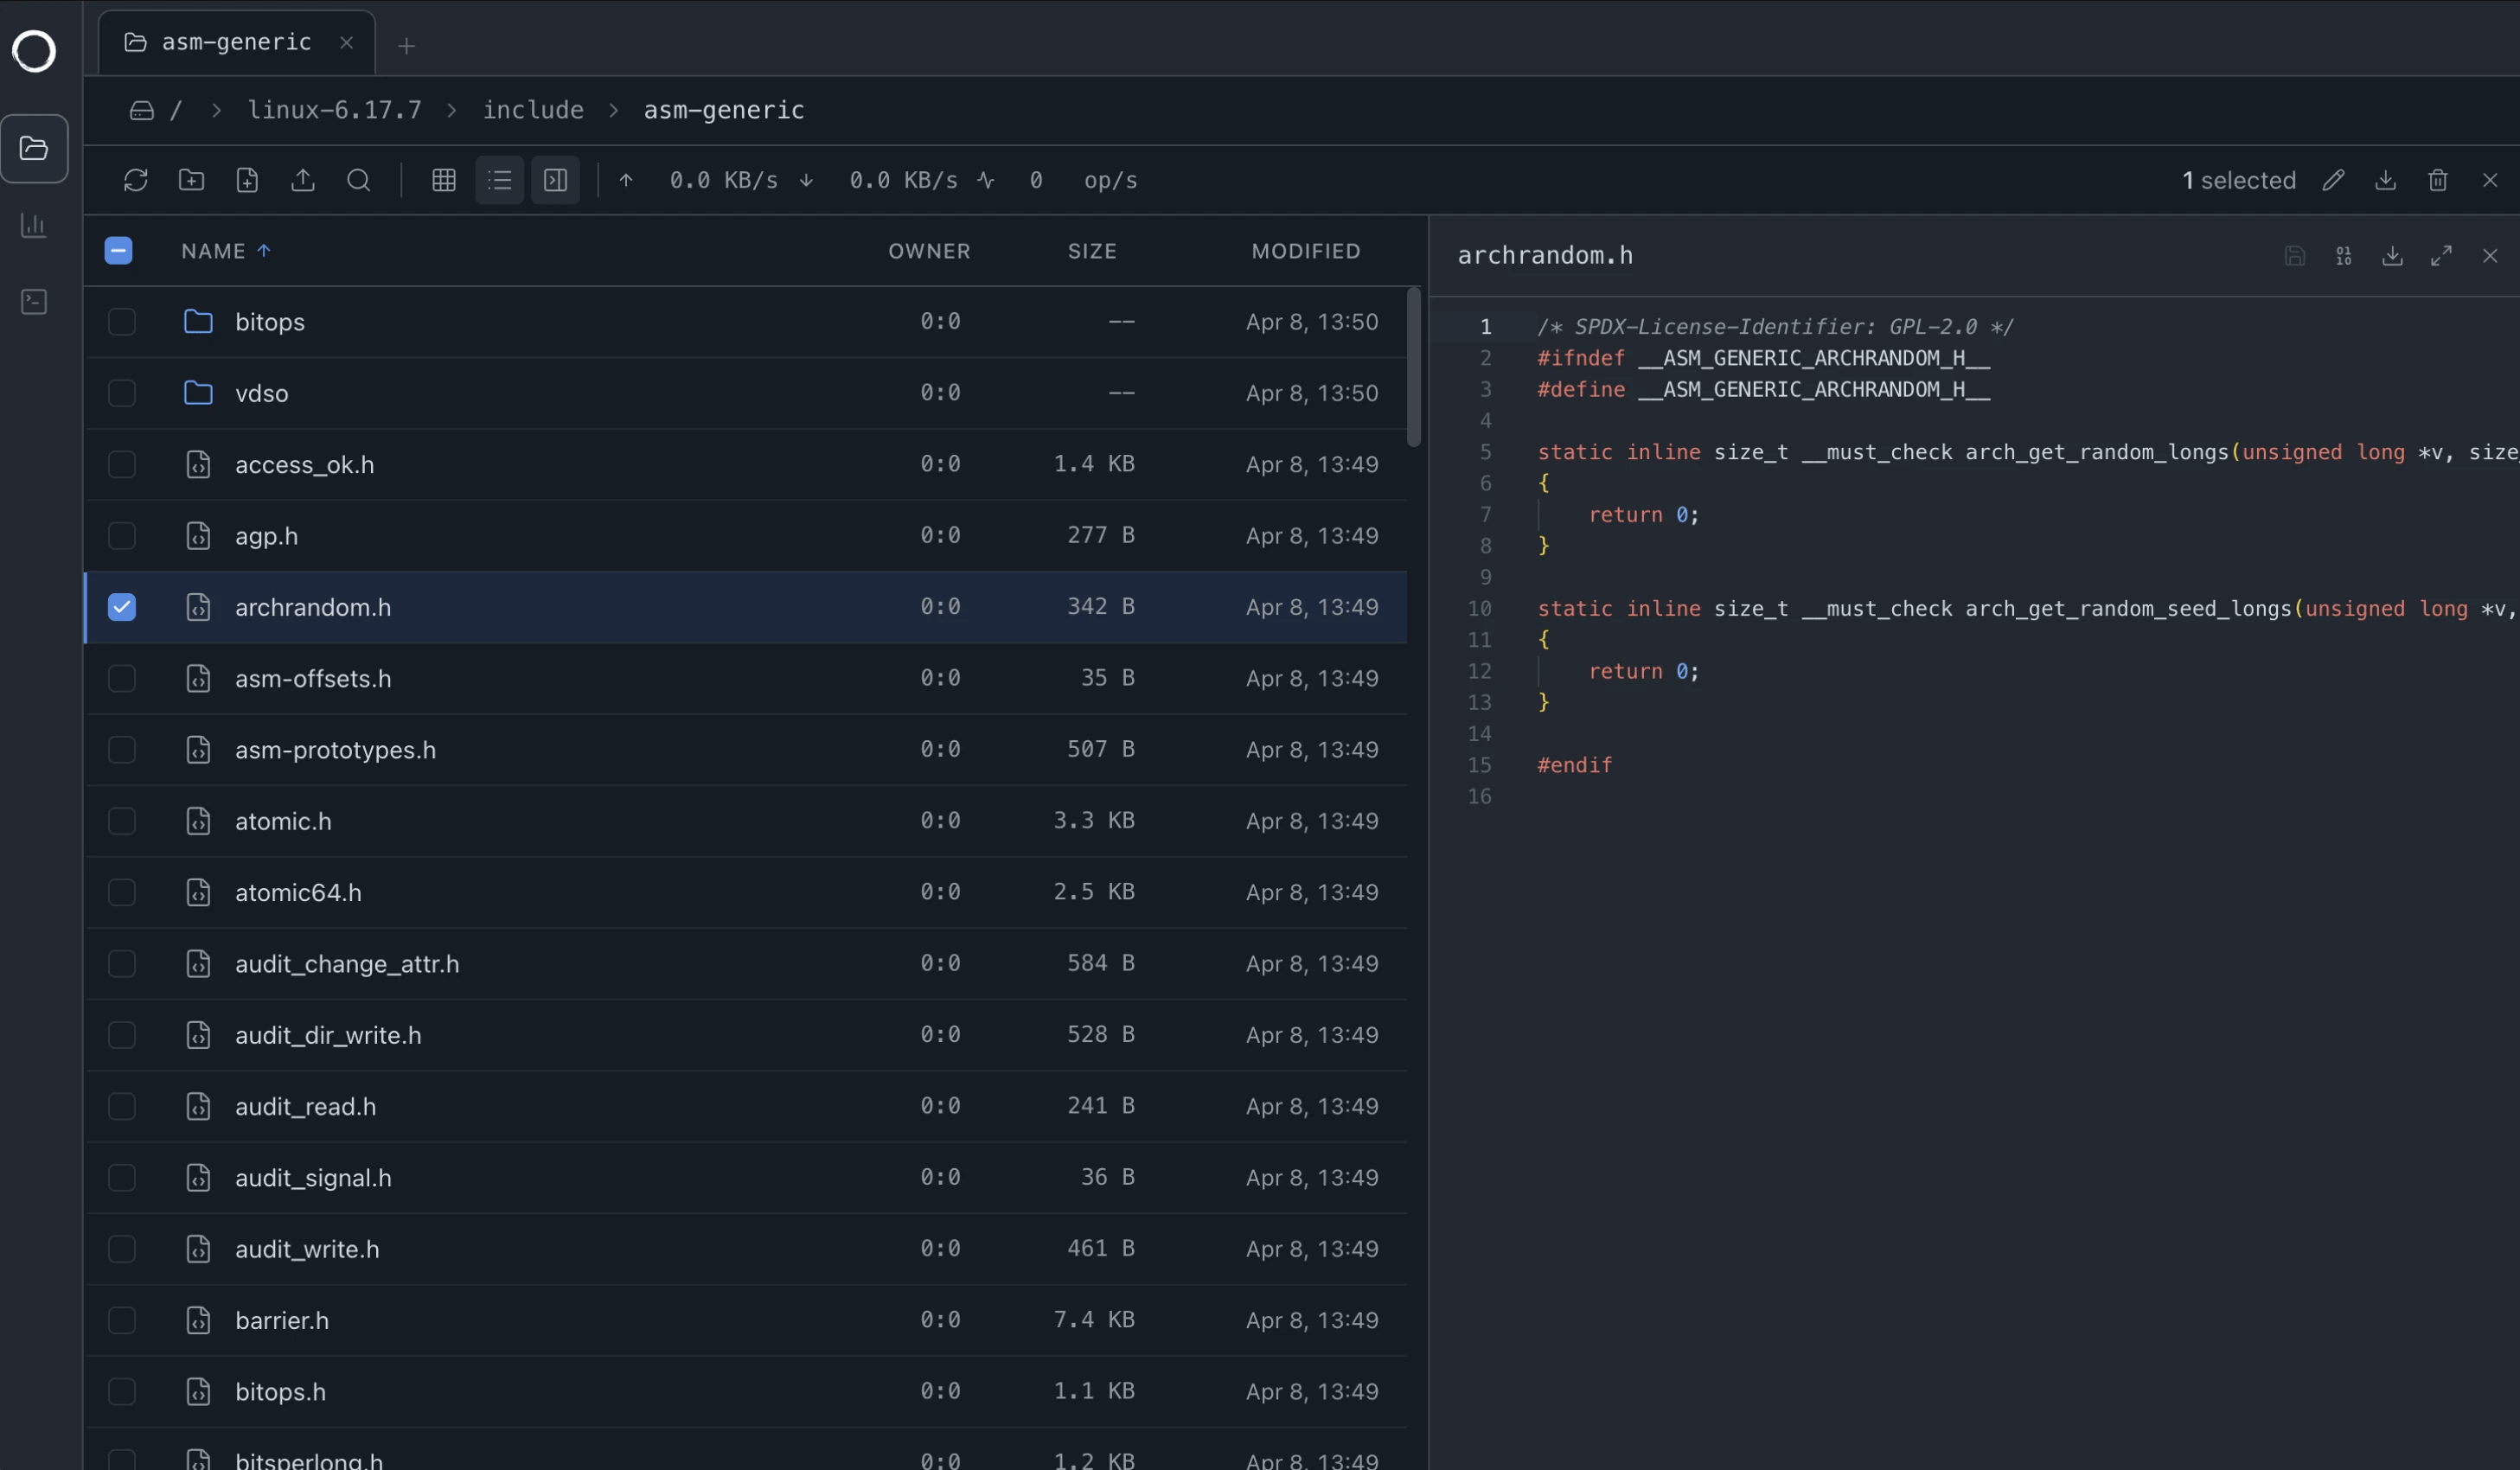
把对象存储当本地盘用的方案已有不少(JuiceFS、s3backer 等),ZeroFS 的激进之处在于:用一个用户态进程同时提供 NFS、9P 文件服务和 NBD 块设备三种协议,后端可以是 Amazon S3、GCS、Azure Blob、任意 S3 兼容存储甚至本地磁盘。它甚至直接在自己的 NBD 卷上跑 ZFS 池、scrub、编译 Linux 内核。GitHub 约 3.1k star。本文基于其官网做解析。
一、它是什么:一个进程,三种出口
ZeroFS 是一个日志结构文件系统:写出去的数据被打包成不可变 segment 对象,上传前先压缩再加密;热读走本地缓存。NFS、9P、NBD 三个服务器共享同一个进程、同一个桶:
- NFS:macOS、Linux、Windows、BSD 用系统自带 NFS 客户端即可挂;
- 9P:官方推荐的 Linux 挂载方式,可用自带 FUSE 客户端
zerofs mount或原生内核客户端; - NBD:
.nbd目录里的设备文件可通过nbd-client挂成裸块设备。
支持后端包括 Amazon S3、Google Cloud Storage、Azure Blob、任意 S3 兼容存储和本地盘。
二、存储引擎
- 切分与打包:文件数据切成 32 KiB extent,打包进最大 256 MiB 的不可变 segment 对象;
- 加密:每个 extent 上传前用 XChaCha20-Poly1305 加密;数据密钥由密码经 Argon2id 派生后包裹;
- 压缩:zstd 或 lz4,在加密前做;编码可随时切换、无需迁移,读时自动识别旧数据编码;
- 缓存:内存 + 磁盘两级缓存冷热数据;
- TRIM / 检查点 / 只读副本:TRIM 最终会回收真实 S3 对象;命名检查点可只读打开;单写者 + 任意多只读副本,副本返回
EROFS拒绝写; - fsync 与故障切换:在 9P/NBD 上成功 fsync 即代表数据已落对象存储;可选 standby 持有已 ack 未冲刷的写,秒级接管。
三、测试投入:远超同类开源项目
这是 ZeroFS 最值得一提的部分。官网列了一整套测试矩阵:
- 8,662 个 pjdfstest 用例:覆盖权限、属主、链接、rename 语义(少量用例因 NFS/9P 无法表达而排除);
- xfstests:标准文件系统测试套件;
- 内核编译:
make -j$(nproc)在 NFS、9P、FUSE 挂载上并行编译 Linux 内核,考验多进程同时写同一棵树; - stress-ng:dentry 抖动、深宽目录、rename、metamix、utime 等并发压力;
- ZFS 池 + scrub:CI 在 ZeroFS 块设备上建 ZFS 池、解压内核源码、跑 scrub;
- Jepsen:local-fs 套件用随机操作历史对照参考模型并带崩溃模式;HA 套件在 leader/standby 对上杀进程;
- 确定性仿真:存储引擎跑在虚拟时间、种子化故障注入、操作中途崩溃的模拟世界里,失败种子可精确复现,每小时浸泡 50 分钟。
官网给出的标志性数字是:在 ZeroFS NBD 卷上的 ZFS 里编译 Linux 内核只要 16 秒。它还演示了一个跨 us-east/eu-west/ap-southeast 三个 S3 区域的 ZFS mirror——每个 ZeroFS 实例把一个区域的桶暴露成块设备,对 ZFS 就是三块普通盘;某区域不可达时池降级但保持 ONLINE,恢复后自动 resilver。
四、口径与局限:NFS 的持久性是有意妥协
读官网时要抓住一个关键权衡:
- NFS 的 fsync 不保证落 S3:官网明确说”NFS COMMIT 语义允许 fsync 在数据到达 S3 之前就返回;当 fsync 持久性重要时请用 9P 挂载”。也就是说,图快选 NFS,图持久选 9P/NBD——别指望 NFS 挂载下 fsync 等于对象存储落盘。
- pjdfstest 不是满分通过:“少量用例因 NFS/9P 无法表达语义(或我们决定做权衡)而排除”——POSIX 兼容性是工程取舍,不是严格逐字节对齐。
- “16 秒编译内核”是特定场景数字:在它自己的 NBD+ZFS 配置、本地/特定网络条件下测得;Koala 也提醒,延迟敏感型负载上生产前必须自行压测——S3 的首字节延迟与对象粒度决定了它不适合数据库这种随机小 IO。
- 单进程架构是双刃剑:一个进程服务三种协议、共享一个桶,部署简单,但也意味着它是这一层的吞吐/可用性焦点(虽然有 standby 秒级接管)。
- 3.1k star 说明项目仍年轻:虽测试矩阵亮眼,但生产案例与长期运维沉淀还在积累。
五、客观分析:优势与谁该用
优势:用 S3 的成本拿到”本地盘”体验,且不止文件语义——NBD 块设备让 ZFS、VM 都能直接跑在对象存储上;加密/压缩/检查点/只读副本/跨地域 mirror 一应俱全;测试投入(Jepsen、内核编译、确定性仿真)在同类开源项目里少见。
局限:随机小 IO/数据库类延迟敏感负载要压测;NFS 挂载的持久性需显式选型;项目年轻,生态与文档成熟度待观察。
适合谁:想用 S3 成本跑大文件、构建缓存、跨地域分发、把对象存储当弹性块设备的团队;尤其适合能接受”先压测再上生产”、追求自托管与数据加密的基础设施团队。