YDB:Yandex 开源的分布式 SQL 数据库,一套系统吃下 OLTP+OLAP+流
阅读时间: 大约 11 分钟
YDB:Yandex 开源的分布式 SQL 数据库,一套系统吃下 OLTP+OLAP+流
在已经非常拥挤的分布式数据库赛道里,YDB 走的是一条”大公司自研、先在生产里跑稳、再拿出来开源”的路线:它来自俄罗斯最大的门户网站之一 Yandex,据 Koala 项目库介绍,它在 Yandex 内部已经服役多年、并作为云服务商业化对外提供后才开源。官方给自己的定位是”Beyond Distributed SQL Database”——一个在单系统里同时承载 OLTP、OLAP 与流式负载的通用数据库。本文基于 ydb.tech 官方文档,客观拆解它的架构机制、可核对数字与官方自己标注的边界。
一、背景动机:为什么 Yandex 要自研
Yandex 作为一家同时拥有搜索、电商、广告、地图等业务的大型互联网公司,很早就需要一个既能扛高并发在线事务、又能做实时分析、还得跨机房容灾的数据库。市面上当时的选项往往顾此失彼:NoSQL 能扩但丢事务与一致性,传统 RDBMS 强一致但难水平扩展,专用数仓又和业务库割裂。YDB 的设计目标就是把这几件事放进一套架构里:官方文档称它是”horizontally scalable, distributed, and fault-tolerant database system”,从几个节点的小集群一路扩展到”thousands of servers”、处理”hundreds of petabytes of data”。
二、是什么:概念与定位
按官方文档的定义,YDB(IPA 读作 wai-di-bi)是一个”fault-tolerant distributed SQL DBMS”,提供高可用、水平扩展、强一致与 ACID 事务,查询用的是它自己的 SQL 方言 YQL。它的几个关键定位点:
- 行列共存:同时支持行存表(OLTP)与列存表(OLAP),而且”同一套事务与一致性级别”,不是两套拼接的引擎;
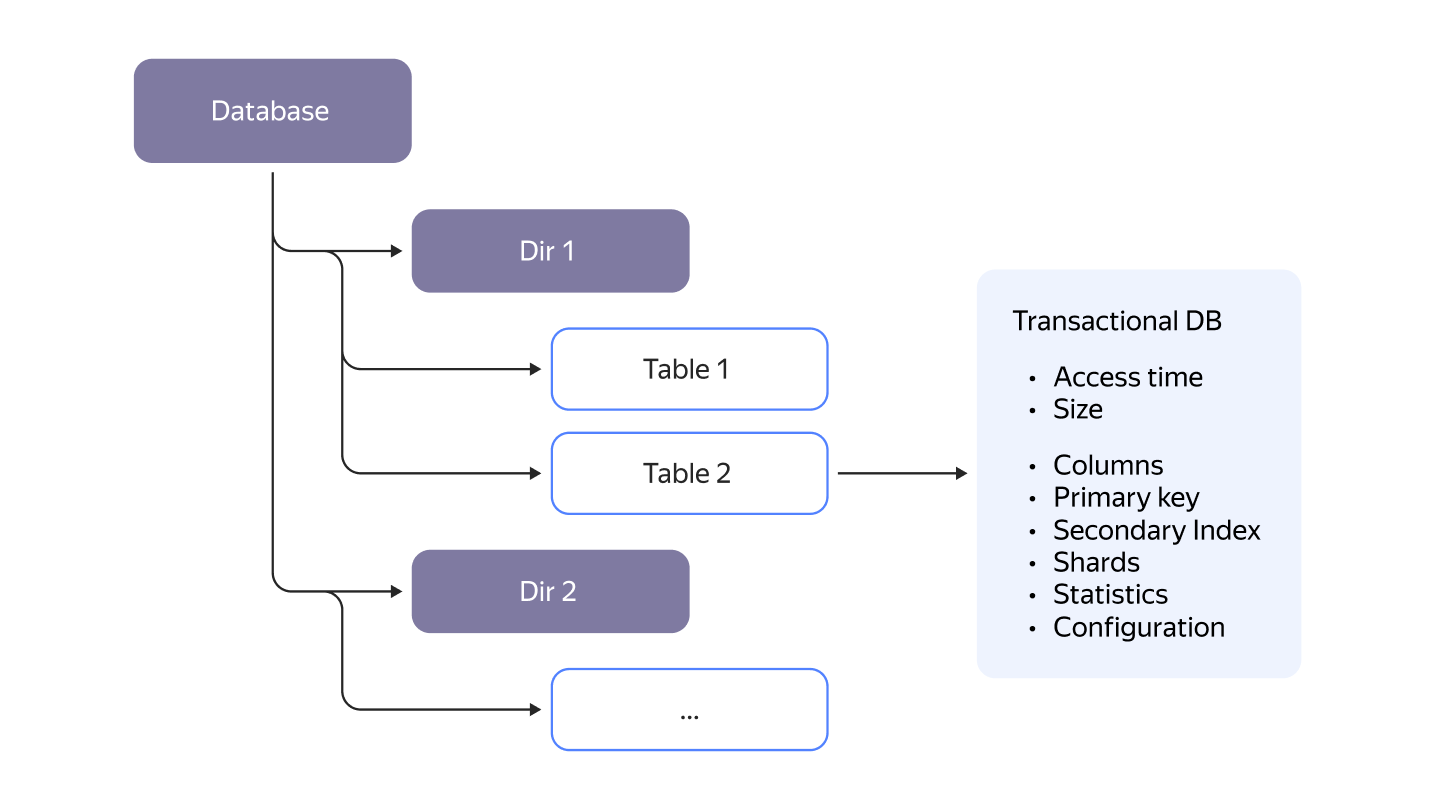
- 层次命名空间:表、Topic 等对象按类似文件系统的层次组织;
- 原生流式:Topics(兼容 Kafka 协议)+ CDC(把表变更实时发布成 Topic)+ Transfers(Topic 到表的自动 ingestion);
- 向量能力:原生 vector index,支持近似 KNN,官方称可扩展到”数十亿 embeddings”,并提供 MCP Server 让 LLM 直接用 SQL 查库。
三、技术机制:分层架构与 Tablet 模型
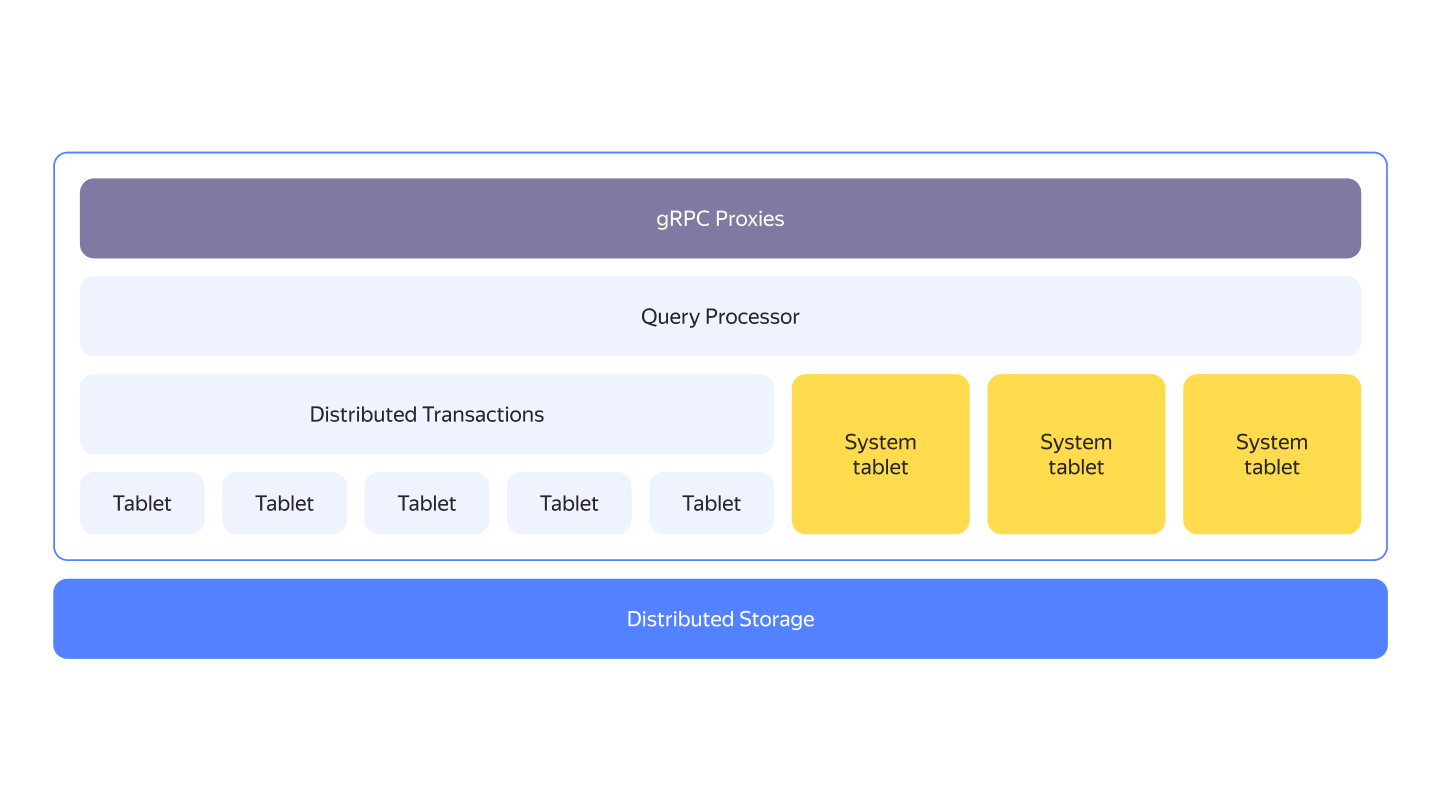
YDB 的架构是典型的”计算与存储分离 + 分片自治”模型。从上到下分几层(见官方架构图):
- gRPC Proxies:接入层,负责协议接入、路由与认证;
- Query Processor:分布式执行计划器与优化器,官方称列存走的是”MPP Vectorized Query Engine”;
- Distributed Transactions + Tablets:这是 YDB 的核心抽象。数据被切成一个个 Tablet(数据 Tablet 与 System Tablet 两类,图中黄色即系统 Tablet),每个 Tablet 是一个带状态、可复制、可独立分裂的小型事务单元。分布式事务跨多个 Tablet 协同,提供可串行化隔离的全局 ACID;
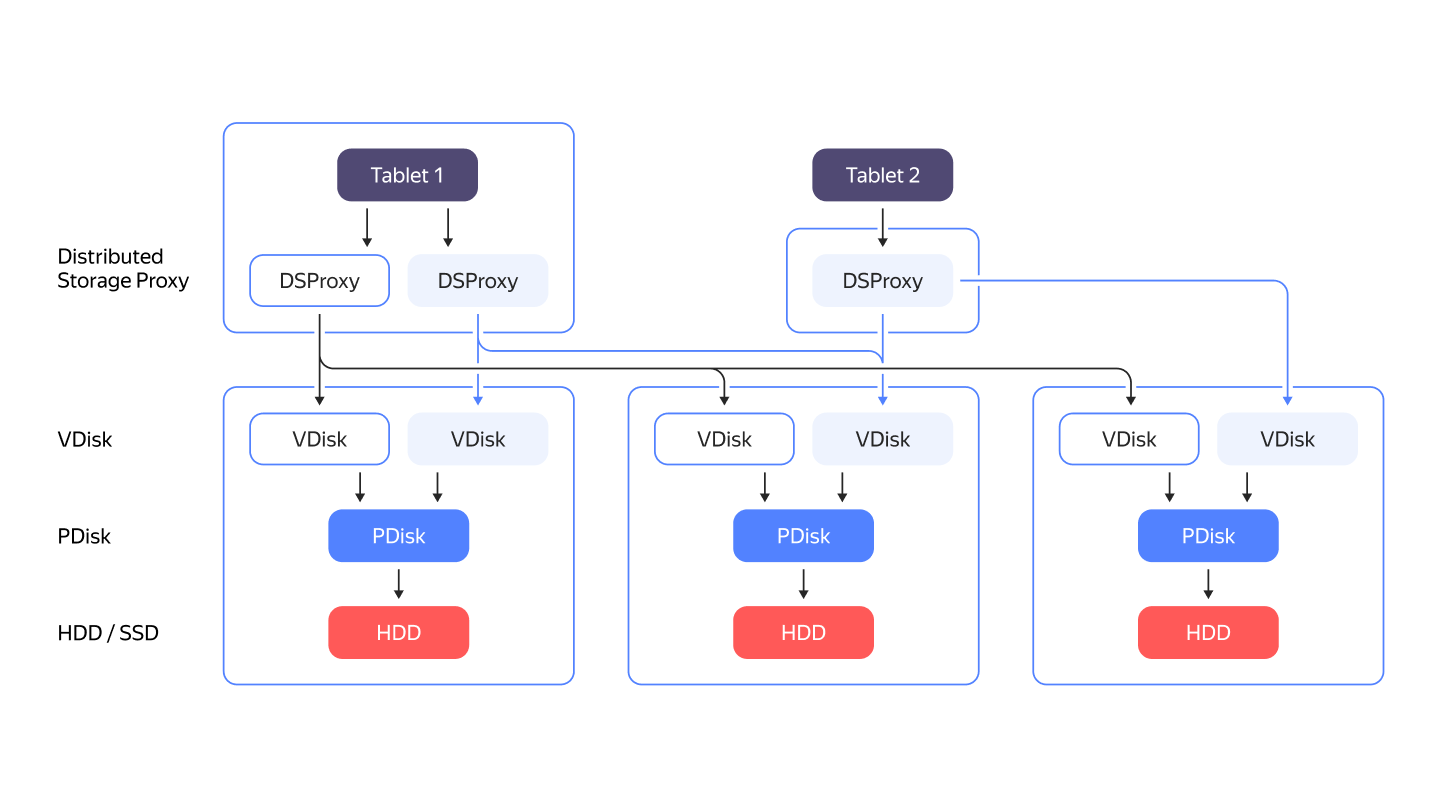
- Distributed Storage:底层是一套独立于表格逻辑的分布式块存储。Tablet 不直接落盘,而是通过 DSProxy 访问一组跨机架的 VDisk(虚拟盘),VDisk 再落到物理节点的 PDisk(一块 HDD/SSD)上。数据多副本同步复制,节点、机架甚至可用区故障都能自动恢复。
这套”Tablet + 分布式块存储”的拆分带来两个工程后果:其一,计算节点(跑 Tablet 与查询)和存储节点(PDisk)可以独立扩缩;其二,自动均衡既按”负载”分裂 Tablet,也按”数据大小”分裂,扩容/缩容在线进行、自动 rebalance。
四、关键数据:官方口径
需要强调,下表数字均来自官方文档自述,而非第三方 benchmark:
| 项目 | 官方口径 |
|---|---|
| 典型单节点 QPS | 官方称”a typical cluster node can process tens of thousands of queries per second” |
| 集群规模 | 从几个节点到”thousands of servers” |
| 数据规模 | 可处理”hundreds of petabytes of data” |
| 一致性 | 分布式事务默认可串行化隔离,可按需放宽隔离级别换性能 |
| 部署形态 | 跨机房(cross-datacenter)地理分布式配置 |
| 兼容协议 | Topics 兼容 Kafka API 3.4.0;对外提供 S3 联邦查询 |
| 典型用户(官方展示) | Yandex、Fix Price、1C-Bitrix、Auto.ru、Intensa |
五、评测方法与口径偏差
- “高性能”是量级描述而非可复现数字:文档只给了”单节点数万 QPS”这种定性量级,没有公布在固定硬件、固定版本下的 P50/P99 时延、吞吐对比表,也没有与 PostgreSQL/CockroachDB/YugabyteDB 等同类系统的同场对比;
- 规模数字是设计上限:“hundreds of petabytes""thousands of servers”描述的是它内部最大部署的能力,不等于任何团队开箱即得的水平;
- 用户案例是 logo 墙:首页展示的 Fix Price、1C-Bitrix、Auto.ru 等是信任背书,并未公开各自的负载规模与迁移代价;
- “同一套事务跑 OLAP”有前提:列存表虽然声称与行存表同一致性级别,但 MPP 向量化引擎在事务隔离、写入延迟上的实际取舍,文档并未展开数字。
六、适用 / 不适用场景
适用: 需要单系统同时扛高并发事务与实时分析、又要强一致 ACID 的业务(订单、库存、账号);已经在用 Kafka、想把”消息流 + 表”放进同一事务边界的团队;有跨机房容灾与在线扩缩需求的中大型业务。
不适用: 只需要一个轻量嵌入式/单机数据库的小项目(YDB 部署与运维偏重);团队强依赖 PostgreSQL 生态扩展与成熟托管服务、且没有跨 DC 强一致刚需者;需要大量第三方托管 SaaS、不愿自运维分布式存储的初创。
七、客观分析:优势与局限
优势:
- 真正的统一栈:行存+列存+Topics+CDC+联邦查询在一个事务模型里,避免了业务库与数仓之间的大量数据搬运;
- 计算存储独立扩缩:Tablet 分片 + PDisk 块存储的分层,让扩缩容与故障恢复自动化程度高;
- 强一致是默认值:可串行化全局事务,不用在应用层处理一致性异常;
- AI 时代补位快:原生向量索引 + MCP Server,直接面向 RAG/语义检索场景。
局限(官方自认或隐含):
- 生态与社区偏俄语区:虽然文档有英文版,但项目源自 Yandex,国际社区案例、中文资料与第三方托管服务相对稀少;
- 性能数字不透明:缺乏中立、可复现的横向 benchmark,“快”更多是主张;
- 运维门槛不低:DSProxy/VDisk/PDisk/Tablet 这套抽象比单 RDBMS 复杂得多,自运维需要专门学习;
- 部分能力仍标 Upcoming:如 Topic-to-Table 自动 ingestion、内置 AI Assistant 在官网仍标注”Upcoming”,不是全部 GA;
- 地缘与合规不确定性:俄罗斯背景项目在某些企业的供应链合规审查中可能被额外审视。
八、它意味着什么 / 谁该关注
YDB 的价值不在于”又一个 NewSQL”,而在于它把”事务 + 分析 + 流 + 向量”收敛进一个强一致内核的尝试,且这个内核是在 Yandex 自家真实流量下磨出来的。对正在评估分布式数据库、尤其想避免”业务库 + 数仓 + 消息队列”三套系统拼接的团队,YDB 值得放进候选清单做 PoC;但要接受它运维复杂、国际生态尚浅、性能需自测的现实,不能只凭官方量级描述下生产决策。