Walrus:一个用 Rust 从零写起的分布式日志流引擎,真能替代 Kafka 吗
阅读时间: 大约 14 分钟
Walrus:一个用 Rust 从零写起的分布式日志流引擎,真能替代 Kafka 吗
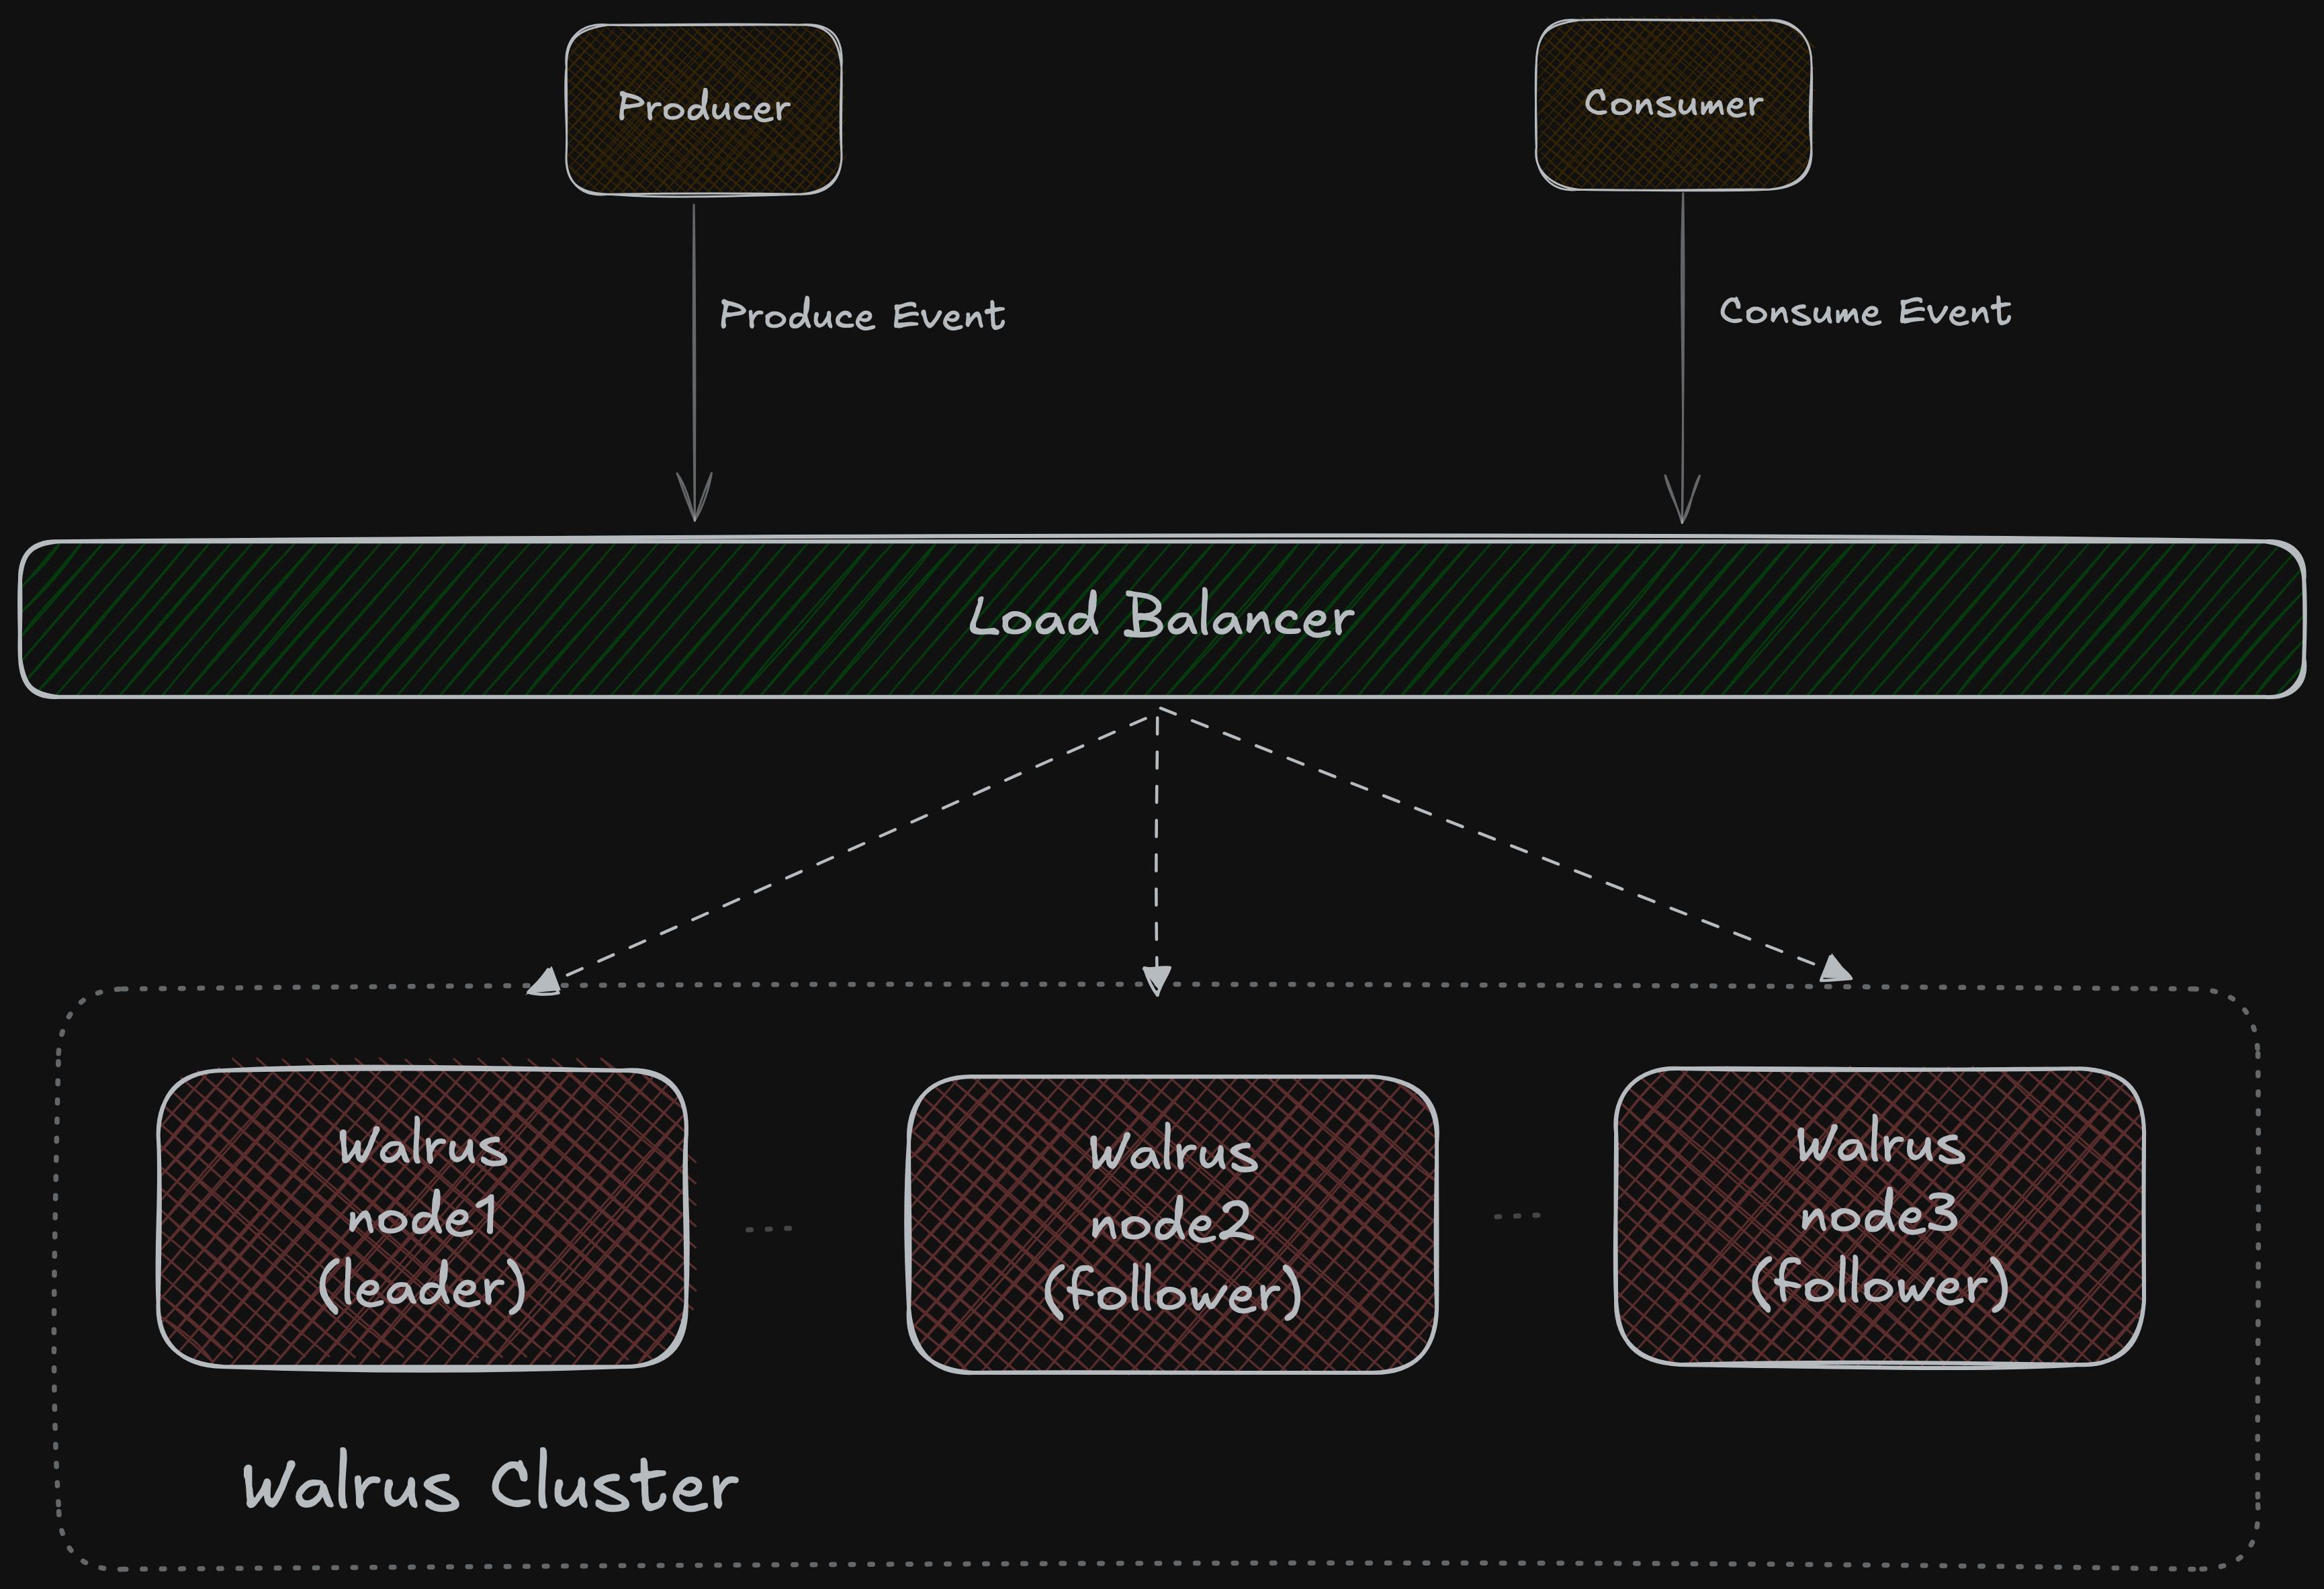
Walrus 是开发者 nubskr 用 Rust 从零实现的分布式日志流(log streaming)引擎,仓库自我定位为 “Distributed log streaming engine built from first principles”(从头构建的分布式日志流引擎),Topics 里直接挂了 apache-kafka、kafka、redpanda、nats,意图很明显:在 Kafka 的地盘上找位置。项目采用 MIT 协议,v0.2.0 发布于 2025 年 10 月 20 日(v0.1.0 约在三周前),截至调研时约 1.9k star、74 fork。本文不采信周报里”160 万写入每秒”的转述,而是回到官方 README 与发布博客,核验它的架构机制、基准口径与真实成熟度。
一、背景动机:为什么要重造一个日志流引擎
Kafka 的优势是生态(工具链、运维经验、 exactly-once、多租户、流处理),代价是 JVM 堆、页缓存与较重的部署模型。近两年 Redpanda 用 C++ 去掉 JVM、NATS 用 Go 走轻量路线,证明”换语言重写存储层”仍有市场空间。Walrus 的选择是 Rust + Linux io_uring,目标是把单机存储引擎的写吞吐做到极致,再在其上叠加一套轻量分布式协调。需要先说明:它当前更像一个”高性能日志原语 + 一个分布式参考实现”,而不是 Kafka 的完整对等替代。
二、概念定位:Raft 只管元数据,数据走 segment 租约
Walrus 的一个关键设计取舍是把 Raft 用在元数据上,而不是数据上:
- Raft Engine(内部代号 Octopii):仅对元数据变更做共识(leader 选举、日志复制、AppendEntries RPC),维护
topic → segment → leader映射、已封存 segment 及其条目数、节点地址。数据本身不经过 Raft 复制。 - Segment 分片:topic 被切成 segment,默认每个 segment 约 100 万条(
WALRUS_MAX_SEGMENT_ENTRIES=1000000),每个 segment 有一个 leader 节点负责写入。 - 轮转选主(leadership rotation):segment 写满 rollover 时,leader 按 round-robin 轮换到下一个节点,借此把负载自动摊到集群,而不是把所有写压在一个全局 leader 上。
- 租约写围栏(lease-based write fencing):只有持有该 segment 租约的 leader 能写,租约从 Raft 复制的元数据每 100ms 同步一次,防止换主期间脑裂双写。
- 封存 segment 读:旧 segment rollover 后”封存”为不可变,原 leader 保留其数据,任何持有该数据的副本都可服务读,rollover 时不需要搬数据。
集群示意图里 node2/node3 标注为 follower,容易误读成”数据三副本 Raft 复制”,官方原文明确 Raft “for metadata changes only (not data!)”,这一点必须区分。
三、技术机制:单节点存储引擎 + io_uring 批量写
3.1 节点内部四个组件
每个节点由四部分组成:Node Controller(路由客户端请求到对应 segment leader、管理写租约、跟踪逻辑偏移以判断 rollover、必要时转发给远端 leader)、Raft Engine(元数据共识)、Cluster Metadata(Raft 状态机,全节点一致复制)、Bucket Storage(带租约写围栏的 Walrus 引擎,实际数据落盘为 WAL 文件,可服务封存或活跃 segment 的读)。
3.2 FD 后端与 io_uring 原子批写(v0.2.0)
v0.2.0 放弃了 v0.1 被社区反馈”脆弱”的 mmap 默认后端,改用文件描述符(FD)后端,并在 Linux 上用 io_uring 把多次操作合并进单次系统调用:
batch_append_for_topic一次最多原子写 2000 条,成功则全写、失败则一条不落(offset 只在整批刷盘成功后前进,回滚时清零元数据前缀并恢复 writer offset,崩溃后恢复逻辑跳过零头);batch_read_for_topic按提交序返回,受调用方字节上限与 2000 条上限约束,单批最高读 10GB;- fsync 策略分
FsyncSchedule::SyncEach(O_SYNC,每条落盘)与NoFsync(依赖页缓存); - 非 Linux 或 mmap 后端时退化为顺序 mmap 写,官方称正确性不变、慢约 5–10 倍,且 mmap 后端计划逐步淘汰,未来优先 Linux。
发布博客给出的作者自测:单线程约 400MB/s 写带宽,7 线程打满系统带宽;批量读约 100–500 微秒,对比传统 pread() 的 2–10 毫秒。这些是作者本机口径,非第三方复测。
3.3 极简客户端协议
客户端用 TCP 上的长度前缀文本协议(4 字节小端长度 + UTF-8 命令):REGISTER 建 topic、PUT 追加、GET 读下一条(共享游标)、STATE 查元数据、METRICS 查 Raft 指标;响应只有 OK/EMPTY/ERR。可连任意节点,由集群自动转发到 leader。
四、关键数据:官方基准与必须标注的口径
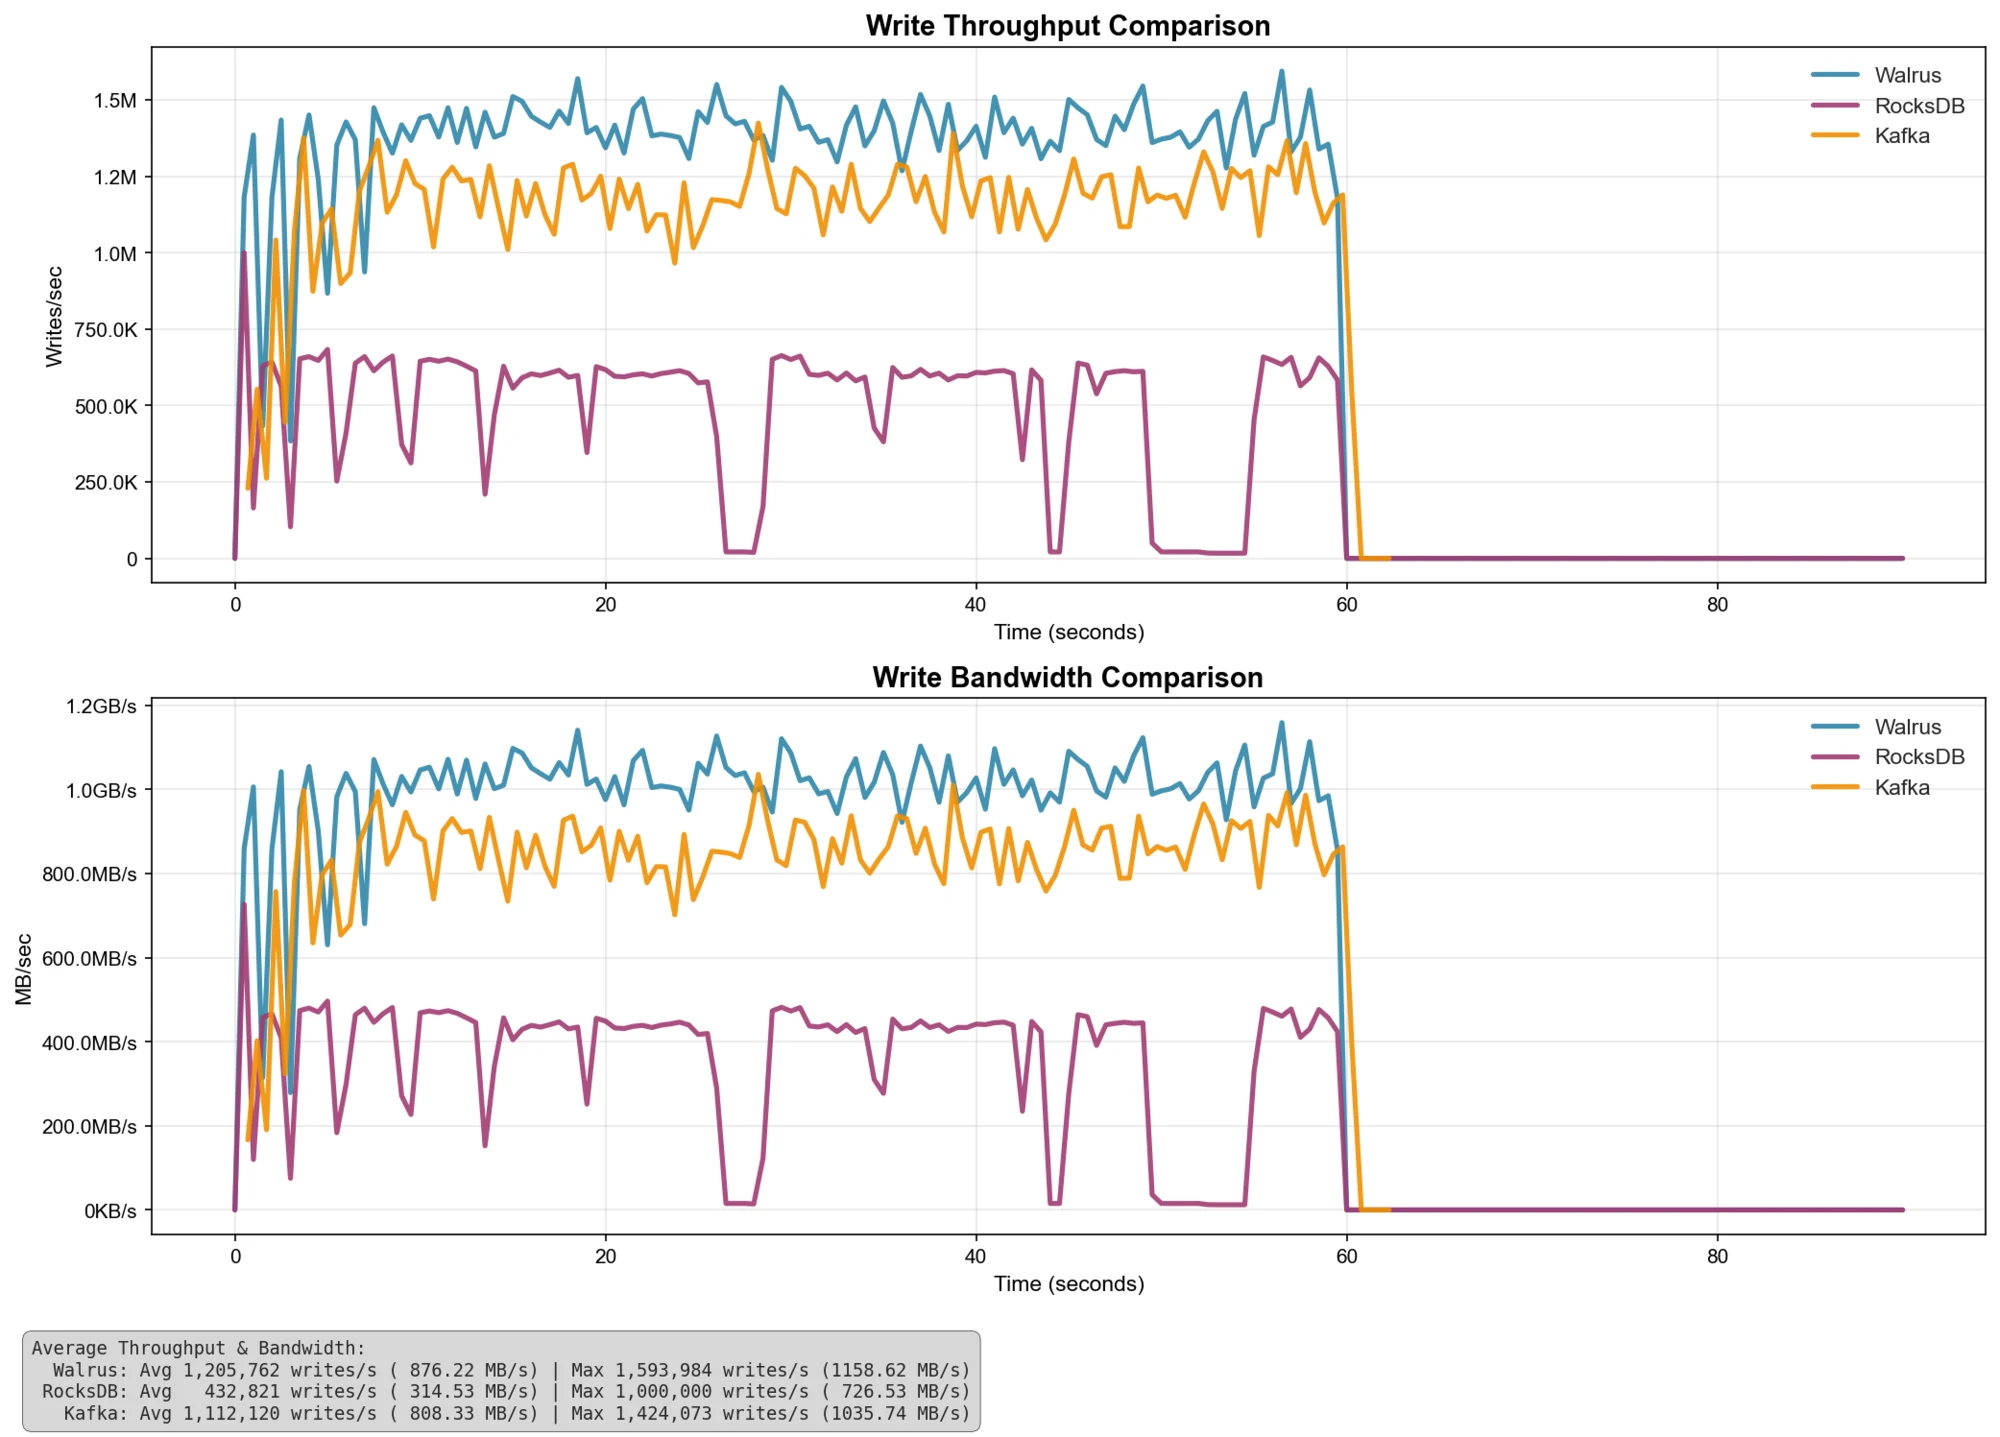
4.1 关闭 fsync 的存储引擎对比(官方自测)
| 系统 | 平均写吞吐(条/秒) | 平均带宽(MB/s) | 峰值写吞吐(条/秒) | 峰值带宽(MB/s) |
|---|---|---|---|---|
| Walrus | 1,205,762 | 876.22 | 1,593,984 | 1,158.62 |
| Kafka | 1,112,120 | 808.33 | 1,424,073 | 1,035.74 |
| RocksDB | 432,821 | 314.53 | 1,000,000 | 726.53 |
周报里”160 万写入每秒”对应的是 Walrus 的峰值 1,593,984 条/秒,不是稳定均值(均值约 120 万)。
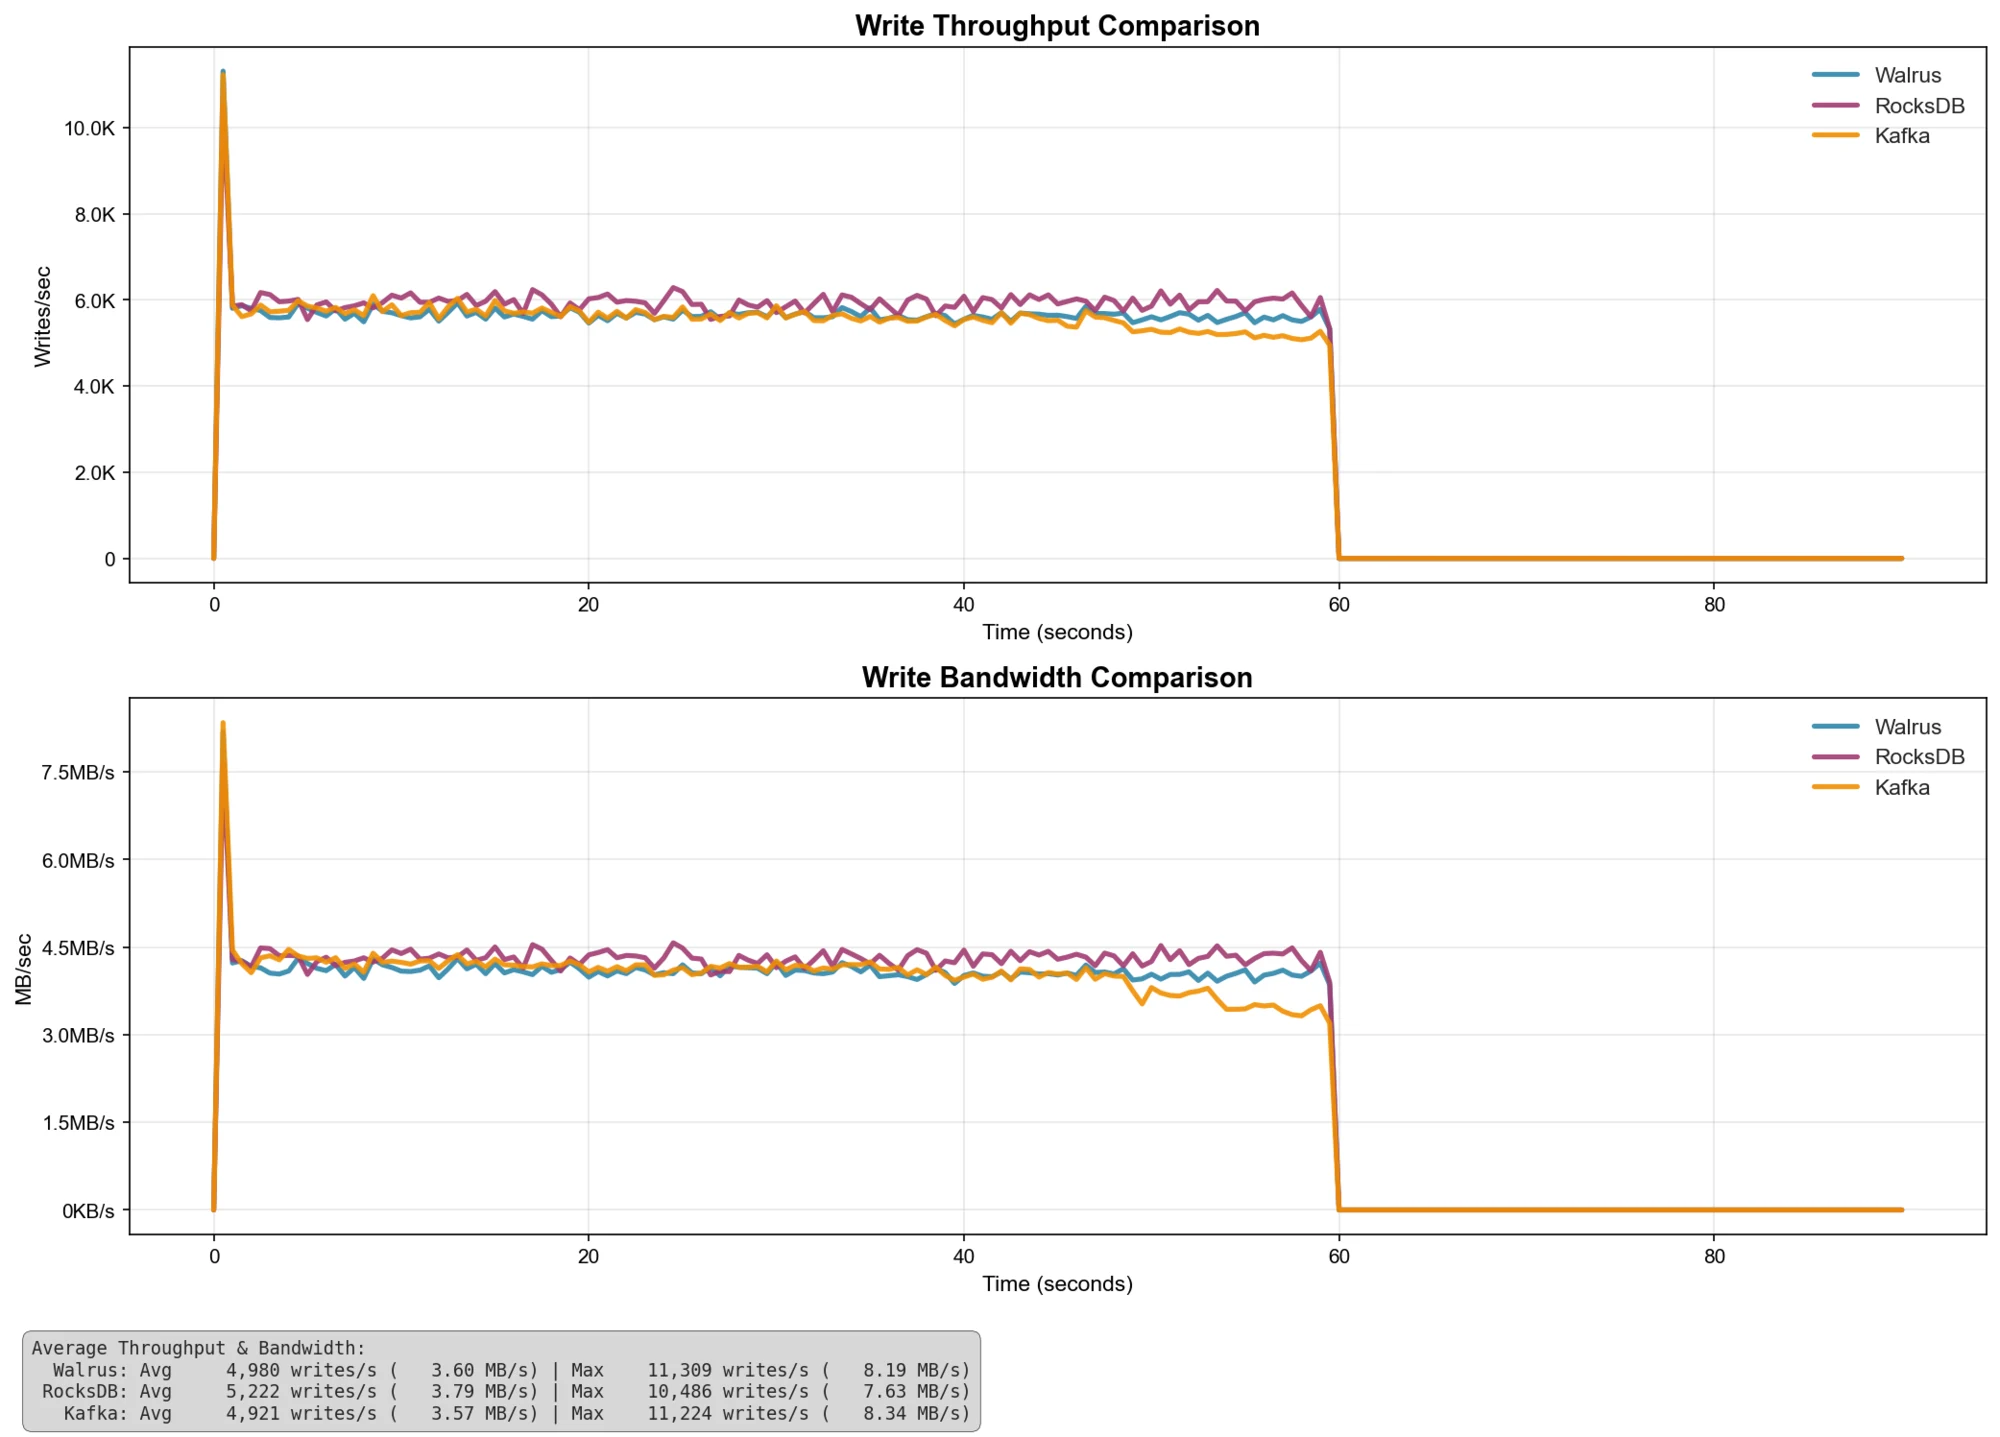
4.2 开启 fsync(每条刷盘)的对比
| 系统 | 平均写吞吐(条/秒) | 平均带宽(MB/s) | 峰值写吞吐(条/秒) |
|---|---|---|---|
| RocksDB | 5,222 | 3.79 | 10,486 |
| Walrus | 4,980 | 3.60 | 11,389 |
| Kafka | 4,921 | 3.57 | 11,224 |
五、评测方法批判:这份基准不能当成”打赢 Kafka”
官方在 README 自己写明了测试边界,读结论时必须带上:
- 这是单节点存储引擎微基准,不是分布式集群对决:对比对象是**单个 Kafka broker(无复制、无网络开销)**与 RocksDB 的 WAL;Walrus 侧也是底层存储引擎的
append_for_topic()端点,没有把 Raft 元数据开销、网络复制、多节点故障切换纳入。 - 对照组不完全对等:RocksDB 走的是遗留
append_for_topic()的pwrite()系统调用、未做 io_uring 批处理,属于较弱的调用方式;Kafka 单 broker 也未开复制。 - 关 fsync 的 160 万条/秒是”内存级”数字:数据依赖页缓存,掉电即失;一旦开 fsync(每条落盘),三者全部回落到约 5K 条/秒量级,且平均吞吐上 RocksDB(5,222)还略高于 Walrus(4,980),差异在噪声范围内——** durability 场景下 Walrus 并没有明显领先**。
- 无第三方复测、无统一硬件说明:线程数、盘型(NVMe/SSD)、消息大小、测试时长都以作者环境为准,博客里的”7 线程打满带宽”同样是本机结论。
- TLA+ 模型验证的是协议属性,不是生产正确性:项目用 TLA+ 规范 + TLC 模型检验了单写者、封存计数稳定、游标不越界、顺序写、rollover/读进展等安全与活性属性,并把 Raft 抽象为单一权威元数据源;这保证了规约层面的不变量,但不等于实现无 bug 或经过大规模压力验证。
六、适用与不适用场景
适合:
- 把 Walrus 当作嵌入式 Rust 日志原语库(
walrus-rust0.2.0,可作事件日志、数据库 WAL、消息队列、KV、任务队列,按 key 做命名空间隔离,分别配StrictlyAtOnce/AtLeastOnce{persist_every}与 fsync 策略); - Linux 环境、追求单机极致写吞吐、能接受无 fsync 高性能档位的突发流水线;
- 想研究 Raft 元数据 + segment 轮转这种轻量分布式设计的学习者。
不适合:
- 需要 Kafka 现成生态(Schema Registry、Connect、KStreams、多租户 ACL、跨机房、成熟运维)的生产关键系统;
- 要求强持久化/每条 fsync 的账务类写入(此档位无领先优势);
- 需要 exactly-once 语义、完整消费者组重平衡、事务消息的团队(README 的
GET是共享游标,未见消费者组协议); - 非 Linux 平台(io_uring 优势消失,退化为慢 5–10 倍的 mmap)。
七、客观分析:优势与局限
优势:
- 架构取舍清晰:Raft 只压元数据、数据靠 segment 租约与轮转摊负载,避免了每条数据都走 Raft 复制的开销;
- io_uring 原子批写在关 fsync 档位确实快,单线程高带宽、线程少而吞吐高,存储层设计有想法;
- TLA+ 规约验证 + 完整测试套件,在个人项目里少见,协议安全性有形式化背书;
- 双形态交付:分布式服务 + 可嵌入 crate,灵活性高;MIT 协议友好。
局限:
- 成熟度低(v0.2.0):个人项目,issue/PR 仍在早期,无大规模生产案例,周报自己也提醒”自称 kafka alternative 容易,真正替代要生产验证”;
- 分布式能力单薄:未见数据多副本持久化复制、消费者组、 Exactly-Once、跨 region、压缩与留存策略;
- 基准口径窄:160 万是单节点关 fsync 峰值,开 fsync 后与竞品持平甚至略低;
- 生态空白:无官方客户端多语言 SDK、无运维监控体系、无社区工具链,Kafka 的迁移成本主要在这里而非性能;
- 平台绑定 Linux,mmap 后端将淘汰,跨平台能力收缩。
八、它意味着什么
Walrus 的价值更接近一份”用 Rust + io_uring 重做高性能日志层”的高质量参考实现,而不是今天就能替换 Kafka 的生产方案。它证明了在单机存储引擎层面用批写和 io_uring 可以把无持久化吞吐推到百万级,但一旦回到 durability 与分布式生态,差距仍然明显。值得关注、值得读源码学习,但把它放进关键业务流之前,应等待多副本、消费者组与第三方压测出现。