Vegeta:以恒定速率施压的 Go HTTP 压测工具
阅读时间: 大约 11 分钟
Vegeta:以恒定速率施压的 Go HTTP 压测工具
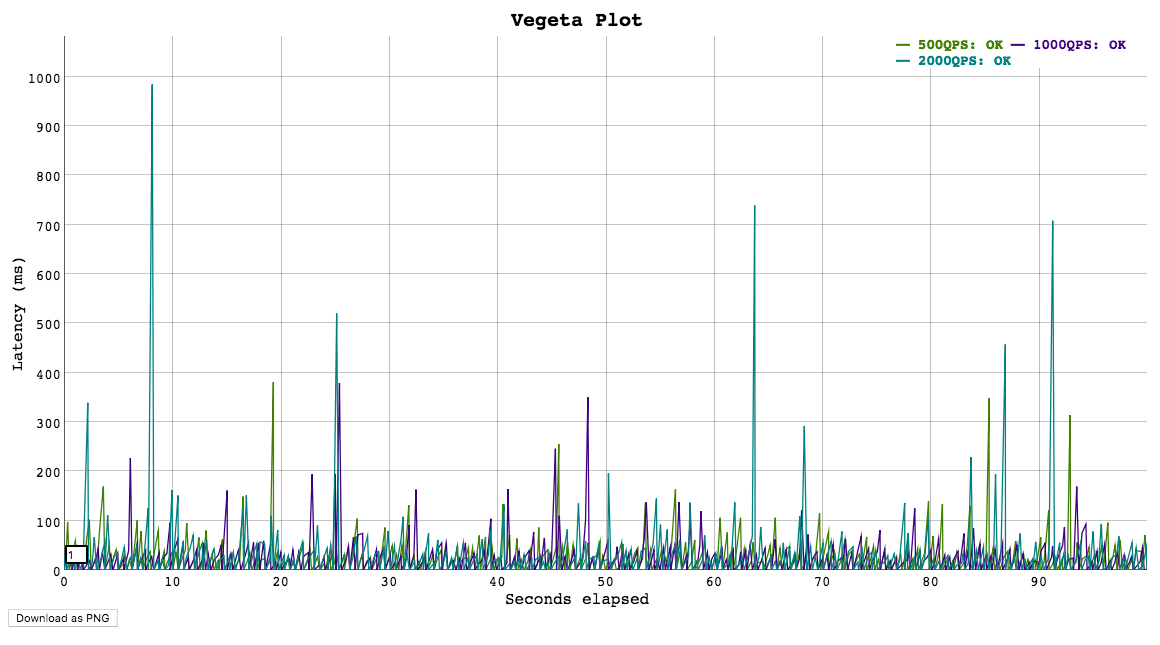
Vegeta 是 Tomás Senart(GitHub ID tsenart)用 Go 编写的 HTTP 负载测试工具,官方自我定位很简短:“a versatile HTTP load testing tool built out of a need to drill HTTP services with a constant request rate”,口号是玩《龙珠》梗的 “It’s over 9000!”。它既能当命令行工具用,也能作为 Go 库嵌入程序,以 MIT 协议发布。与很多压测工具”固定并发数”的思路不同,Vegeta 的设计核心是恒定请求速率(constant request rate)。
一、为什么需要它
压测的目的是回答”这个服务在 N 每秒请求下表现如何”。但”怎么施加这 N 每秒”本身就有讲究:很多工具(如早期的 ab)用固定并发连接数——你开 100 个连接打完一个再打下一个。问题在于,一旦服务端变慢,这 100 个连接自然就发得慢了,施加的压力会随服务端退化自动下降,于是你测出来的延迟曲线”看起来很稳”,实际上是压力自己泄了。这就是性能工程里常说的 Coordinated Omission(协同遗漏)。Vegeta 存在的一个核心理由,就是正面处理这个问题。
二、它是什么
Vegeta 是一个”施压 + 记录 + 出报告”的三段式工具,遵循 UNIX 管道哲学:
attack:按指定速率和时长向目标发请求,把每条请求结果以二进制(gob)写到 stdout;report:读取结果,输出 text/json/hist/hdrplot 等报表;plot:把结果画成 HTML 时序图;encode:在 gob/json/csv 之间转换结果,便于用jq二次处理。
典型用法是一条管道:echo "GET http://localhost/" | vegeta attack -duration=5s | tee results.bin | vegeta report。它不是一个带 GUI 的全流程压测平台,而是一个可被脚本编排的、可组合的施压原语。
三、技术机制
速率模型:-rate 指定每秒请求数(默认 50/s),-duration 指定时长。Vegeta 内部用 worker(goroutine)池来维持这个速率——初始 -workers=10,如果发现追不上目标速率会自动增加 worker,直到 -max-workers 上限。关键是:它主动加人来保速率,而不是固定人手等服务端。这正是它宣称”避免 Coordinated Omission”的实现方式——即使服务端延迟升高,Vegeta 仍按约定的到达速率把请求砸过去,从而真实暴露排队和退化。
-rate=0(或 infinity)则反过来:不限制速率,能发多快发多快;此时配合 -max-workers 可以建模”固定数量的并发用户、各自串行发请求”的场景。官方特别警告:把 -max-workers 设得极大同时 -rate=0,可能耗尽本机资源甚至崩溃。

结果与口径:每条结果记录时间戳、状态码、延迟、进出字节数、错误。report -type=text 的 Success 口径是——请求未出错且状态码在 **200 到 400(不含 400)**之间;状态码为 0 表示请求根本没发出去。延迟统计给出 min/mean/p50/p95/p99/max,官方 README 专门引用 percentiles 文章解释为什么要看分位数而不是只看平均值。
四、关键数据与口径
下表是从官方 usage manual 可直接核对的默认值与行为:
| 项目 | 官方口径 |
|---|---|
| 默认请求速率 | 50/s;0 表示尽可能快 |
| 默认请求超时 | 30s |
| 每目标主机最大空闲连接 | 10000 |
| 初始 worker 数 | 10(按需自动扩容至 -max-workers) |
| 默认跟随重定向次数 | 10(-1 = 不跟随但记为成功) |
| Success 判定 | 无错误且 200 ≤ 状态码 < 400 |
| 报告类型 | text / json / hist[buckets] / hdrplot |
| plot 降采样阈值 | 默认 4000 个数据点以上才降采样 |
| 库导入路径 | github.com/tsenart/vegeta/v12/lib |
| 版本策略 | SemVer v2;自 lib/v9.0.0 起库与 CLI 分别版本化 |
五、评测方法批判
Vegeta 的数字”好看”并不等于你的服务能扛住,要批判性地看它的输出:
- 恒定速率 ≠ 真实用户行为。真实用户是” think time + 突发”的混合体,Vegeta 默认是平滑泊松/恒定到达,需要你自己用动态 targets(配合
-lazy和jq流式生成)才能模拟抖动。 - 它测的是”施压客户端能发多少”,不是”服务端最多能扛多少”。README 明确写了存在一个受机器限制的速率上限:你可能先撞到 CPU(不太可能)、内存(更可能),或系统资源上限——主要是文件描述符数和进程/线程数。官方给出的排查命令是
ulimit -n(默认可能只有 2560)和ulimit -u。也就是说,压不上去时先怀疑是不是 Vegeta 自己被 ulimit 卡死了,而不是服务端到顶了。 - 延迟尖刺不一定是服务端问题:本机 GC、调度、网络抖动都会出现在同一根曲线上(如上图中 8 秒、62 秒、88 秒处的尖刺),要结合客户端资源一起看。
六、适用 / 不适用场景
适合:对 HTTP API 做基线压测、容量规划、回归对比(同一套 targets 跑两个版本对比 p99);作为 Go 库嵌入自动化压测脚本;多机分布式施压(README 示例:3 台机各跑 20000/s 凑 60000/s,再把各自的 bin 回收汇总 report);需要把指标接到 Prometheus/Grafana 的持续监控。
不适合:需要复杂业务场景链路(登录态、依赖服务 mock、缓存预热)的端到端压测——Vegeta 只管发 HTTP 请求,业务编排得你自己搭;需要在压测机上跑图形化报告的新手——它是管道工具,不是 SaaS 压测平台;目标是测”极端并发连接数下的连接处理”而非”恒定到达速率”时,要用对 -rate=0 + -max-workers 模型并清楚两者差异。
七、优势与局限
优势:单静态二进制、跨平台安装方便(brew/pacman/pkg/预编译包);UNIX 管道组合性极强;报告口径规范(分位数、Success 定义清晰);原生支持分布式和 Prometheus 导出;既给 CLI 也给 Go 库。
官方自认的局限(nuance):
- 施压速率有本机上限:CPU/内存/文件描述符/进程数都会先到瓶颈,高 QPS 场景必须先调
ulimit,否则瓶颈在压测机而不在被测服务。 - Prometheus 集成是”半成品”:官方自己列了三条限制——(a) Prometheus 用抓取时间打时间戳,不是请求真实发生时间,结果时间戳不准;(b) 配置抓取要带外做,很麻烦;(c) attack 进程可能在 Prometheus 抓到最后一批数据前就退出了。官方解释了为何不用 pushgateway,并说明正经解法(remote write)还在 issue 里跟踪。
-rate=0+ 超大-max-workers有风险:可能吃光本机资源崩溃,官方明确”Use with care”。- 超时与重定向口径要留心:默认跟 10 次重定向,若你的服务会 301 循环,报告里的”成功”可能被污染;
-redirects=-1时不跟随但记成功,需要按场景选。
八、它意味着什么
Vegeta 在开源压测工具里的位置,类似于”压测界的 Unix 哲学派”:它不试图当一个大而全的平台,而是把”按恒定速率发请求、把原始结果落盘、再由你自由组装报表”做到极致,并在设计上正面避开 Coordinated Omission 这个经典陷阱。对要做容量规划和版本回归的工程师,它是一个可信、可脚本化的施压原语;但它给的是锤,不是鉴定结论——压出来的数字好不好,一半取决于你有没有先把压测机自己的 ulimit、网络和 GC 调好。