TOON:为大模型省 Token 的数据格式,表格型数据比 JSON 省三到六成
阅读时间: 大约 10 分钟
TOON:为大模型省 Token 的数据格式,表格型数据比 JSON 省三到六成
把结构化数据塞进大模型上下文时,JSON 的相当一部分 token 其实花在了”括号、引号、重复的字段名”这些结构本身。TOON(Token-Oriented Object Notation,面向 token 的对象表示法)就是冲着这件事来的:它是 JSON 数据模型的一种紧凑、人类可读的编码,用 YAML 式缩进表达嵌套、用 CSV 式表格表达同构对象,目标是在不损失可读性与解析准确率的前提下,把送给 LLM 的 token 量砍下来。本文依据其官方 README 与公开基准数据做分析。
一、它解决什么问题
LLM 的 token 是真金白银:上下文越长、调用越频繁,成本越高。而 JSON 为了通用性,在表格型数据上要为每一行重复写一遍字段名与括号引号。TOON 的定位是”翻译层”——程序内部照旧用 JSON,送给 LLM 前编码成 TOON,一个无损的、面向 LLM 的 JSON 表示。它尤其适合序列化 AI Agent 的工具调用返回结果:结构化、行数固定、字段统一。
二、长什么样:一个天气预报的例子
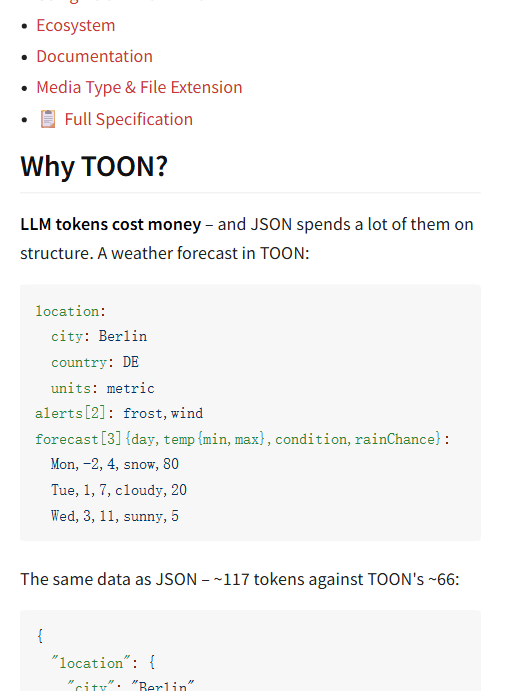
官方 README 给出的天气数据,JSON 约 117 token,TOON 约 66 token(省约 43.6%)。TOON 一侧是这样的:
location:
  city: Berlin
  country: DE
  units: metric
alerts[2]: frost,wind
forecast[3]{day,temp{min,max},condition,rainChance}:
  Mon,-2,4,snow,80
  Tue,1,7,cloudy,20
  Wed,3,11,sunny,5
这里同时出现了 TOON 的三种语法手段:alerts[2]: frost,wind 是内联形态;forecast[3]{...}: 是表格形态——字段清单在表头声明一次,之后每行一条记录;temp{min,max} 是嵌套字段组,把同构嵌套对象折进表头、行内保持扁平。第四种是给非同构数据兜底的列表形态(每行一个 -)。
对 LLM 友好的关键设计是护栏:[N] 显式声明行数、{fields} 声明列宽,这样模型一旦输出被截断或多/少行,结构上立刻可校验,而不是像裸 JSON 那样静默崩坏。官方基准里专门构造了”数组末尾少 3 行""超出声明长度多出行""第 10 行缺 salary 字段”这类结构破坏用例,就是为了验证这套护栏能否让模型把错误暴露在结构层而不是悄悄编造成看似合理的数据里。
三、基准数据:官方怎么测的
官方基准覆盖 244 道检索题 × 6 种格式 × 4 个模型 = 5,856 次 LLM 调用。被测模型为 claude-haiku-4-5、gemini-3.6-flash、gpt-5.4-nano、grok-4.5;token 计数用 gpt-tokenizer 的 o200k_base(即 GPT-5 tokenizer)。
效率总榜(每 1K token 换来的准确率)
| 格式 | 准确率/token 效率 | 准确率 | 消耗 token |
|---|---|---|---|
| TOON | 29.2 | 72.2% ±2.8 | 2,474 |
| JSON compact | 23.8 | 69.0% ±2.9 | 2,892 |
| YAML | 20.1 | 70.1% ±2.9 | 3,487 |
| JSON | 16.6 | 71.4% ±2.8 | 4,308 |
| XML | 14.4 | 70.7% ±2.9 | 4,909 |
官方结论:TOON 以 72.2% 准确率(略高于漂亮打印 JSON 的 71.4%),同时少用 42.6% 的 token。换句话说,省 token 的同时准确率没有下降,反而略升。
分场景的 token 节省(相对漂亮打印 JSON)
| 数据集 | 同构度 | TOON vs JSON | TOON vs compact JSON |
|---|---|---|---|
| 联系人(嵌套地址/套餐组) | 100% 表格 | −66.5% | −42.9% |
| 按名索引的功能开关 | 100% 表格 | −54.6% | −32.8% |
| 员工记录(扁平) | 100% 表格 | −60.7% | −36.8% |
| 时间序列分析 | 100% 表格 | −59.0% | −35.9% |
| 电商订单(嵌套) | 33% 表格 | −32.9% | +5.6%(略费) |
| 深嵌套配置 | 0% 表格 | −34.9% | +6.7%(略费) |
这张表讲得很清楚:同构表格型数据是 TOON 的甜区,能省三到六成;而一旦数据深嵌套、字段不齐,TOON 相对 compact JSON 反而可能略多费 token(电商订单 +5.6%、深嵌套配置 +6.7%)。官方自己也承认:“对于深嵌套或非同构数据,JSON 可能更高效。”
四、评测方法本身的偏向(必须一起看)
- token 计数绑定 GPT-5 tokenizer:官方明确说绝对 token 数是 tokenizer 相关的,换别的厂商分词器绝对值会变,只有”格式间相对差异”在方向上成立;
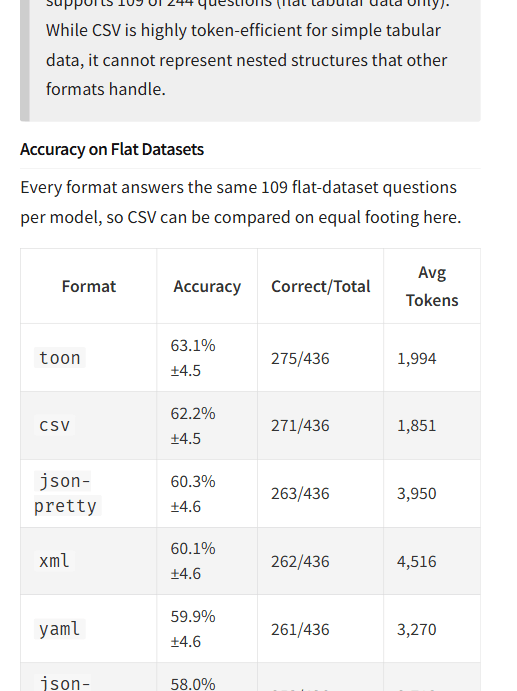
- CSV 被排除在总榜外:CSV 只能答 244 题里的 109 题(纯扁平表格),不能表达嵌套,所以总榜不与 CSV 并列——在纯扁平场景 TOON 比 CSV 只多约 5.9% token,但换来表达嵌套的能力;
- 准确率差距在误差带内:TOON 72.2% vs JSON 71.4% 的差距,落在 ±2.8–2.9% 的置信区间里,“准确率更高”应理解为”持平”,真正稳健的结论是用更少 token 达到同等准确率;
- 模型选择影响结论:测的是 haiku/flash/nano 这类轻量模型,在更强模型上格式差异可能被抹平。
五、客观分析:优势与局限
优势:
- 表格型数据省 token 扎实:同构记录省三到六成,Agent 工具返回、日志、配置这类结构化数据收益明显;
- 准确率不降反略升:护栏式
[N]/{fields}帮助 LLM 校验结构,少用 token 还不丢分; - 无损、JSON 数据模型:程序里照旧用 JSON,编码成 TOON 只是送给 LLM 的表示,往返确定;
- 多语言生态:官方 TypeScript SDK + CLI,加社区移植,共享同一套一致性测试。
局限:
- 不是万能格式:深嵌套、非同构数据上它相对 compact JSON 反而略费 token,官方自己划定了边界;
- 省的是 token 不是人写的:它是给 LLM 读的,人直接编辑 TOON 的体验不如 JSON 工具链成熟;
- 绝对节省依赖 tokenizer:换分词器数字会变,42.6% 是 GPT-5 tokenizer 口径;
- 生态年轻:SPEC 还在迭代(当前 v4.4),属于值得跟踪但尚未成为标准的格式。
六、谁该用它
- 写 AI Agent / 工具调用的人:把结构化工具返回结果编码成 TOON 再喂给模型,是最直接的省钱场景;
- 长上下文应用的作者:日志、记录集、配置这类同构表格数据,值得在 prompt 前加一道 TOON 编码;
- 数据高度不规则/深嵌套的项目:先别上 TOON,在你的真实数据上量一下相对 compact JSON 的差值再决定。