TokenDagger:把 OpenAI tiktoken 替换掉的高性能 tokenizer
阅读时间: 大约 9 分钟
TokenDagger:把 OpenAI tiktoken 替换掉的高性能 tokenizer
做大规模文本处理——喂数据、统计上下文长度、批量预处理——第一道坎往往是 tokenizer。OpenAI 的 tiktoken 已经足够快,但当你要处理 TB 级语料时,tokenize 本身会变成 CPU 瓶颈。M4THYOU 开源的 TokenDagger(MIT,Python 包 tokendagger,Python 3.8+)就是冲着这个来的:一个与 tiktoken 完全兼容的高性能实现,官方称通用文本吞吐约为 tiktoken 的 2 倍,在代码样本上快到 4.02 倍。本文基于其官方仓库与 benchmark 图做分析。
一、背景:为什么 tokenize 也会成瓶颈
tiktoken 用 Rust 写、已经是工程上相当快的 BPE 实现。但它在 Python 侧仍有开销:正则切分(GPT 系列用正则把文本先切成合法片段)、BPE 合并、以及特殊 token 词表的查表。当你做数据清洗、长文档批处理、离线 embedding 流水线时,成千上万次 tokenize 累加起来,CPU 时间就不容忽视。TokenDagger 的目标是「同样的结果,更少的时间」。
二、是什么:drop-in 替换
它主打「无缝替换」——你不需要改业务逻辑:
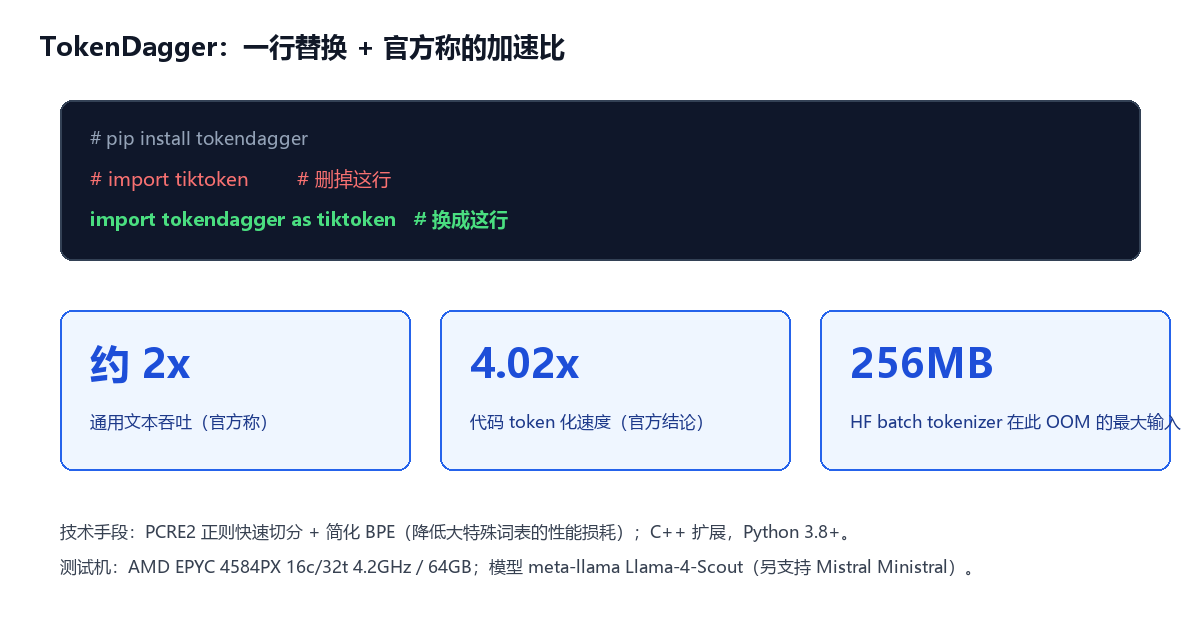
原来 import tiktoken,改成 import tokendagger as tiktoken,后面的 Encoding(...) 调用方式保持不变。这种兼容性是关键卖点:存量代码迁移成本几乎为零。
三、为什么快:两个工程手段
官方给出的提速来源有二:
- PCRE2 正则快速切分:tokenize 的第一步是用一个正则把文本切成「允许合并的片段」。TokenDagger 换成优化过的 PCRE2 引擎来做这一步,减少模式匹配开销(依赖里明确要求
libpcre2-dev)。 - Simplified BPE(简化 BPE):大模型的特殊 token 词表(special tokens)很大,传统实现里这部分的处理有性能损耗;TokenDagger 用一个简化算法降低其影响。
底层是 C++ 扩展(仓库里有 extern 子模块),不是纯 Python 脚本,这也是它能压过 tiktoken 的前提。
要理解这两步的分量,可以回忆一下 BPE tokenize 的完整流水线:先拿一个正则(如 GPT-4 的 ' ?\S+' 之类)把整段文本切成若干「片段」,再在每个片段上做字节对合并(BPE merge),最后映射成 token id。正则切分看似小事,但对几十万篇文档反复跑,CPU 时间非常可观;而特殊 token(如 <|endoftext|>、对话模板里的各种控制符)如果每次都走完整词表匹配,在大词表下也会有额外开销。TokenDagger 正是在这两个「不起眼」的环节下刀,而不是去改 BPE 的核心合并逻辑——这也解释了为什么它能保持结果兼容:算法语义没变,只是执行得更快。
部署上要注意:开发安装需要 libpcre2-dev、Python 开发头文件,并 git submodule update 拉取 C++ 子模块后编译;普通用户直接 pip install tokendagger 即可拿到预编译 wheel,但如果你的目标机器是冷门架构或极老的 glibc,可能仍然要现场编译。官方测试脚本同时提供了 llama 和 mistral 两套 tokenizer 的对照,方便你在自己的数据上复现,而不是只信 README 上的倍数。
四、关键数据(官方自测)
| 指标 | 官方口径 |
|---|---|
| 通用吞吐 | 约为 tiktoken 的 2 倍 |
| 代码 token 化 | 4.02 倍(官方测试结论) |
| 测试机 | AMD EPYC 4584PX,16c/32t,4.2GHz,64GB 内存 |
| 测试模型 | meta-llama/Llama-4-Scout-17B-16E-Instruct(另支持 Mistral Ministral) |
| 对比项 | tiktoken、Hugging Face batch tokenizer |
| 内存 | HF batch tokenizer 内存占用更高,256MB 已是其不 OOM 的最大输入 |
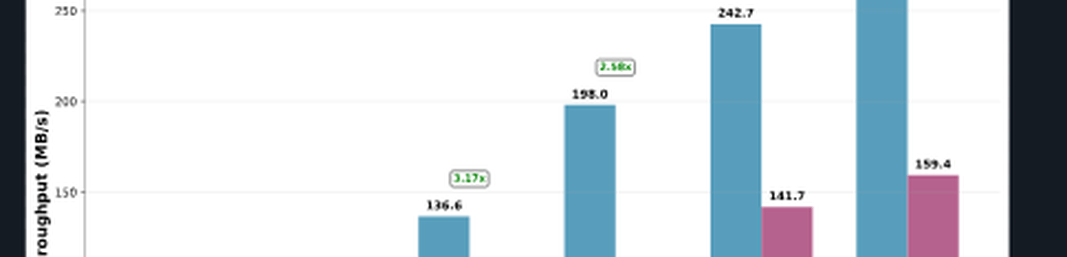
从官方吞吐图也能看出趋势:随着输入文本增大,TokenDagger(蓝)与 tiktoken(紫)的吞吐都在上升,但蓝柱始终显著更高;小输入时差距可达 3 倍以上,大输入时倍数收窄到约 1.6–1.7 倍。
五、评测方法批判:这些数字要怎么打折看
这是本文不做软文的部分。
- 全部是作者自测:2x / 4.02x 都是在作者自己的 EPYC 机器上、用指定的 Llama tokenizer 跑出来的,没有第三方独立复现。换 CPU、换 tokenizer 词表、换文本分布,倍数都会变。
- 代码 4 倍是特定样本:
code_performance_benchmark.py用的是作者挑的代码样本,不代表你仓库里代码的分布。 - 大输入倍数收窄:图上大输入时优势从 3 倍掉到约 1.6 倍,说明「4 倍」是最优工况的宣传值,稳态收益更接近 1.6–2 倍。
- 「HF 256MB 就 OOM」是对比抹黑式陈述:它比较的是 HF batch tokenizer 这个特定实现的内存行为,不能外推为「HF 全家桶都慢又费内存」。
- 兼容性的隐形成本:drop-in 是 API 层面兼容,但它依赖 PCRE2 和 C++ 扩展,在 Windows 或受限环境(无 libpcre2、无法编译扩展)部署会比纯 pip 安装的 tiktoken 麻烦。
六、优势与局限
优势: API 与 tiktoken 完全兼容,迁移零成本;C++/PCRE2 实现确实更快;官方给了 llama / mistral 两套可复现 benchmark 脚本;对批量数据预处理这种 CPU 密集场景收益明确。
局限: 加速比是自测、随工况波动;需要编译 C++ 扩展与 PCRE2 系统库,部署门槛高于纯 wheel;只解决「tokenize 速度」这一个点,不改变 token 语义;项目较新(仓库 issues 尚少),生产大规模采用还需观察。
七、谁该用
如果你的流水线已经在批量跑 tiktoken、并且 profiler 显示 tokenize 占了大头,值得花十分钟 pip install tokendagger 替换实测——它很可能就是你数据预处理环节最便宜的那点性能红利。但如果你的瓶颈在 GPU 推理或 IO,tokenize 快 2 倍对你整体 throughput 感知有限,不必为了「更快」而引入一个带原生编译依赖的新组件。一句话:它是给数据工程师的「预处理加速器」,不是给在线推理链路的银弹——先 profile,再决定要不要换。