TensorZero:用 Rust 写的开源 LLMOps 飞轮(及它被归档的事实)
阅读时间: 大约 9 分钟
TensorZero:用 Rust 写的开源 LLMOps 飞轮(及它被归档的事实)
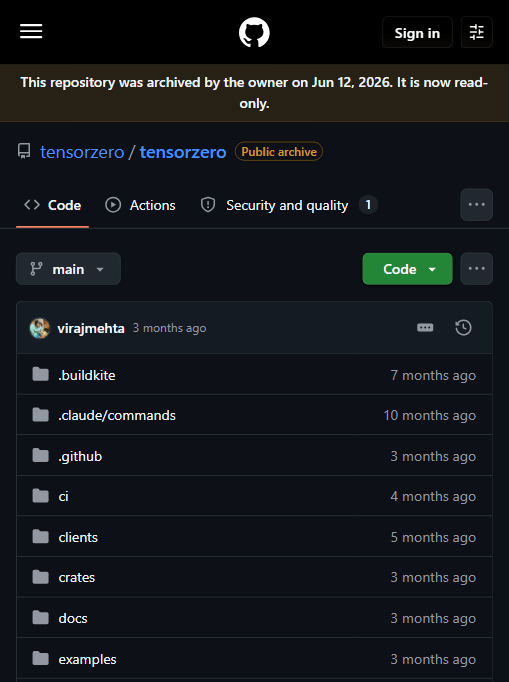
当 LLM 应用从 demo 走向生产,团队很快会发现真正难的不是「调用模型」,而是「调用之后怎么持续变好」:网关路由、调用留痕、效果评估、A/B 实验、用生产数据反哺微调。TensorZero 想做的就是把这一整条链路(它称之为「数据与学习飞轮」)统一成一个开源平台。需要开门见山说明的是:根据其 GitHub 仓库公告,该仓库已于 2026 年 6 月 12 日被所有者归档为只读,本文描述的是归档时的项目状态。
一、它把 LLMOps 拆成五件事
TensorZero 自我定位为开源 LLMOps 平台,统一了五个模块:
- Gateway(网关):通过统一 API 访问所有 LLM 提供商;
- Observability(可观测):把推理与反馈存进你自己的数据库,可在 UI 或程序里查;
- Evaluation(评估):用启发式规则、LLM 裁判等给单次推理或端到端工作流打分;
- Optimization(优化):用指标与人类反馈优化 prompt、模型与推理策略;
- Experimentation(实验):内置 A/B 测试、流量路由、fallback、重试。
它强调「可以按需取用、增量采用」,并与 OpenAI SDK、OpenTelemetry、所有主流 LLM 提供商良好配合。官方称其被从前沿 AI 初创公司到财富 10 强的企业使用,今天承载了约 1% 的全球 LLM API 支出——这个数字属于厂商自述,没有第三方审计。
二、网关:Rust 写的性能底牌
TensorZero 网关最大的工程亮点是用 Rust 编写,官方给出的可核对性能数字是:在 1 万以上 QPS 下,网关自身带来的 p99 延迟开销小于 1 毫秒。这在 LLM 网关里是一个很激进的目标——因为对上游模型动辄数千毫秒的延迟而言,网关若再叠加几十毫秒的 Python/Node 进程开销,在高并发下会被放大成成本与体验问题。
网关支持的能力包括:单次统一 API 调用任意模型(API 或自托管)、tool use、结构化 JSON 输出、batch、embedding、多模态(图像、文件)、缓存,以及路由、重试、fallback、负载均衡、细粒度超时、用量与成本统计、按 tag 做限流、以及让客户端无需持有提供商密钥即可访问模型的鉴权。兼容的提供商覆盖极广:Anthropic、AWS Bedrock / SageMaker、Azure、DeepSeek、Fireworks、GCP Vertex(含 Gemini)、Google AI Studio、Groq、Hyperbolic、Mistral、OpenAI、OpenRouter、SGLang、TGI、Together、vLLM、xAI(Grok),以及任何 OpenAI 兼容 API(如 Ollama)。接入方式也很轻:部署一个 Docker 容器,把 OpenAI SDK 的 base_url 指过来即可。
三、评估与优化:飞轮的核心
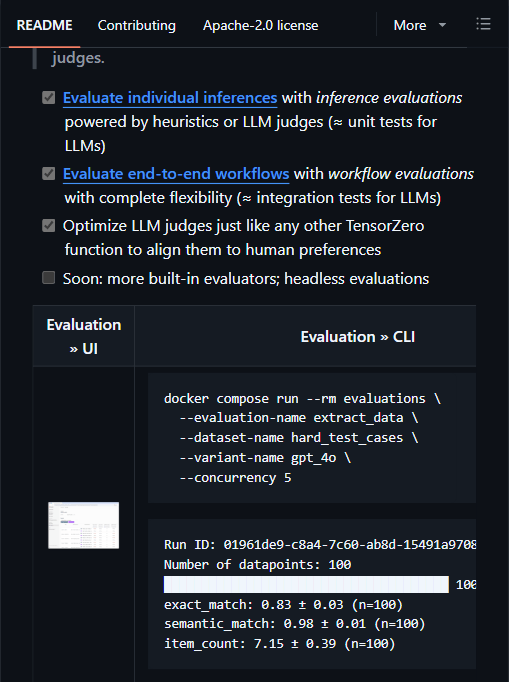
评估模块把单次推理比作「LLM 的单元测试」、把端到端工作流比作「LLM 的集成测试」,并且允许把 LLM 裁判(LLM judge)本身当作一个 TensorZero 函数来优化,使其对齐人类偏好。仓库里给了一个 CLI 评估的真实输出样例:对一个 extract_data 评估、hard_test_cases 数据集、gpt_4o 变体跑 100 条数据,得到 exact_match: 0.83 ± 0.03、semantic_match: 0.98 ± 0.01、item_count: 7.15 ± 0.39。
优化侧则是飞轮的「转起来」的部分:用 SFT、RLHF 等技术优化模型;用 GEPA 这类自动 prompt 工程算法优化 prompt;用动态上下文学习(DICL)、best/mixture-of-N 采样优化推理策略。官方举例:在一个数据抽取(NER)管道里,用少量训练数据微调后的 GPT-4o Mini,在该任务上反超了 GPT-4o,而成本与延迟只有零头。可观测侧还支持把历史推理「重放」到新的 prompt / 模型 / 策略上,并导出 OpenTelemetry(OTLP)链路与 Prometheus 指标。
四、团队与商业化
README 披露了背景:技术团队包括一位前 Rust 编译器维护者、以及来自 Stanford、CMU、Oxford、Columbia、引用量数千的机器学习研究者;融资为 730 万美元种子轮,投资方与 ClickHouse、CockroachDB 等开源项目以及 OpenAI、Anthropic 同源。商业化上,TensorZero(LLMOps 平台)本身 100% 开源自托管(Apache-2.0),而一个叫 TensorZero Autopilot 的「自动 AI 工程师」——自动分析可观测数据、建评估、优化 prompt/模型、跑 A/B 测试——是配套的付费产品。这是一个典型的「核心开源、增值 Agent 收费」的双轨模式。
五、评测口径与需要警惕的地方
必须把宣传语和可核对事实分开:
- 可核对:Rust 网关、<1ms p99 @10k QPS、Apache-2.0、一个 Docker 容器部署、评估 CLI 的样例数字——这些写在仓库里;
- 厂商自述:「承载全球约 1% LLM API 支出」「财富 10 强在用」——没有公开审计,适合作为量级参考,不宜当作结论;
- 最重要的风险信号:仓库已被归档为只读。这意味着上游不再接受新 PR、不再修 bug、不再发新版本;虽然 Autopilot 付费产品与托管服务可能仍在运营,但开源侧的维护责任已经实质性转移给了用户自己。
六、适用与不适用
适合:
- 已经多模型混用、需要统一网关 + 统一可观测的生产团队;
- 想低成本做 A/B 实验、并用生产数据反哺微调 / prompt 的团队;
- 对网关延迟与吞吐敏感(高 QPS)、愿意自托管的场景。
不适合:
- 只调一两个模型、做个小 demo 的团队——上一整套 LLMOps 栈是过度工程;
- 期望上游持续维护、长期安全更新的关键系统——归档状态下这一前提已不成立,需自行 fork 维护;
- 不愿自托管、希望全托管 SaaS 的团队——平台本体是自托管定位。
七、它意味着什么
TensorZero 代表了 LLMOps 赛道里「All-in-one、Rust 高性能网关 + 数据飞轮」这一形态:不做模型,而是做让任何模型在生产里持续变好的中间层。它的工程完成度(Rust、OpenTelemetry、GitOps、自托管)在同类开源项目里相当扎实。但它被官方归档这件事,与同期多个同类项目的命运一起提示了一个现实:LLMOps 中间层赛道竞争惨烈,开源项目的商业化压力极大,选型时不能只看 README 的功能列表,必须先看仓库最近一次提交时间与是否仍在维护。