supermemory:把 Agent 的长期记忆做成一门基础设施
阅读时间: 大约 9 分钟
supermemory:把 Agent 的长期记忆做成一门基础设施
大模型的上下文窗口越长,开发者越容易陷入一个反直觉的困境:把所有历史对话、文件、网页一股脑塞进上下文,不仅成本随 token 数线性暴涨,还会因为「大海捞针」式稀释导致召回质量下降。supermemory 正是冲着这个问题来的——它把「记忆」从模型厂商手里抽离出来,做成一个独立、可跨模型复用的基础设施,通过 API、插件和 MCP 三种方式提供。本文基于 supermemory 官网的一手公开资料,分析其机制、可核对数据与口径偏差。
一、背景:为什么需要独立于模型的记忆
supermemory 在官网给出的判断很直接:智能(intelligence)已经不再是瓶颈,预训练与后训练会持续推高模型能力,但这些都无法让模型在真实使用中实时学习、持续改进。随着开源模型普及、世界走向多模型并存,「学习与记忆」不应该绑定在某一个模型厂商上,而应当与模型无关、可互操作、并且归用户自己所有。
这个判断切中了当前 Agent 工程的真实痛点:传统做法是给每个模型、每个 harness(运行框架)单独写一套 RAG 或对话历史压缩逻辑,向量库选型、数据解析、格式扩展全是重复劳动。supermemory 的卖点就是把这些「硬基础设施」一次性包掉,开发者只需要把数据喂进去、把记忆取回来。
二、是什么:一个「会学习」的记忆引擎
supermemory 定位是「Agent 的记忆与持续学习默认引擎」。它的核心不是又一个向量数据库,而是一个名为 learner-1 的学习模型:对每一个用户、任务或租户的上下文做提取(extract)与「做梦式」归纳(dream),把结果写入自家的向量-图混合数据库(vector-graph database),再在推理时通过 hooks 把相关 token 实时注入到 Agent 的上下文里。
官网用一张图概括了这条流水线:原始数据(文件、聊天、URL)进入后,learner-1 在记忆库上执行 UPDATE / MERGE / INFER / FORGET 四类操作——更新旧记忆、合并重复记忆、推断隐含事实、遗忘过期信息,最终通过 hook 注入到「你的 Agent 的上下文」,并且强调「any model, any harness」。这与传统 RAG「存原文片段、按相似度检索」的关键差异在于:记忆不是静态切片,而是被一个模型持续改写、相互连接、并带有时间维度的「会生长的知识图」。
三、关键数据:规模、延迟与成本
supermemory 在官网直接给出了生产环境口径的数字,这些是本文中相对可核对的部分:
| 指标 | 官方数值 | 口径 |
|---|---|---|
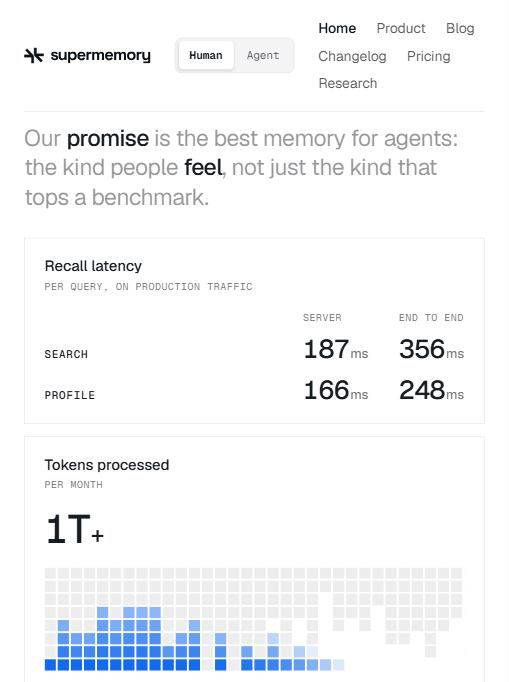
| 每月处理 token | 1T+(万亿级) | 生产流量 |
| 服务组织数 | 100k+ | 官网「in production」区块 |
| 终端用户 | 数千万级(tens of millions) | 官方表述 |
| Search 召回 | 服务端 187ms / 端到端 356ms | 每查询,生产流量 |
| Profile 召回 | 服务端 166ms / 端到端 248ms | 每查询,生产流量 |
| 每问题成本 | $7.79,较基线便宜 64% | 官方自测 |
| 问题答对率 | 81%(基线 69%) | 官方自测 |
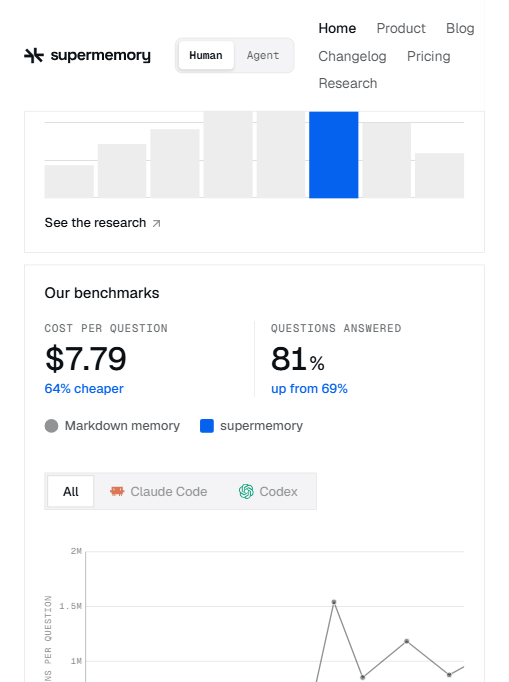
在官方自测的「我们的基准」里,对比对象是一种常见的朴素做法——把历史写成 Markdown 记忆文件直接堆给模型。官网给了两个临界点:当记忆里有 300 个文件 时,Markdown 方案开始「抖动(thrashes)」,每问题消耗约 154 万 token、成本约 $20.95,而 supermemory 约为 $4.71;当文件数膨胀到 9,988 个 时,supermemory 的答对率仍能逼近文件系统(FS)检索的水平(81% 对 69%)。一位名为 Chatarmin 的创始人在 X 上给出的案例是:平均响应时间从 40 秒降到 12 秒,token 用量减少约 40–50%。
四、公开基准:独立评测与自报数据要分开看
官网把数据分成了两类,读者必须区分对待:
- 独立基准:引用了 2026 年 2 月的 SWE-ContextBench,原文称「supermemory 整体表现最佳,FAIL_TO_PASS 测试通过率为 55.95%,解决率 30.30% 为全场最高」;
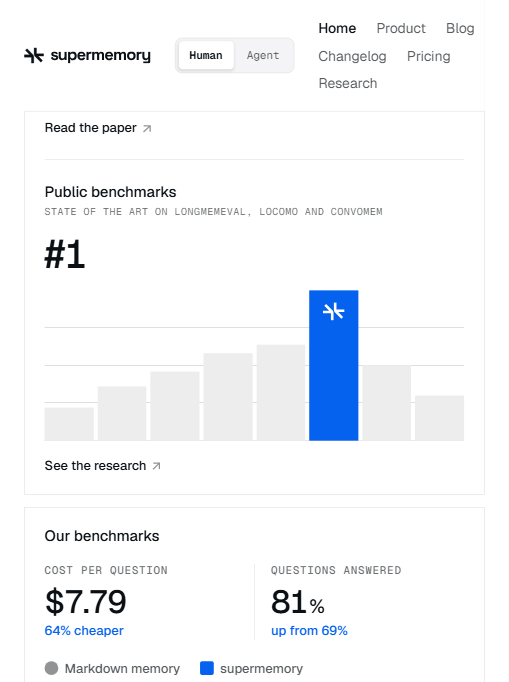
- 公共基准:宣称在 LongMemEval、LoCoMo、ConvoMem 三个长记忆基准上达到「#1」,并附了一张以自家 logo 高亮的柱状图。
需要泼冷水的地方在于:那张「#1」柱状图只有 supermemory 自己的柱子被点亮,其余灰柱没有标注对手名称、分数与测试脚本出处;而「64% 更便宜」「81% 答对率」明确标注为「Our benchmarks」,是与自家定义的 Markdown 基线对比得出的,基线本身就是较弱的一方。这类数字适合作为「量级感」,但不能直接等同于第三方横向评测结论。官网那句「我们承诺给人感觉得到的最好记忆,而不只是在基准上拿第一」本身也是一句营销话术,反过来说明它清楚基准数字有被误读的风险。
五、部署与合规
supermemory 强调「连气隙(air-gapped)环境都能跑」,因为关键基础设施全部自建。部署形态覆盖三档:客户自有机房、客户 VPC、以及个人笔记本。合规方面宣称已通过 SOC 2 认证、HIPAA 合规、GDPR 对齐,并愿意签署 DPA——这一点对医疗、金融等数据不能外泄的行业是硬性前提,也是它区别于纯 SaaS 记忆服务的地方。
六、适用与不适用
适合:
- 已经在做多轮 Agent、客服助手、编程助手,且受上下文成本与召回质量双重困扰的团队;
- 希望记忆能跨 Claude、Codex、本地开源模型复用,不想被单一厂商锁定;
- 有私有化 / 气隙部署与合规审计需求的企业。
需要谨慎:
- 只需要一次性文档问答、且会话很短的场景——直接上 RAG 可能更简单,引入一套独立记忆引擎反而增加运维面;
- 对「记忆正确性」要求极高的场景:learner-1 的 INFER / MERGE 会主动改写、归纳记忆,存在把多个事实合并成错误结论的风险,官网未披露遗忘与纠错的可审计细节;
- 极度成本敏感的纯流量型应用——$7.79/问题的绝对成本并不低,64% 是相对弱基线而言。
七、客观分析:优势与局限
优势:
- 把「记忆」从模型与 harness 中解耦,架构理念清晰,API / 插件 / MCP 三种接入方式降低了迁移成本;
- 生产延迟数据(端到端 248–356ms)达到可用水平,月度万亿 token 的规模说明它不是玩具;
- 支持气隙私有化与全套合规认证,企业落地路径完整。
局限:
- 关键的成本与答对率优势主要来自自报基准,缺少第三方在统一脚本下的横向复测;
- 向量-图混合库 + 主动归纳的「黑盒记忆」可解释性与可审计性偏弱,记忆被自动合并 / 推断出错时的排查成本未知;
- 官网未公开完整定价档位与免费额度,企业实际成本需要另行与销售确认。