Supabase Analytics Buckets:把分析负载从 Postgres 卸到 Iceberg/S3
阅读时间: 大约 11 分钟
Supabase Analytics Buckets:把分析负载从 Postgres 卸到 Iceberg/S3
2025 年 12 月 2 日,Supabase 工程师 Fabrizio Fenoglio 在官方博客发布 Analytics Buckets:这是 Supabase Storage 里一种专门为分析型负载设计的存储类型,底层建立在 Apache Iceberg 与 Amazon S3 之上,数据以列存的 Parquet 格式落地。官方对它的定位很直白——「把它当作挂了查询引擎的冷存储」:热事务数据留在 Postgres,历史数据与分析负载放进 Analytics Buckets,两者用熟悉的工具一起查询。本文基于官方博客原文做一手拆解,并标注哪些数字是「官方称」、哪些是已核实的设计约束。
一、背景动机:Postgres 不是为分析负载设计的
Supabase 的核心卖点是「Postgres 即后端」,绝大多数业务表、行级权限、实时订阅都跑在 Postgres 上。但 Postgres 是行存的 OLTP 数据库,擅长低延迟、高一致性的点查与小事务,不擅长对百万、十亿行表做全表扫描、聚合和时序分析。当团队把事件日志、埋点、历史快照都塞进 Postgres,会出现两个典型问题:一是数据库存储与备份成本随历史数据线性上涨;二是重型分析查询与在线事务争抢资源,拖慢应用读路径。
Analytics Buckets 要解决的就是这个「冷热混存」问题。官方的建议架构是数据分层(data tiering):按时间分区,Postgres 里只留滚动窗口(官方示例为最近 90 天),更早的数据由摄入管线写入 Analytics Buckets,需要时再查历史。
二、是什么:一种新的 Bucket 类型,而非新数据库
Analytics Buckets 不是一个新的查询数据库,而是 Supabase Storage 下与普通 Storage Bucket 并列的一种类型。创建方式有两种:在 Dashboard 的 Storage 里「Create Bucket」时选择类型为 Analytics Bucket;或用 SDK:
await supabase.storage.createBucket('my-analytics-bucket', {
  type: 'ANALYTICS',
})
Dashboard 里可以直接定义列与数据类型(包括带精度和标度的 decimal 等复杂类型),对应的外部数据包装器(Foreign Data Wrapper, FDW)schema 会自动配置好。建成之后,它在管理界面里和 Postgres 表几乎用同一套方式管理。
三、技术机制:Iceberg + S3,存算分离
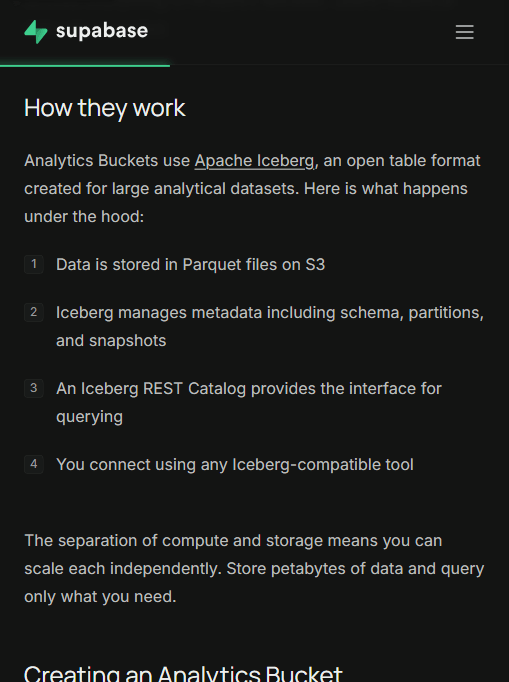
官方博客给出的底层链路是四步(见首图):
- 数据以 Parquet 文件存在 S3 上;
- Iceberg 管理元数据,包括 schema、分区和快照(snapshot);
- 通过一个 Iceberg REST Catalog 提供查询接口;
- 用任意 Iceberg 兼容工具连接。
这套设计的关键含义是存算分离:存储在 S3 上可以到 PB 级,查询计算则由你选择的引擎承担,二者独立伸缩。认证需要两套凭证——用 Supabase service key 认证 Iceberg REST Catalog(管元数据),用 S3 凭证认证对象存储(管 Parquet 数据本身)。
从 Postgres 侧查询历史数据,走的是外部数据包装器。官方示例里先建一个 iceberg_server 外部服务器,再 import foreign schema "analytics" 把表导入本地 schema,之后就能像查普通表一样 select * from iceberg.events where event_timestamp > '2024-01-01',从而把 Postgres 里的热数据和 Buckets 里的历史数据做 join。
四、关键数据:官方口径一览
| 维度 | 官方口径 | 来源 |
|---|---|---|
| 存储成本 | 官方称相比数据库存储可节省 30–90%(针对大数据集) | 官方博客「Cost-effective storage」 |
| 存储格式 | Parquet 列存,开放表格式 Apache Iceberg | 官方博客 |
| 建议热数据窗口 | Postgres 保留最近 90 天,更早归档 | 官方博客「Data tiering pattern」 |
| 兼容工具 | PyIceberg、Spark、DuckDB、Athena、Trino、Flink、Snowflake(外部表)、BigQuery(BigLake) | 官方博客「Compatible tools」 |
| 当前状态 | Private Alpha,alpha 期间免费 | 官方博客「Pricing and availability」 |
| 网络费用 | 把数据移出本区域时仍按标准 egress 计费 | 官方博客「Pricing and availability」 |
需要强调:「30–90% 节省」是官方博客给出的区间表述,没有附带测量方法、数据量门槛或对比基准,属于厂商自述而非独立评测。是否真能省到这个量级,取决于你的数据集是否真的大到适合列存扫描、以及你原本在 Postgres 上为历史数据付出的存储与备份成本。
五、官方强调的能力与「口径偏差」
官方列出的核心能力有四项,值得逐条看:
- 开放表格式,无厂商锁定:Iceberg 是开放格式,数据可以从任何兼容工具查询。这一点与「存 S3」是一体两面——数据物理上在你可控的 S3 上,而不是锁在 Supabase 专有的二进制格式里。
- Schema evolution:可以改表结构而不必重写已有数据,这是 Iceberg 元数据层的能力,不是 Supabase 自研。
- Time travel:可以查询历史快照,看表在任意时间点的样子。
- Full audit history:每次变更都被保留,可追踪改了什么、何时、如何改。
官方自己也点明了两个 nuance,读的时候必须带上:
第一,alpha 阶段「免费」不等于长期免费。博客明确写了 Analytics Buckets 在 Private Alpha 期间免费,但一旦出 alpha,存储走 S3 定价是确定方向,跨区域 egress 也照常收费。现在申请试用不能作为长期 TCO 的依据。
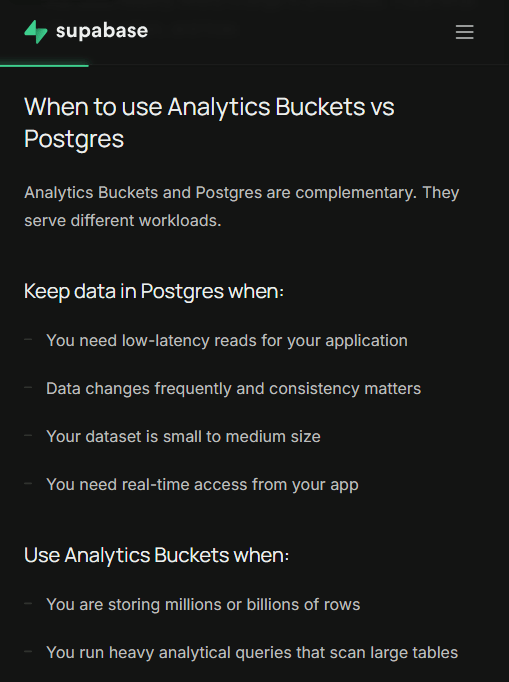
第二,它不替代 Postgres 的在线路径。官方专门用一节「When to use Analytics Buckets vs Postgres」划线:需要低延迟应用读、数据频繁变更且强一致、中小数据集、应用要实时访问——这些留在 Postgres;存百万/十亿行、跑扫大表的重型分析、要低成本长期保留、要多工具查询、要完整审计历史——才用 Buckets(见下图)。
六、优势与局限
优势:
- 存算分离 + 开放格式,避免了「分析数据又被锁进一个新 SaaS」的老路;
- 与 Postgres 通过 FDW 打通,热温数据可以在一个查询里 join,工程衔接成本低;
- 兼容生态广(DuckDB、Spark、Trino、Athena 等),不会因为用了 Supabase 而绑死查询引擎。
局限与风险:
- 双凭证、双服务的认证模型(REST Catalog + S3)比普通 Supabase Storage Bucket 复杂,应用侧和运维侧都要理解 Iceberg Catalog 这一层;
- 查询性能官方没有给出任何时延或吞吐数字,因为查询快慢取决于你选哪个引擎、怎么建分区,Supabase 本身不托管一个「开箱即快」的分析引擎;
- alpha 阶段需要填表申请,能力与定价都可能在 GA 前调整;
- 「time travel / 审计历史」依赖 Iceberg 快照保留策略,保留多久、清理策略如何,官方博客没有展开,落地时需要另行确认。
七、谁该关注
- 已经在用 Supabase、且把事件/埋点/历史数据堆在 Postgres 里、开始感受到存储成本或分析查询拖累的团队;
- 想要「Postgres 做事务、对象存储做历史、开放 Iceberg 格式做分析」这条存算分离路线、又不想自己搭一套数据湖的人;
- 正在评估 Iceberg 落地、但不想直接面对裸 S3 + REST Catalog 运维的小团队。
对只是做中小规模 CRUD、没有大量历史分析负载的应用,Analytics Buckets 现阶段并没有切入理由——按官方自己的分界,那本来就该待在 Postgres 里。