Strata:在 12GB 显存的游戏 PC 上跑 125B 参数 MoE 模型
阅读时间: 大约 12 分钟
Strata:在 12GB 显存的游戏 PC 上跑 125B 参数 MoE 模型
125B 参数级别的模型,过去基本是「服务器专属」:它的权重通常需要几百 GB 显存才能加载。而开源项目 Strata(作者 Niko1221,MIT 协议)给出了一个非常激进的答案——让你手里那块 12GB 显存的游戏显卡,配合 64GB 内存,在 Windows 或 Linux 上本地跑起 Qwen3.8-Flash-Next 这个 125B 参数的 MoE 模型。本文基于其官方仓库 README、自测数据表格与工作原理图,拆解它到底做了什么、能跑多快,以及这些数字背后有哪些官方自己标注的前提条件。
一、背景:MoE 给消费级硬件留出了什么空间
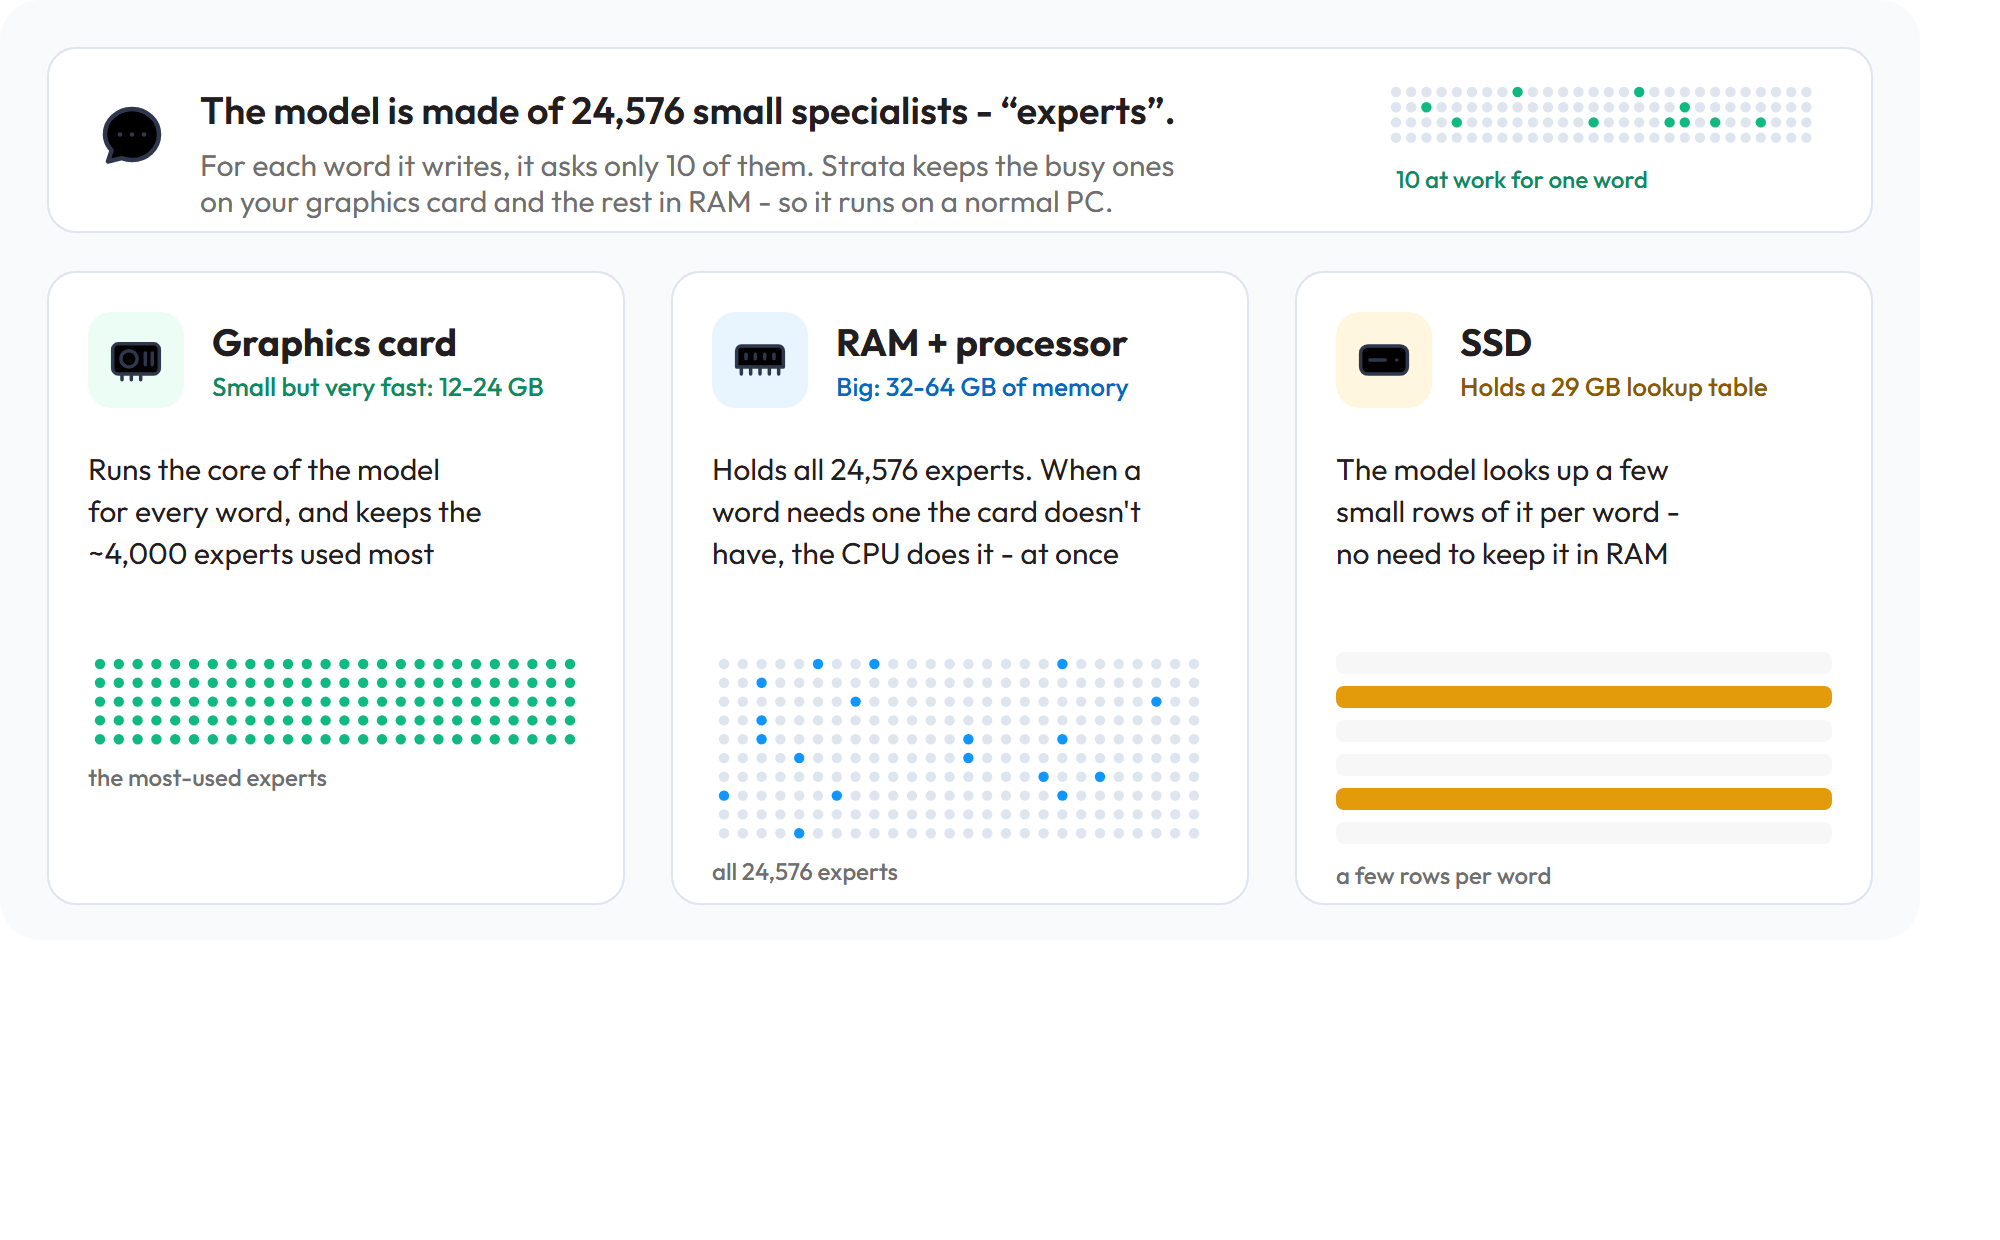
稠密大模型的麻烦在于「每次生成一个词,所有参数都要参与计算」,显存不够就是跑不动。但 MoE(混合专家)模型换了一种结构:它把网络切成成千上万个小型「专家」子网络,每生成一个词只路由到其中少数几个。Qwen3.8-Flash-Next 就是这种结构——官方在 README 里给出的数字是 24,576 个专家,每个词只激活其中约 10 个。
这意味着两件事:第一,模型虽然有 125B 总参数,但瞬时计算只碰很小一部分;第二,既然绝大多数专家在某一步是「沉默」的,它们就不必同时待在最快的显存里。Strata 做的事情,本质上是把这个结构性的稀疏性,转化成一套跨显存、内存、SSD 的分层调度。
二、是什么:一个一键安装的本地推理引擎
Strata 不是一个模型,而是一个推理引擎:底层复用了 llama.cpp / ggml(MIT)的算子库,上层把模型压缩权重加载、专家调度、投机解码和一个本地 Web 服务打包成「双击即装」。它的产品形态很完整:
- 本地起一个 OpenAI 兼容服务,默认监听
http://127.0.0.1:8080/v1,可直接填进 Claude Code、Cursor、Codex 等工具;同时提供 Anthropic 兼容端点/v1/messages、Responses API/v1/responses,甚至带一个 MCP server 让 AI 助手帮你安装、启停; - 浏览器里自带 Chat、实时 Monitor(看 GPU/CPU/RAM/速度)和 About 三个页签;
- 支持可选的图像输入、思考强度(off/low/medium/high)调节、多卡分摊。
官方明确它跑的是 Qwen3.8-Flash-Next(Qwen 团队出品),压缩版由 ISTA-DASLab、UkisAI(Swift 1.5)和 Unsloth 分别制作。模型权重本身不在仓库里,需自行下载约 70GB。
三、技术机制:专家分层驻留 + 投机解码
Strata 的核心思路被官方比作「厨房」:常用的东西放灶台(显卡),其余放储藏室(内存),大件参考书放书架(SSD)。
具体是三层:
- 显卡(12–24GB,小而快):跑每一步都需要的共享计算核心,并缓存约 4,000 个「最常被路由到」的专家。这个热门集合不是写死的,而是在使用过程中动态学习的。
- 内存 + CPU(32–64GB,大):把全部 24,576 个专家都放在这里。当某个词需要的专家不在显卡上时,CPU 当场算这一块,且与显卡并行,两边互相不等。
- SSD(约 80GB 空闲):存一张约 29GB 的查找表(对应 MoE 的路由/量化查表),模型每词只从中读几小行,不必整个塞进内存。
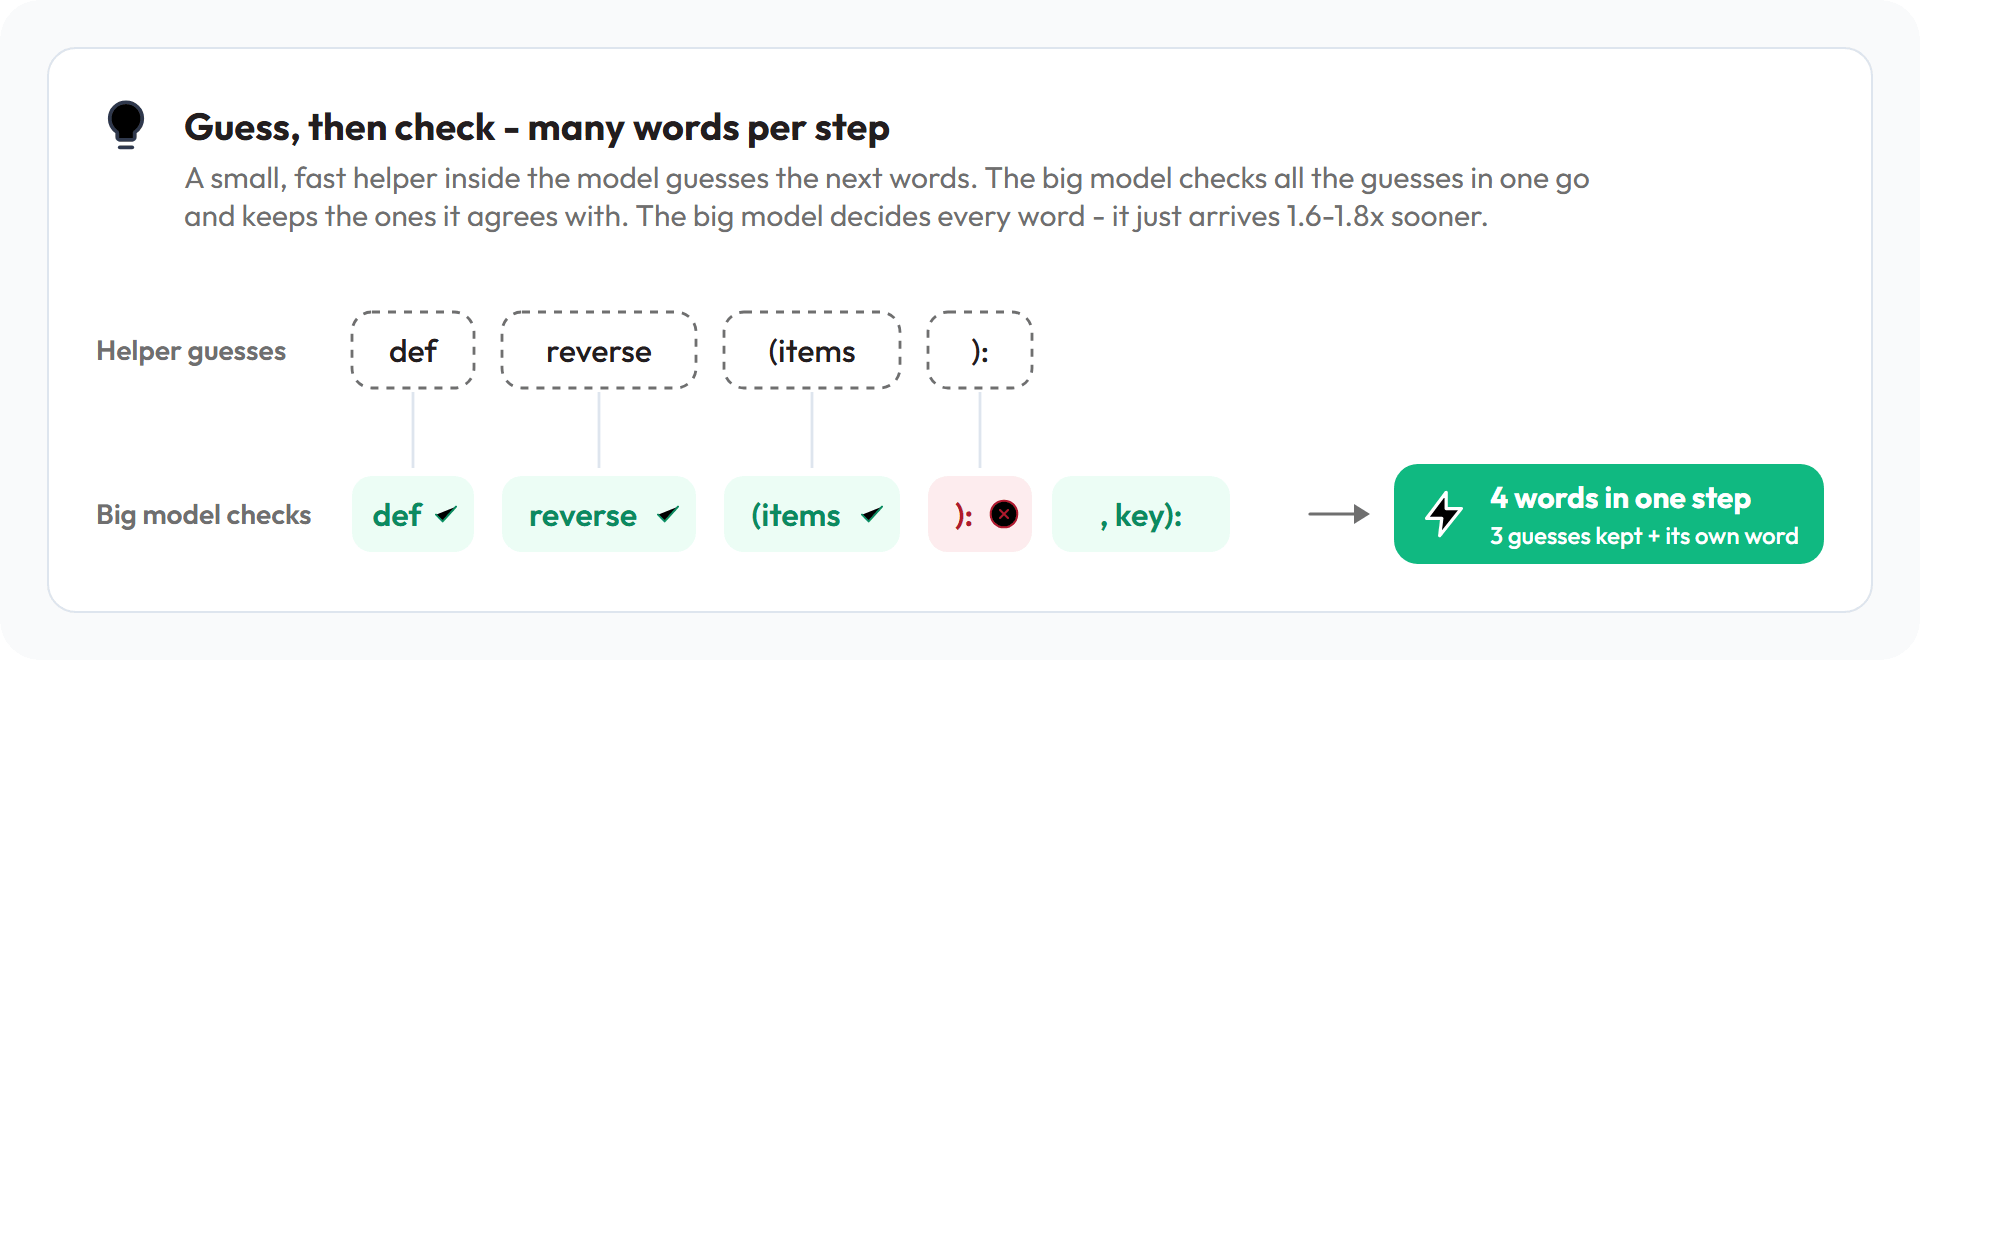
在这个基础上它叠加了第二招——投机解码(speculative decoding):模型内置一个小而快的「助手」先猜接下来几个词(图里是 def reverse (items ):),大模型一次性并行校验:对的就留下(def、reverse、(items),错的拒绝(:) 被打叉),再自己补一个词(, key):)。官方称这样一步能出 4 个词,整体提速 1.6–1.8 倍,且大模型对每个词拥有最终决定权,答案质量不变。长上下文的「读入」则按最多 8,192 个 token 一块批量预填充,因此 prompt 处理能跑到每秒上千 token。
四、关键数据:在两块普通游戏 PC 上测出来的速度
官方最新 README 给出的主测平台是 RTX 5070(12GB)+ Ryzen 5 7600 + 64GB 内存,「写答案」指短对话里回复生成速度,「读 prompt」指喂入 32K token 文档的处理速度:
| 量化规格 | 写答案(短对话) | 写答案(128K 上下文) | 读 prompt |
|---|---|---|---|
| Q2_0 | 90 token/s | 67 token/s | 1,310 token/s |
| IQ2_XS | 74 token/s | 60 token/s | 1,240 token/s |
| IQ3_XXS | 62 token/s | 46 token/s | 1,110 token/s |
| IQ3_S | 52 token/s | 41 token/s | 1,070 token/s |
| Coder(IQ1_M) | 51 token/s | 44 token/s | 1,300 token/s |
内存+显存总占用随量化档位上升:Q2_0 约 37.6GB、IQ2_XS 约 39.2GB、IQ3_XXS 约 47.0GB、IQ3_S 约 54.8GB。官方据此给出选购建议:32GB 内存选 Coder、48GB 选 IQ2_XS/Q2_0、64GB 全档位可用(推荐 IQ2_XS)、96GB 以上才上 IQ3_S 或 Unsloth 的约 4bit 版本。
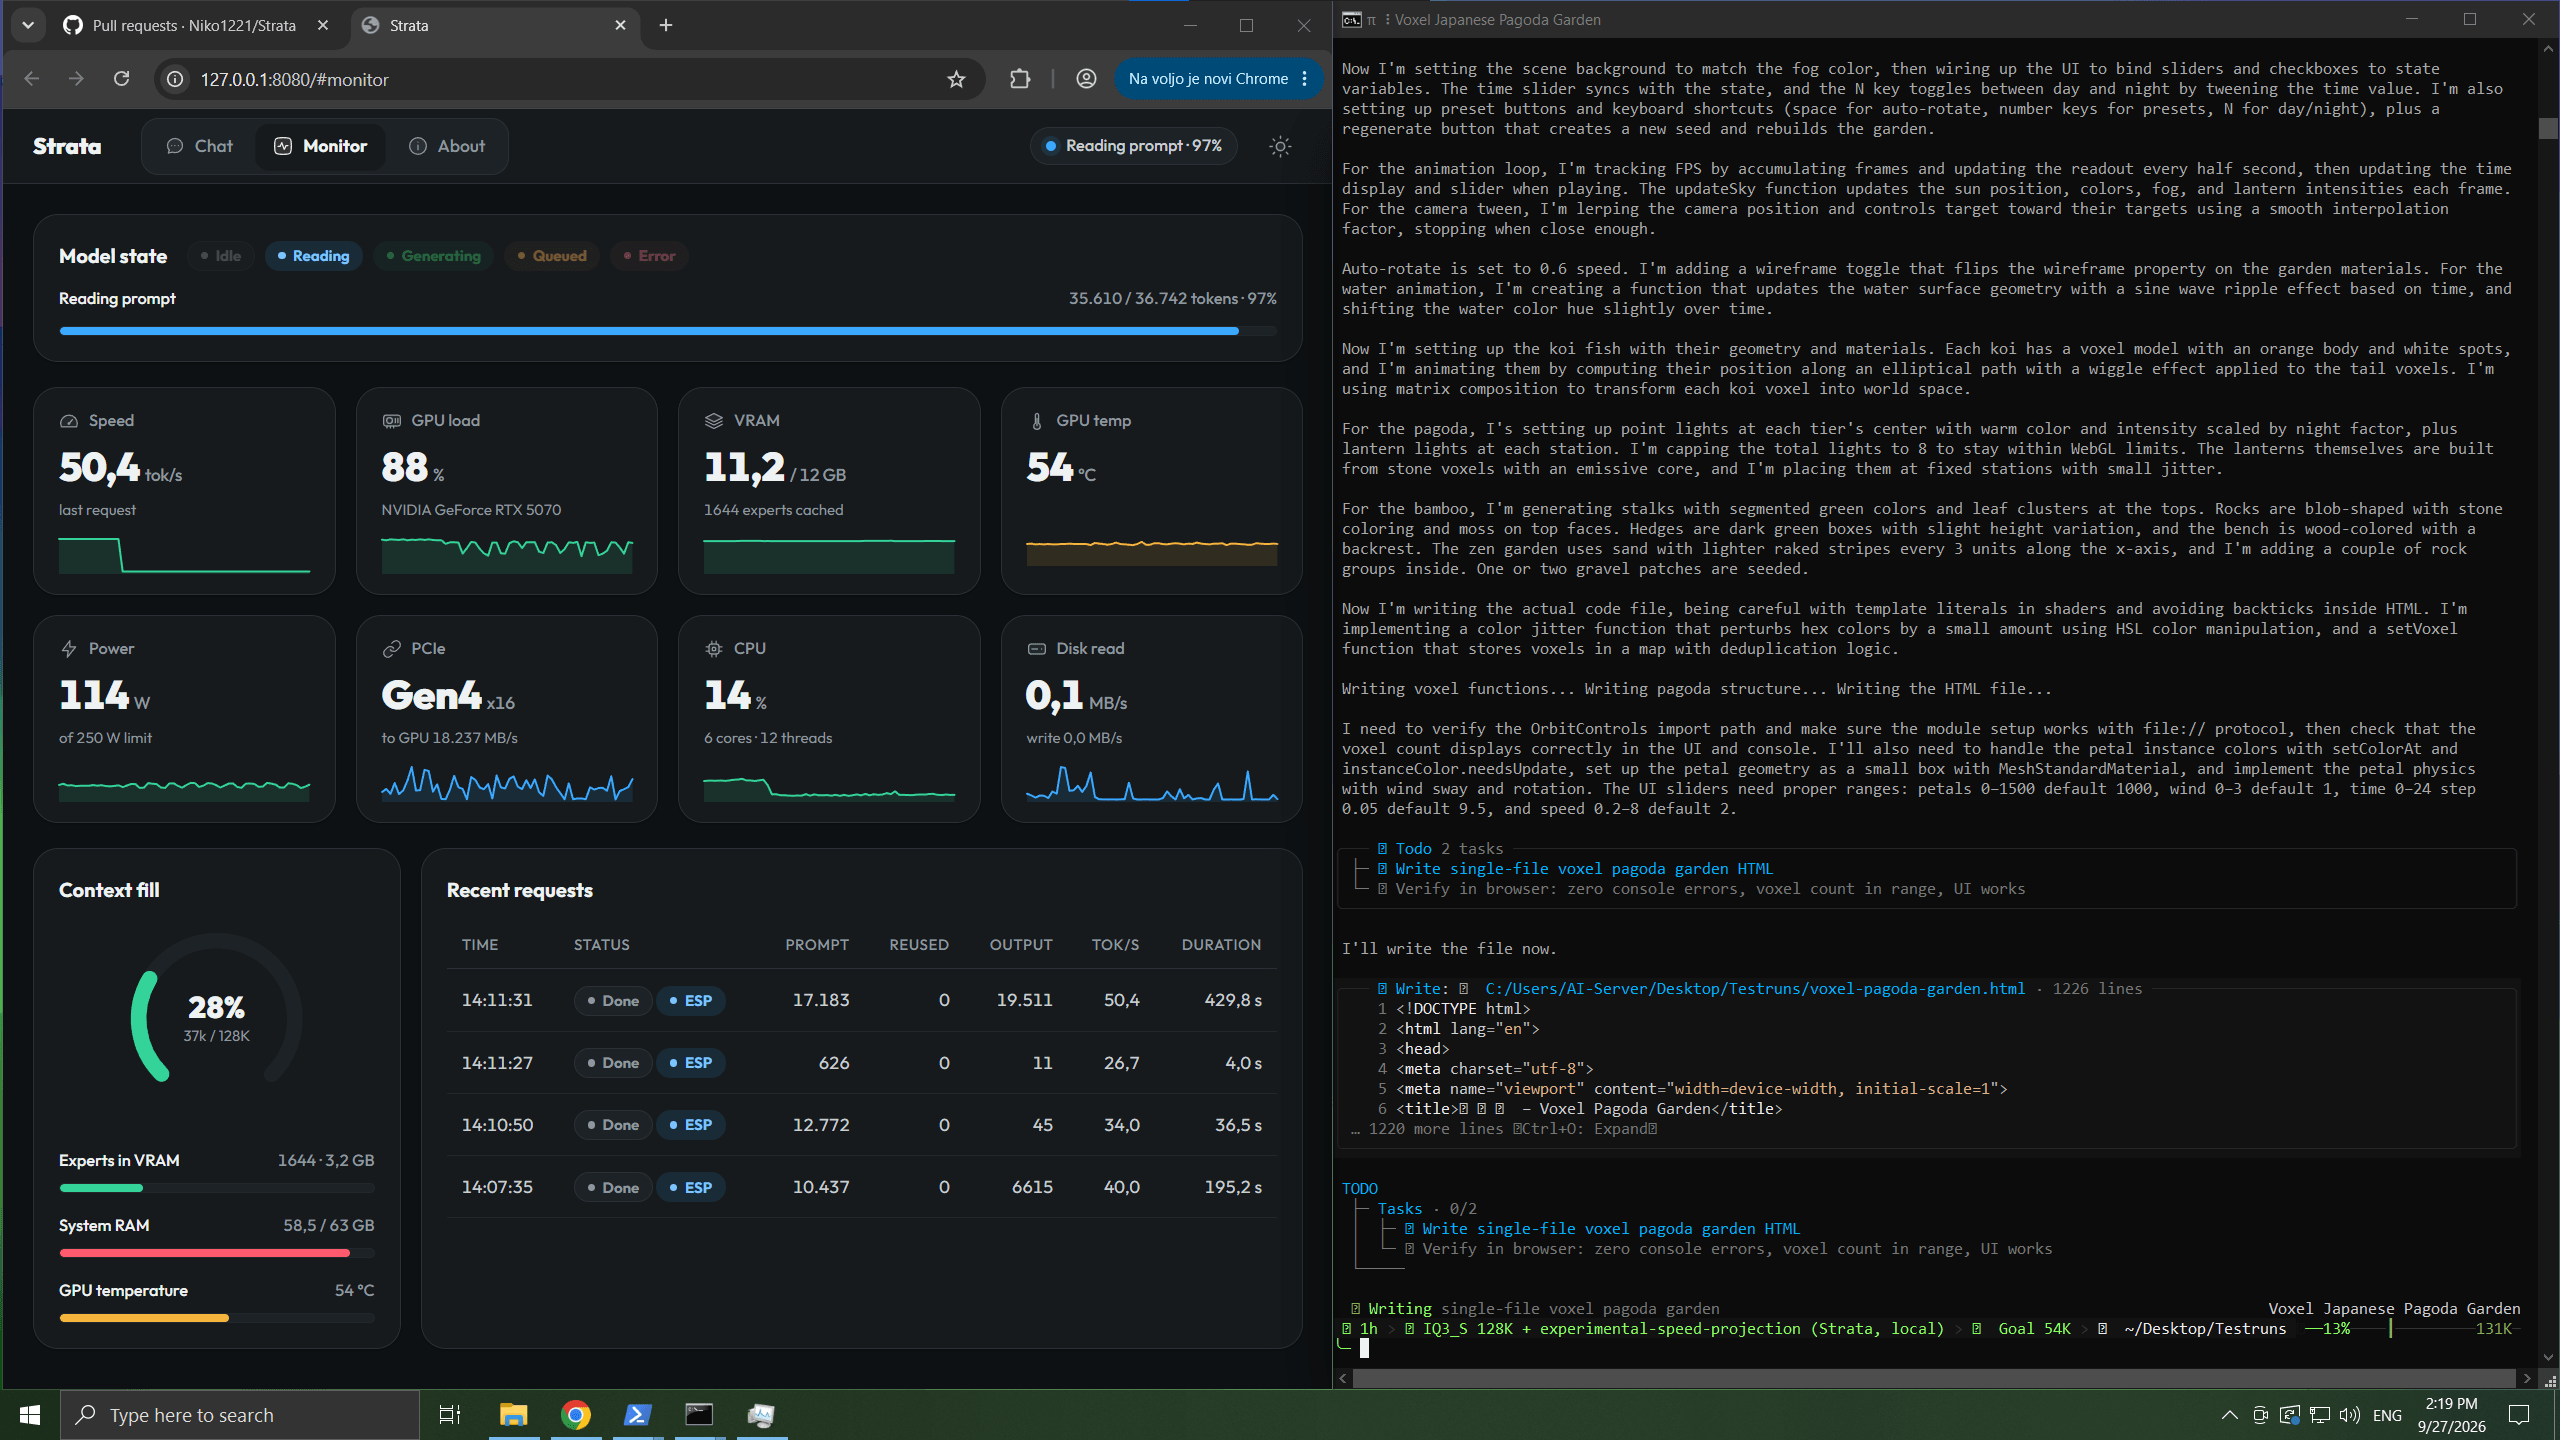
上面这张 Monitor 截图很能说明问题:一次 37K/128K 上下文的长 prompt 处理中,速度 50.4 tok/s、GPU 负载 88%、显存 11.2/12GB(已缓存 1644 个专家、占 3.2GB)、系统内存 58.5/63GB——显存几乎打满、内存也吃掉九成,正是这套「全家桶调度」的真实写照。
五、评测方法批判:这些数字的口径,官方自己说得很清楚
看上面的表时,有几点必须连同数字一起读,否则容易高估:
- 测量环境是作者自己的两台机器,不是标准跑分套件;「token 约等于 3/4 个英文单词」也是官方自己的换算说明。
- RTX 3090(24GB)能到 100–140 token/s 是「推算」而非实测,原文用词是 “should do roughly”;官方版本历史里不同行还跑在不同引擎版本上(部分 0.1.26、Q2_0 那行 0.1.36),严格说表内各行并非完全同条件。
- Coder 版「保留全模型 91% 的 SWE-bench Verified、99% 的 LiveCodeBench」是压缩方 ISTA-DASLab 自己测的,不是 Strata 团队复测;它删了一半专家,官方同时承认它在代码之外偏弱,包括中文等 CJK 文本。
- IQ3_S「在公开测试上追平原模型」仅对原始模型成立,且最顶档 Unsloth UD-Q4_K_XL 在 64GB 机器上大部分权重要边答边从 SSD 读,官方实测只有 7–8.5 token/s——这说明「能跑」和「跑得爽」是两回事。
- 安装器里那个「experimental speed projection(实验性速度预测)」默认是关的,官方要求你先读说明再开——它用到的向量还带着 Qwen 社区许可,不算完全自由。
六、优势与局限
优势:
- 把 125B MoE 的本地门槛拉到了消费级:12GB 显卡 + 64GB 内存即可,且一键安装、对非专家友好;
- 工程完成度高:OpenAI/Anthropic/Responses 三套兼容端点 + MCP + Monitor,接现有工具链几乎零成本;
- 机制有真东西:专家热度分层、CPU/GPU 并行兜底、投机解码都是被论文和实测支撑的方向,不是简单「把权重扔内存里跑」。
局限:
- 只能单请求串行:默认一次答一个请求,虽然能开
parallel:2,但官方明说在 12GB 卡上会让每条更慢——它不是并发服务; - 内存代价沉重:要 32GB 起步、64GB 才舒服,首次启动会锁死 35–55GB 内存、PC 可能卡 1–3 分钟;
- 必须激进量化:能在 12GB 卡上跑本身就意味着 Q2/IQ2 级别压缩,质量与全精度有可见差距;AMD 卡读图在 Windows 上尚不可用;
- 不是生产级推理栈:它面向个人桌面,不做调度、不做弹性扩缩,别拿它对标 vLLM/SGLang 的服务能力。
七、谁该关注
- 想在本地跑旗舰级 MoE、又不想买专业卡的个人开发者与隐私敏感用户;
- 需要把大模型接进 Claude Code / Cursor 做离线编码 Agent、且机器内存够大的人;
- 对「MoE 专家调度 + CPU/GPU/SSD 分层」这套工程思路感兴趣的推理引擎开发者——它背后还有一篇专门的论文可挖。
但如果你只有 16GB 内存、或想要多人并发的 API 服务,这个项目目前并不适合你——它的定位就是「一台高配游戏 PC 上的私人大模型」。