Stagehand:Browserbase 出品的浏览器 Agent SDK
阅读时间: 大约 10 分钟
Stagehand:Browserbase 出品的浏览器 Agent SDK
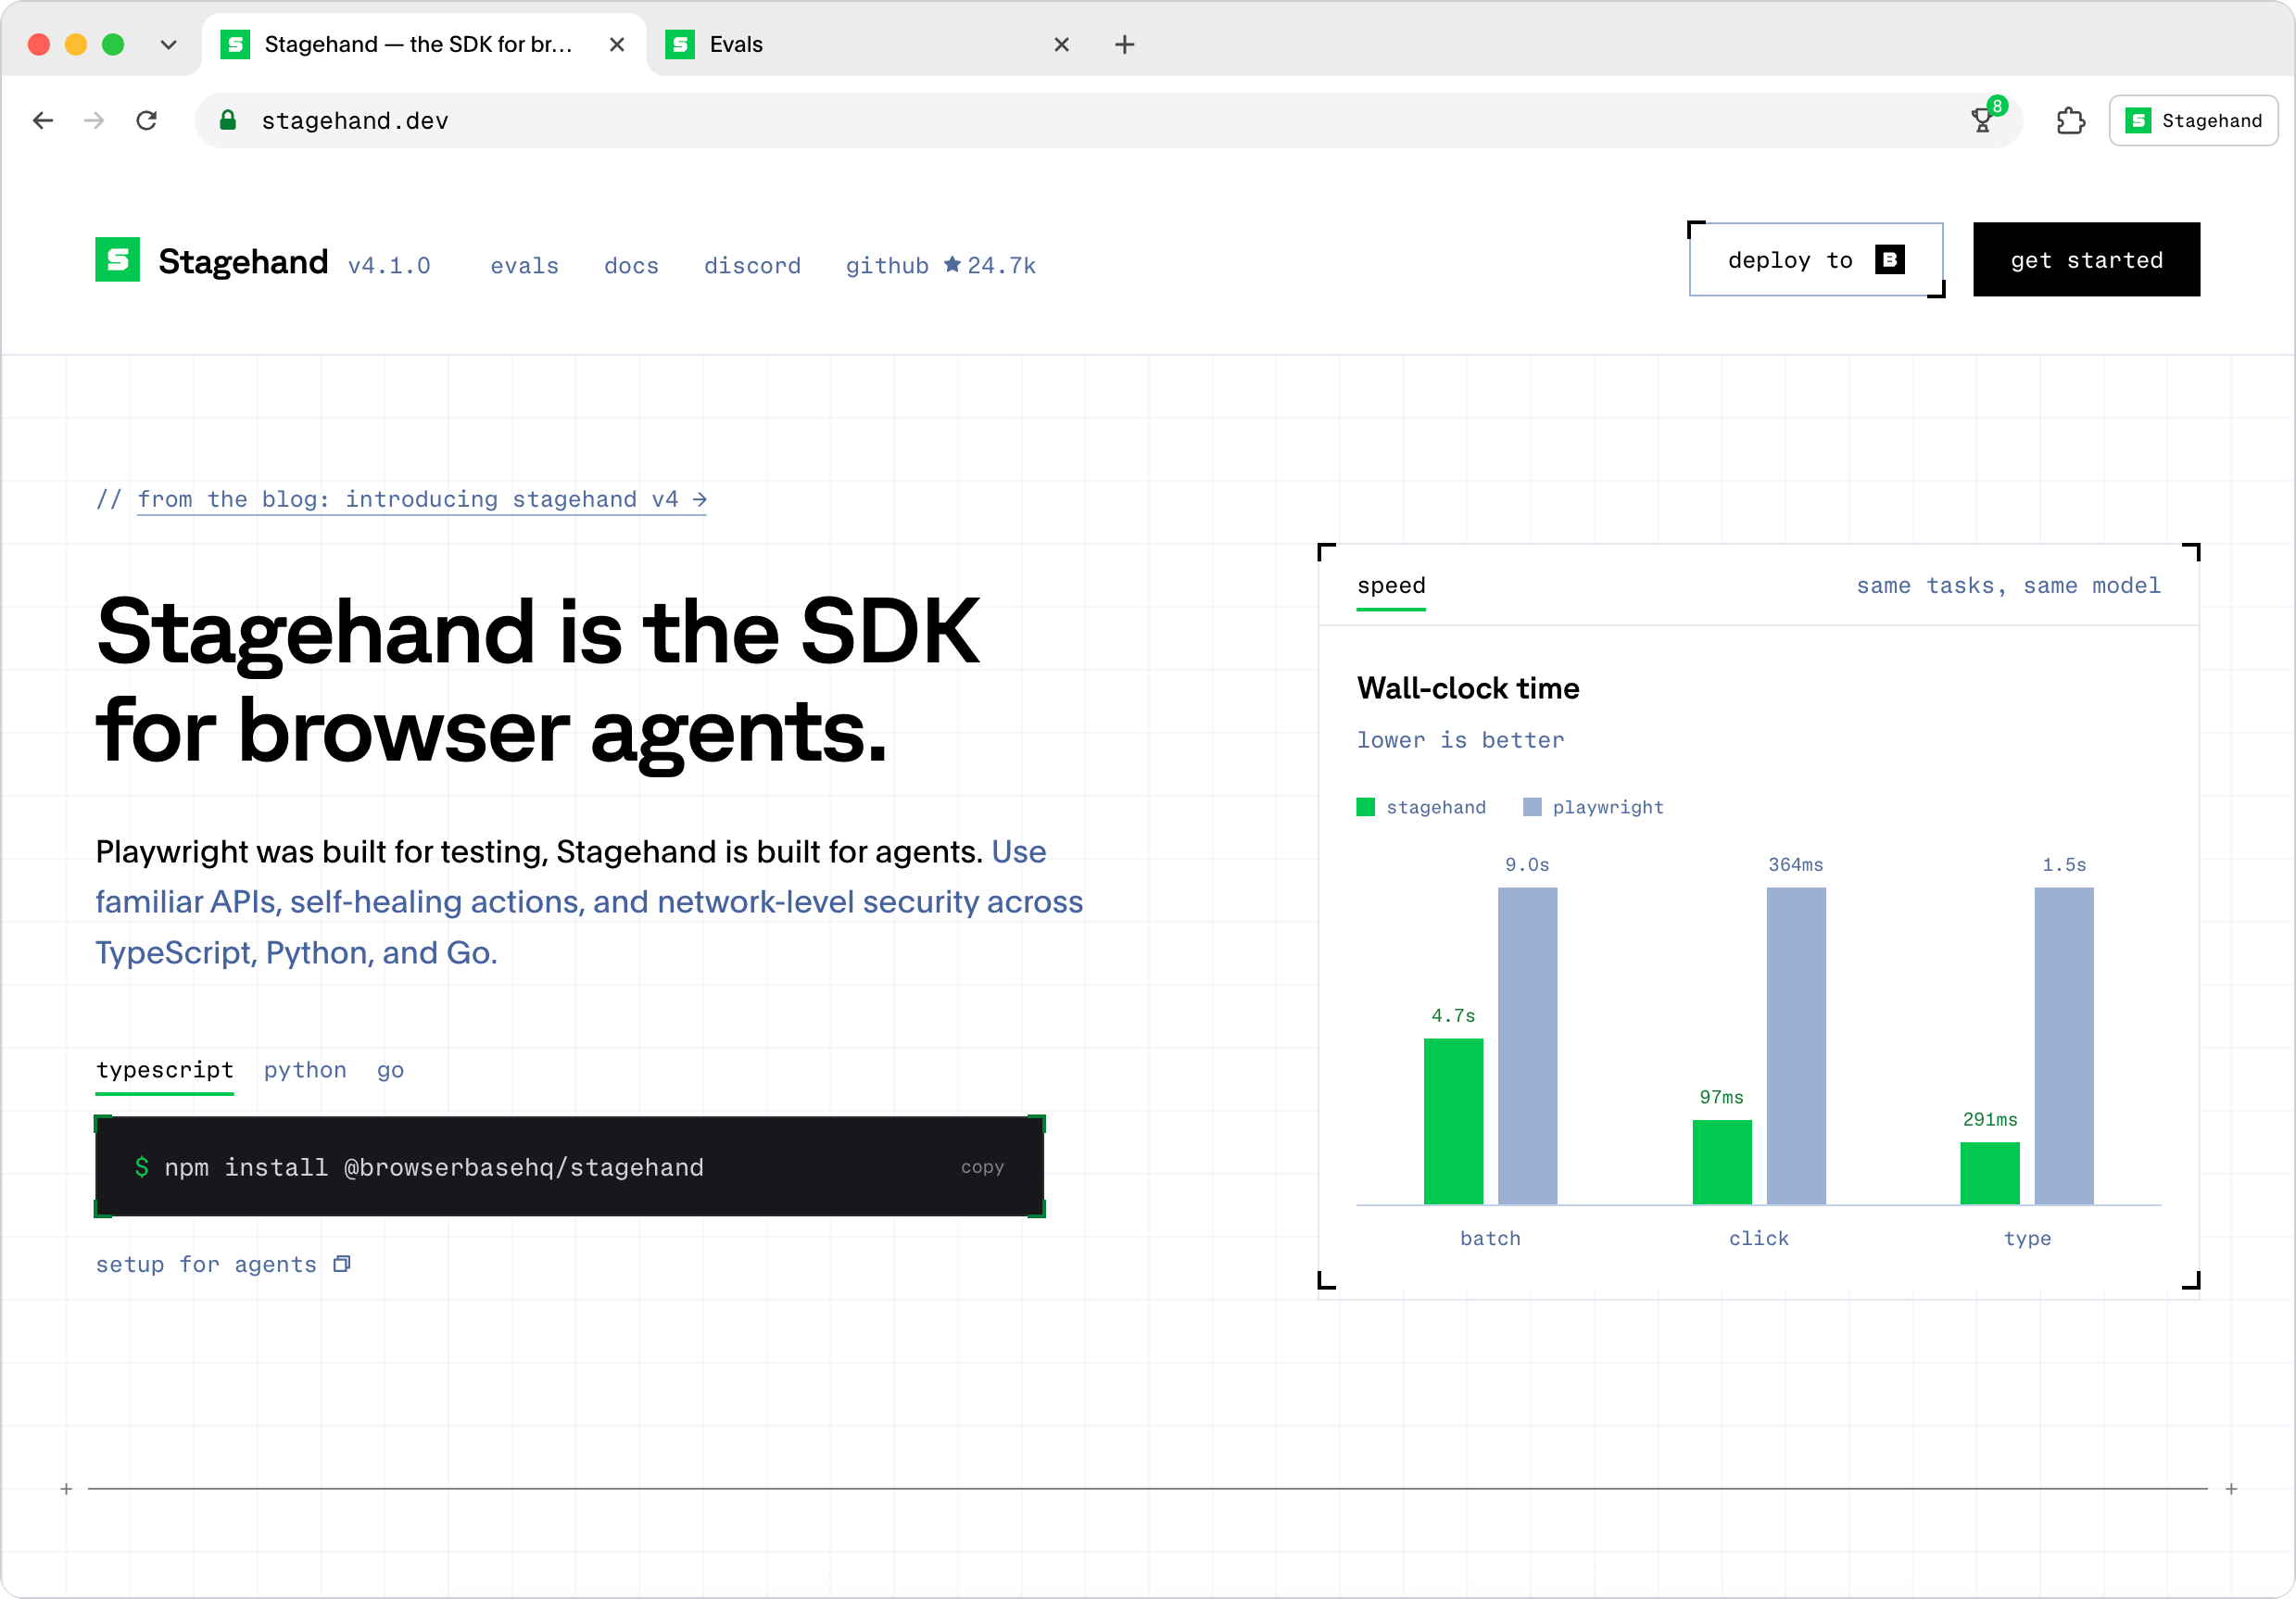
Stagehand 是云浏览器公司 Browserbase 开源的浏览器自动化 SDK,当前官方导航栏显示约 25.5k star,以 MIT 协议发布(Copyright 2026 Browserbase, Inc.)。它的自我定位非常直白——官网首页大字写着 “Playwright was built for testing, Stagehand is built for agents”。也就是说,它不打算替代 Playwright 写测试,而是要给 LLM Agent 提供一套”像人一样用浏览器”的控制层。本文基于其 GitHub 仓库 README 与官网一手资料,拆解它到底解决了什么问题、机制是什么,以及官方公布的数据该怎么读。
一、背景:为什么 Playwright 不够用
传统浏览器自动化(Playwright、Puppeteer)是给人写死的脚本用的:你必须先知道点哪个选择器、表单字段叫什么。但 AI Agent 面对的是一个动态、未知、经常改版的网页,它需要的是”帮我点登录按钮""把表格里的发票抽出来”这种自然语言意图,而不是精确的 CSS 选择器。
Koala 周报对它的点评也点出了这一点:相比”让 AI 用一个 prompt 自行探索怎么完成任务”的做法,Stagehand 倾向于用明确的多个原语指示 AI 如何行动,其底层 AI 交互思路与 Browser Use 类似,但它把工程重点放在了”让 Agent 少花 token、动作更快、页面改版后能自愈”上。
二、是什么:三个自然语言原语 + Playwright 式 API
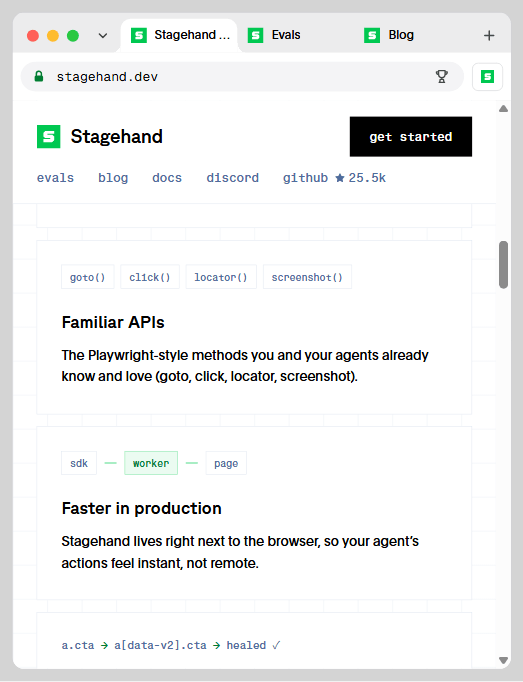
Stagehand 对外暴露两层能力。底层是开发者熟悉的 Playwright 式方法:goto()、click()、locator()、screenshot();上层是三个面向 LLM 的自然语言原语:
act(instruction):用自然语言执行动作,例如sh.act("click the sign in button");当网站改版、原选择器失效时,它会自动重新定位(官方示例:a.cta → a[data-v2].cta → healed ✓)。observe(instruction):先让模型”看”页面、返回真实可用的 selector,再由代码自己去fill()。README 特别强调:这样密码等敏感凭据永远不会进入模型上下文。extract(instruction, schema):抽取结构化数据,用 Zod(z.object(...))声明 schema,返回经过校验的 JSON。
三、技术机制:跑在浏览器旁边,按需裁剪可访问性树
Stagehand 速度快的关键有两个工程设计。第一,它作为浏览器扩展跑在浏览器旁边,架构上是 sdk → worker → page,而不是让每一步动作都走一次远程往返。官方称这样”Agent 的动作感觉是即时的,而不是远程的”。
第二是 hybrid accessibility tree trimming(混合可访问性树裁剪):把整页的无障碍树按任务裁剪,只喂给模型它真正需要理解的那部分 DOM,而不是把整页 HTML 塞进去。官网给出的对比是:完成同一任务,Stagehand 只消耗约 7.4k tokens,而直接把页面交给模型约需 35.7k tokens——这是官方自报数据,意在说明它”把 token 效率当一等公民”。
此外它还提供 WebMCP 页面工具发现、剪贴板支持、批量命令、能穿透嵌套 iframe 与关闭态 Shadow DOM 的 deep locator、以及 OTel 链路追踪。语言上一套完整驱动同时覆盖 TypeScript、Python、Go。
四、关键数据:官方怎么比的
官网首页给出”same tasks, same model”条件下,Stagehand 与 Playwright 完成三类动作的 wall-clock 时间对比:
| 动作 | Stagehand | Playwright | 官方称提速 |
|---|---|---|---|
| batch(批处理) | 4.7s | 9.0s | 约 1.9 倍 |
| click(点击) | 97ms | 364ms | 约 3.8 倍 |
| type(输入) | 291ms | 1.5s | 约 5.2 倍 |
配套的 token 对比为 Stagehand 约 7.4k vs Playwright 约 35.7k。把脚本指向 Browserbase 托管浏览器时,官方还声称”比 Playwright 云浏览器快约 2 倍”,并提供 Model Gateway(自动为每个动作挑最便宜的模型)与服务端缓存(cache: true 时相同调用直接命中、不花 token)。
五、评测方法批判:这些数字该怎么打折看
需要提醒的是,上表是 Browserbase 官方在自家首页发布的对比,并非第三方独立评测,有几个天然的偏向:
- 对比对象并不对等:Playwright 本身不是 Agent,不调用大模型。所谓”Stagehand vs Playwright”测的其实是”带模型裁剪与扩展架构的 Stagehand” vs “裸 Playwright 脚本”,把模型往返、上下文裁剪的收益都算进了 Stagehand 一侧。
- “same tasks, same model”是自述口径:测试任务集、模型版本、网络环境均未公开细表,97ms vs 364ms 这种单次延迟数字在真实公网下波动会很大。
- token 数是自报:7.4k vs 35.7k 取决于被裁剪页面的复杂度,长尾复杂页面上差距会缩小。
- “快 2 倍”特指 Browserbase 托管环境,本地
localBrowser运行并不享受服务器侧缓存与托管优化。
换句话说,方向(Agent 专用抽象确实能省 token、降延迟)可信,但具体倍数应视为厂商营销口径,落地前最好用自己的任务集复测。
六、优势与局限
优势: 一是抽象贴合 Agent 工作流,observe 返回真选择器、凭据不进模型,是认真考虑了安全的设计;二是自修复对”页面改版”这类自动化头号痛点有针对性;三是一套 SDK 同时给 TS/Python/Go,且能在本地(cookie 持久化在 ./browser-data)与 Browserbase 托管之间无缝切换;四是 MIT 开源、不绑定单一模型,可接 OpenAI 等任意兼容接口。
局限: 它本身不是模型,跑起来仍需自备 LLM API Key,成本随多轮动作累积;自修复只作用于 act/observe/extract 自然语言原语,你手写的裸 Playwright locator 不会被自动修复;官方速度与 token 数据为厂商自测;深度集成(CrewAI、Mastra、Vercel AI SDK、Claude Code、Codex)虽已铺开,但版本迭代很快(仓库显示已 80+ release、86 位贡献者),API 仍可能变动。
七、谁该关注
- 在做浏览器 Agent / RPA / 数据抽取的团队:需要自然语言操作 + 结构化抽取,且在意 token 成本,Stagehand 值得优先评估;
- 已有 Playwright 资产的团队:可以从
Migrate from Playwright路径渐进迁移,而不是推倒重来; - 想要托管免运维的团队:直接用 Browserbase 的 MCP server,在 Cursor、Codex 等 MCP 客户端里挂载 navigate/act/observe/extract,连本地浏览器都不用起。
如果你的场景只是写稳定的回归测试,Playwright 仍然更成熟;Stagehand 的真正主场是”让 LLM 自主面对一个它没见过的网站”。