Shortest:用一句英文写 E2E 测试的 AI 框架
阅读时间: 大约 9 分钟
Shortest:用一句英文写 E2E 测试的 AI 框架
Shortest 来自 antiwork(即 Sahil Lavingia 创办的 Urth/Gumroad 团队),以 MIT 协议开源,定位是”AI-powered natural language end-to-end testing framework”。它和 Midscene 同属”用自然语言写 E2E 测试”这一波,但路线不同:Shortest 构建在 Playwright 之上、驱动 Anthropic Claude 来执行浏览器操作,强调测试用例读起来就是一句英文。本文基于其 GitHub 仓库一手资料,拆解它的设计取舍与局限。
一、背景:E2E 测试的”最后一公里”
写 E2E 测试最烦的不是写代码,而是描述”点哪里、填什么、最后看到什么”。传统 Playwright 需要你精确写出选择器和断言语句,既啰嗦又易随改版失效。Shortest 的主张是:把”怎么操作浏览器”这部分交给 AI,人只负责用一句话说清”要做什么、期望结果是什么”。
二、是什么:一句话就是一个测试
安装后,测试文件长这样:
import { shortest } from "@antiwork/shortest";

shortest("Login to the app using email and password", {
  username: process.env.GITHUB_USERNAME,
  password: process.env.GITHUB_PASSWORD,
});
shortest(...) 的第一个参数就是一句自然语言描述。配置文件 shortest.config.ts 指定 baseUrl、headless、testPattern,并把 ai.provider 设为 "anthropic"(默认读 ANTHROPIC_API_KEY)。它还支持:
- 测试链式组合:
shortest(["user can login...", "user can modify refund policy"]),并用展开运算符合并可复用流程; - 生命周期钩子:
beforeAll/beforeEach/afterEach/afterAll,用于登录态准备与清理; - API 测试:用自然语言描述
GET /users?active=true的期望响应。
三、关键设计:AI 做探索,代码做断言
Shortest 最值得说的不是”AI 点浏览器”,而是它对断言的处理。它没有让 AI 全权判断成败,而是提供 .after(async ({ page }) => ...) 回调:等 AI 把 UI 流程跑完后,回到确定性代码里做真正的校验——例如从 localStorage 取出 clerk-user,再用 Drizzle 查库、expect(user).toBeDefined()。
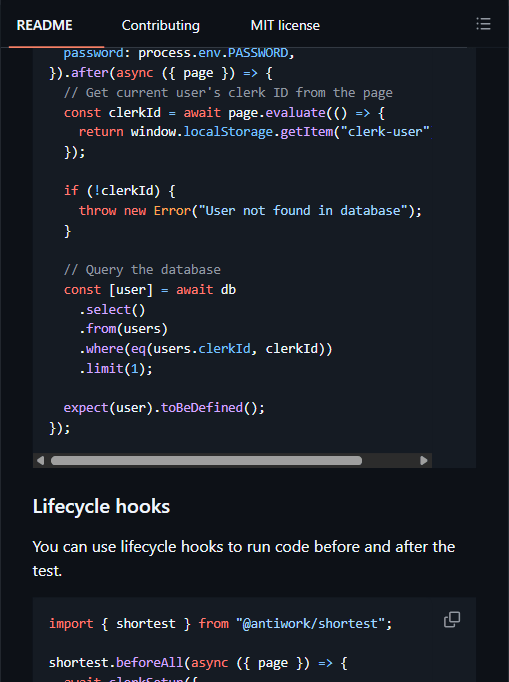
这个分工很克制:模糊、探索性的 UI 操作交给 LLM,精确、可重复的断言交给代码。这避免了”AI 说它成功了但其实没成功”的常见坑,也是它和纯视觉断言路线(Midscene)的一个重要差异——Shortest 更信任代码断言,把 AI 限定在”操作”侧。
理解 Shortest 的关键,是把它和”纯 AI 测试”区分开。很多同类工具让大模型既操作界面又自己判断成败,结果是 flaky——模型今天说通过、明天说失败。Shortest 把判断权收回到代码手里:自然语言只负责”走完登录、下单、退款这条业务流”,而”数据库里这条订单真的变成已退款了吗”由 .after() 里的 Drizzle 查询和 expect 来拍板。这种”AI 做不确定的探索、代码做确定的断言”的分工,本质上是在 AI 的弹性和测试的刚性之间划了一条线,也是它敢声称可进 CI 的底气。
针对真实登录场景,Shortest 内置了两个常被忽略的能力:一是 GitHub 2FA 登录,通过 GITHUB_TOTP_SECRET + shortest --github-code 生成动态验证码完成两步验证;二是用 Mailosaur 做邮件验证码校验。CI 里以 headless 模式跑,把 Anthropic API Key 放进 secrets 即可。仓库语言 97.3% 为 TypeScript,当前约 12 个 release、29 位贡献者(最新 v0.4.9)。
五、评测方法批判:它没有 benchmark
和 Midscene 不同,Shortest 仓库没有公布任何 Pass@1、成功率或成本数字,所有卖点都是定性描述(“natural language”、“AI-powered”)。这本身就是一个需要注意的信号:
- 效果无法横向比较:它依赖 Claude 的浏览器操作能力,成功率随模型版本波动,但官方没有给出可复现的任务集;
- 强绑定 Anthropic:
ai.provider默认且几乎围绕 Claude 设计,不像 Midscene 那样支持 Qwen/豆包/Gemini 多模型与自托管,成本与可用性都押在一家厂商上; - 每次测试都烧 Claude token:自然语言驱动意味着每一步动作都是一次模型推理,全量 CI 跑下来的 API 费用需要自己估算,官方未给单价参考;
- 自然语言用例天然偏”软”:一句 “login with email and password” 是否成功,最终仍要靠你写的
.after()代码兜底——如果你偷懒不写确定性断言,测试可信度就会打折; - CI 里的非确定性没有被真正消除:即使断言是代码写的,“操作过程”仍由模型自由发挥,同一条用例这次走表单、下次可能走快捷链接,页面稍变就可能在某一步卡住。要在 CI 里稳定,往往还得靠
beforeEach/afterEach固定登录态与重试,这部分工程成本官方没有替你算进去。
六、优势与局限
优势: 一是 API 极简,测试用例接近英文文档,非前端同事也能读;二是”AI 操作 + 代码断言”的分工务实,比纯视觉断言更可靠;三是内置 2FA、邮件验证、CI、生命周期钩子,瞄准的是真实业务登录流而非玩具 demo;四是基于 Playwright,底层浏览器能力成熟。
局限: 仅支持 Anthropic Claude、无自托管选项;无公开 benchmark,成功率与成本需自测;自然语言流程存在非确定性,同一用例多次跑可能走不同路径;项目仍早期(版本号 0.x),API 可能变动。
七、和 Midscene 怎么选
两者都在做”自然语言 E2E”,但侧重不同:Shortest 偏 Web、绑定 Claude、强调代码断言与登录/支付这类业务流;Midscene 偏跨端(移动/桌面)、多模型可自托管、强调视觉断言与 benchmark。如果你的测试主要是 Web 登录与核心业务流、且已在用 Anthropic,Shortest 上手快;如果要测移动端、canvas 或想控制模型成本与可私有化,Midscene 更合适。