Semble:给编码 Agent 做的"省 99% token"代码检索库
阅读时间: 大约 8 分钟
Semble:给编码 Agent 做的”省 99% token”代码检索库
编码 Agent 读代码这件事,过去一年卡在一个两难里:纯靠 grep/ripgrep 定位再整文件读,简单粗暴但极烧 token;纯靠向量语义检索,召回又飘忽不定。Semble(MinishLab 出品)走第三条路——用 tree-sitter 把代码切成语义块,再叠 BM25 词法检索与轻量嵌入做混合排序。本文基于其 GitHub README 与官方基准图分析。
一、它是什么
README 定位:“Fast and Accurate Code Search for Agents”,副标题直接打出 “Uses ~99% fewer tokens than grep+read”。它是一个代码检索库,Agent 用自然语言提问(如 “How is authentication handled?”),它只返回相关的代码片段,而不是让 Agent 去 grep 再读整文件。
关键工程卖点:全 CPU 运行,不需要 API key、GPU 或外部服务。接入方式有三种——MCP Server(让 Agent 直接当工具调)、CLI(写进 AGENTS.md/CLAUDE.md)、或一个独立的 semble-search 子代理;semble install 会自动探测已装的 Claude Code、Codex、OpenCode、Cursor。
uv tool install semble
semble install
二、核心机制:tree-sitter 切块 + 双路召回 + RRF
README 把管线讲得很清楚:
- 代码感知切块:用 tree-sitter 把每个文件拆成函数、类这类语法单元,而不是按行或固定长度硬切;
- 双路召回:
- 语义路:用 MinishLab 自家的 Model2Vec + 代码专用模型
potion-code-16M-v2做轻量嵌入; - 词法路:用 BM25 匹配标识符与 API 名;
- 语义路:用 MinishLab 自家的 Model2Vec + 代码专用模型
- 融合:两路结果用 Reciprocal Rank Fusion(RRF)合并;
- 代码感知重排:包括”符号式查询(如
Foo::bar)给词法路更高权重""定义处(class/def/func)比引用处排得更前""标识符词干匹配(parse config命中parseConfig)""同文件多命中则提升文件分""对测试文件、compat//legacy/shim、.d.ts声明等噪声降权”。
这套设计的核心信念是:语法树天然对应代码的结构边界,返回的片段更完整可用,比靠 embedding 猜语义更可靠。
三、基准数据(官方口径)
官方在 README 给出的测试规模:约 1,250 条查询、跨 63 个仓库、19 种语言。结论(官方称):
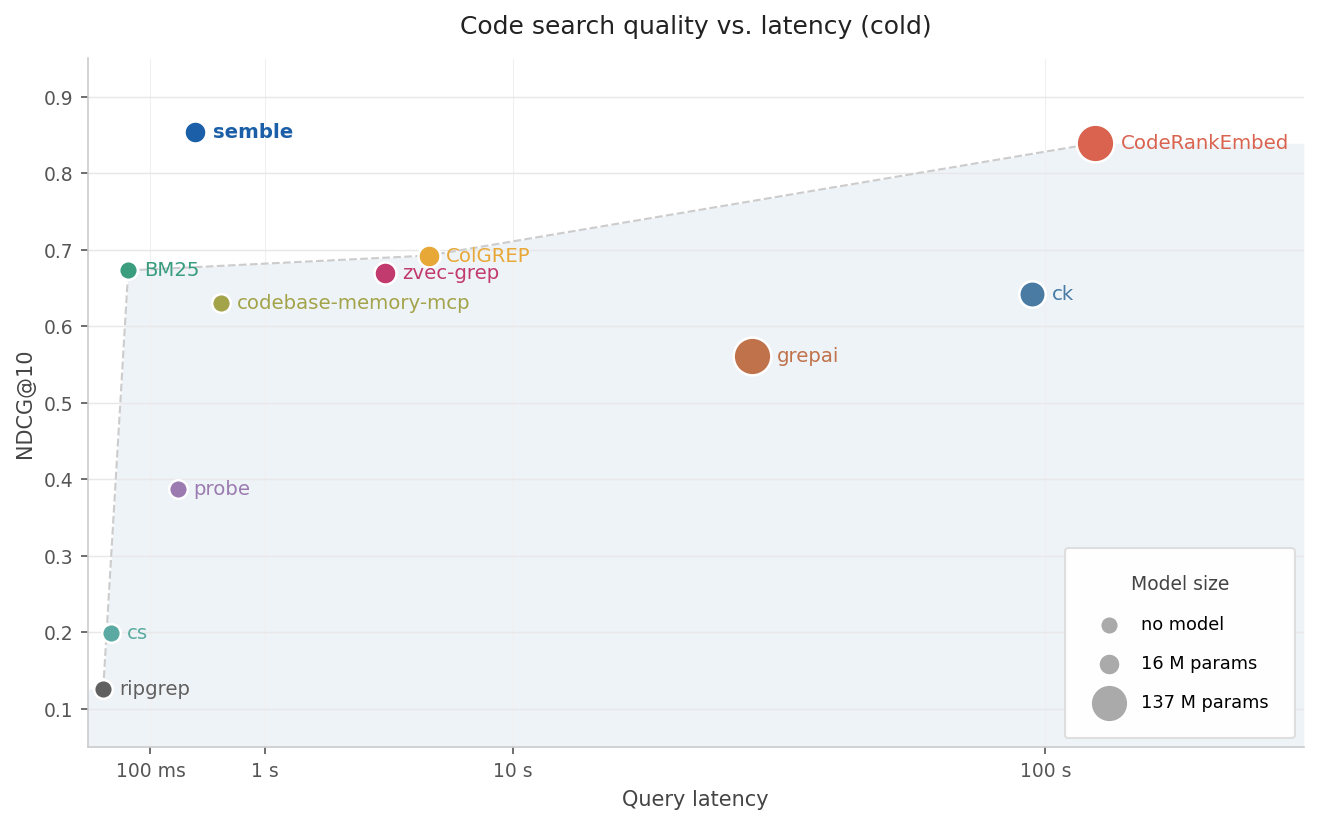
- 检索质量(NDCG@10)追平 137M 参数的 CodeRankEmbed,但索引速度快约 380 倍、查询快约 17 倍;
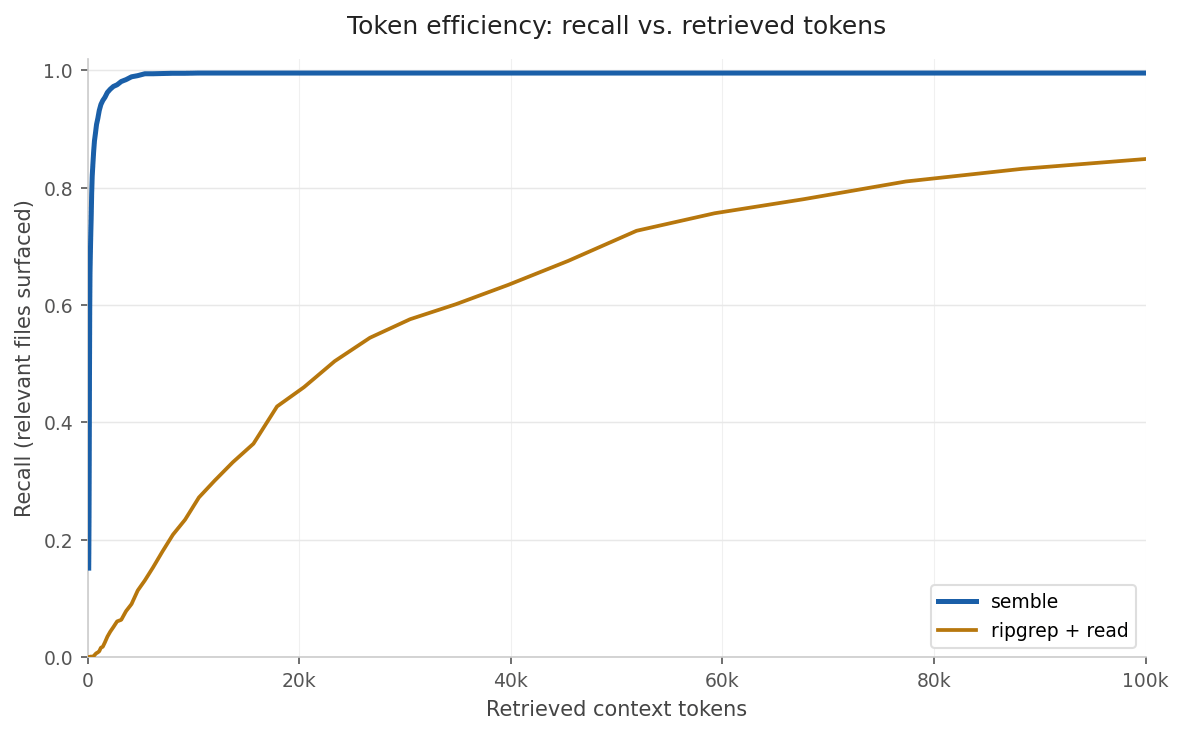
- token 效率:平均少用 99% token,在仅 2k token 时就达到 97% 召回;而 grep+read 需要整整 100k 上下文窗口才能到 85% 召回(即首图)。
四、评测方法的偏向
这些数字漂亮,但要带着方法学的怀疑看:
- 基准是官方自测:63 仓库、19 语言、1,250 查询的集子由作者选定,“relevant files”标注标准由作者定;与 CodeRankEmbed、grep+read 的对比也是作者自己跑的。
- “99% fewer tokens”是等效召回下的平均值:它指的是”达到同一召回水平所需 token”的差距,不是所有查询都省 99%;长尾、跨文件、需要全局理解的问题上,纯检索仍可能不够。
- “matches CodeRankEmbed quality”是单点结论:在这个特定基准上追平,不代表在你的仓库、你的查询分布上同样追平。
- 冷启动 vs 增量未展开:speed 图标题带 “cold”,首次索引成本已含在内;日常增量更新的开销 README 未细述。
五、口径偏差与局限
- 数字均为官方口径:380x/17x/99%/250ms/1.5ms 等,需在官方 benchmarks/README 的逐语言结果与消融实验中自行复核;项目库转述的”索引平均 250ms、单次查询 1.5ms”与 README 正文的”端到端 < 1 秒”是同一件事的不同表述量级。
- 重排信号是启发式:定义提升、词干匹配、噪声降权都靠规则,对非主流语言或非常规命名风格,增益可能打折扣。
- 仍需嵌入模型:虽然是 CPU 轻量模型(16M 级),但语义路依赖它;离线、无模型文件的极轻场景未必划算。
- 它是检索,不是理解:返回相关片段不等于 Agent 理解了全局架构——超大重构仍需更广上下文。
六、适用 / 不适用
适合:
- 用 Claude Code/Cursor/Codex 等在大仓库里频繁定位代码、被”grep 一堆、读一堆”烧 token 的团队;
- 想在本地/CPU 离线环境做代码检索、不愿依赖托管向量库的人;
- 愿意把检索层接成 MCP 工具的 Agent 工作流。
不适合:
- 仓库很小、直接全量塞进上下文也无所谓的项目;
- 需要跨仓库、跨服务全局架构推理的任务(检索库给的是片段,不是全貌)。
七、它意味着什么
Semble 验证了一个方向:在”向量 vs grep”的二元对立之外,用语法树做结构化切块 + 混合检索,能在 CPU 上同时拿到质量与效率。如果这个数字经得起独立复现,它会成为编码 Agent 检索层的一个务实默认选项——把省下来的 token 预算,留给真正需要模型推理的部分。