sem:把 Git diff 从"行"升级到"函数",给 Agent 看的语义变更
阅读时间: 大约 10 分钟
sem:把 Git diff 从”行”升级到”函数”,给 Agent 看的语义变更
sem 是 Ataraxy Labs 用 Rust 写的命令行工具,口号是”Know what changed. Semantic understanding on top of Git. Diff, blame, impact, log. Functions, not lines.”——它不再按行对比代码改动,而是从函数、类、方法这类语义实体的层面理解一次提交。据 Koala 项目库点评:传统行 diff 是给人看的,但在 AI 写代码的时代,agent 需要的是结构化、语义化的变更信息。本文基于其官网与官方 benchmark 页面梳理,并重点审视那个”2.3 倍”的说法。
一、同一个提交,两种视角
官网首页用同一个 src/auth/login.ts 提交做对比。左边是 git diff:满屏 +/- 行,新加的 validateToken、改写的 authenticateUser、删掉的 legacyAuth 混在一块。右边是 sem diff:
┌─ src/auth/login.ts ────────────────
│  ⊕ function  validateToken    [added]
│  ∆ function  authenticateUser [modified]
│  ⊖ function  legacyAuth       [deleted]
└────────────────────────────────────
3 entities changed across 1 file这就是它的核心价值主张:直接告诉你”哪几个函数被新增/修改/删除了”,而不是让你从 hunks 里自己脑补。
二、六个子命令,一个二进制
官网称”Six commands. One binary. No config. No plugins.”:
| 命令 | 回答的问题 | 输出示例(官方) |
|---|---|---|
sem diff | 改了什么? | 实体级 diff,带重命名检测、结构哈希、词内高亮 |
sem blame | 谁改的? | 每个函数/类/方法最后一次触碰它的提交 |
sem impact | 会炸什么? | 跨文件依赖图:依赖谁、被谁用、受影响测试;示例”42 entities transitively affected” |
sem log | 怎么演化的? | 单个实体的 Git 历史 |
sem entities | 路径下有什么? | 列出所有函数/类/方法/类型及行号范围 |
sem context | 给 AI 的智能上下文 | 按 token 预算打包实体+依赖+被依赖方 |
其中 sem context 很贴 Agent 场景:官方示例给 authenticateUser 设 8000 token 预算,自动装下目标实体(约 705 tokens)、它的依赖(约 256)与被依赖方(约 812)。所有命令都支持 --json 输出机器可读结果。
三、覆盖面与接入
官网标称的关键数字(均来自其官网首页):
- 26 种语言:TypeScript、JavaScript、Python、Go、Rust、Java、C/C++/C#、Ruby、PHP、Swift、Kotlin、Elixir、Bash、HCL、Fortran、Vue、Svelte、Dart、Perl、OCaml、Scala、Zig 等;
- 5 种数据格式:JSON、YAML、TOML、CSV、Markdown;
- 典型 diff 约 8ms;
- 0 配置;官网称下载量 4,000+。
接入方式是 brew install sem-cli 后跑 sem setup——它会创建 wrapper 脚本、写 git config --global diff.external = sem、装 pre-commit hook,此后在任何仓库跑 git diff 自动变成 sem diff;sem unsetup 可还原。也支持 cargo install --git ...。
四、“Agent 准确率高 2.3 倍”是怎么测的
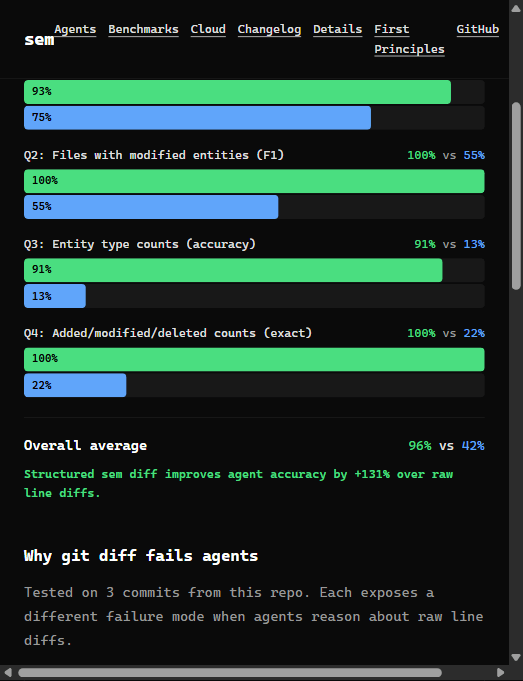
这是官网最抓眼球的宣称,必须拆开看。官方在 agents.html 给出了方法:用 Claude Sonnet 4.5(temperature 0)回答关于代码变更的问题,一组喂 sem diff JSON,一组喂原始 git diff,对照 ground truth 打分。样本是 3 个 commit(小/中/大各一)。
| 问题 | sem diff | 原始 git diff |
|---|---|---|
| Q1 列出新增函数(F1) | 93% | 75% |
| Q2 含被改实体的文件(F1) | 100% | 55% |
| Q3 实体类型计数 | 91% | 13% |
| Q4 新增/修改/删除计数(精确) | 100% | 22% |
| 总体平均 | 96% | 42% |
官方据此称”structured sem diff improves agent accuracy by +131%“,也就是约 96%/42%≈2.3 倍。它还解释了行 diff 为何失败:模型把 + 行数当成实体数(一个 commit 报 238 vs 真实 32;Rust 重写报 1122 vs 259);数文件而不是数实体;分不清”新增”与”修改”(precision 掉到 55.6%);对 JSON/YAML 配置变更”失明”(漏掉 package.json,recall 66.7%)。
五、口径与局限:评测方法本身的偏向
这一节是重点,全部来自官方 benchmark 页自己的披露:
- 样本极小:3 个 commit × 4 个问题 × 2 个工具 = 只有 24 次 API 调用。这是演示级样本,不是大规模统计。
- 单一模型、单一温度:只测了 Claude Sonnet 4.5、temperature 0。换个模型、换个温度,数字未必复现。
- 自家仓库、自命题、自打分:测试 commit 全部来自 sem 自己的仓库,问题与 ground truth 由作者定义——存在明显的”既当运动员又当裁判”倾向。
- 为公平做过的裁剪:官方说”content fields stripped from sem JSON for fair comparison”——即抹掉了 sem JSON 里的源码内容后才比,这是有意控制变量,但也意味着这不是你实际使用时的完整负载。
- 大 diff 上两者都崩:在那个 3905 行的 Rust 重写 commit 上,git diff 被 100KB 截断,模型只找到 25/67 个新增函数(recall 37%);sem 的精简 JSON 虽让模型看全了 278 个实体,也只抽出 43/67(recall 64%)。官方坦承:大 diff 是注意力极限问题,换格式也救不回来。
- “8ms""4000+ 下载”均为官网自报,未见第三方基准或包管理器数据交叉验证。
六、客观分析:优势与适合人群
优势: 把静态分析得到的”实体级变更”结构化成 JSON,正好补上 agent 处理行 diff 时的本体缺失(不知道什么是函数、分不清新增与修改);--json + sem context 的 token 预算打包,是直接为 Agent 工作流设计的;零配置接入 git diff 的体验顺滑。
适合: 在做代码 review agent、自动化 changelog、影响面分析的团队;需要快速回答”这次提交动了哪些函数”的人。
注意: “2.3 倍”是自家小样本 demo 结论,生产采用前应在自己的仓库、自己的 agent 栈上复测;它是 git diff 的补充视角,不能完全替代人看代码。