rqlite:用 Raft 把 SQLite 变成高可用分布式数据库
阅读时间: 大约 10 分钟
rqlite:用 Raft 把 SQLite 变成高可用分布式数据库
「Koala 聊开源」在介绍 Cloudflare D1 时顺带提到了一个定位相似的开源项目 rqlite:一个轻量级分布式关系数据库,底层存储引擎就是 SQLite。如果说 Litestream 是给 SQLite 加了一个「异步异地备份」的旁挂进程,rqlite 走的是另一条路——用 Raft 共识把多个 SQLite 节点强一致地复制起来,直接对外提供高可用的关系数据服务。本文基于其 GitHub 仓库与 rqlite.io 官方文档,拆解它的机制、能力与边界。
一、背景:etcd 的可靠性 + SQL 的建模能力
rqlite 官方给自己的定位非常形象:「think etcd, but with relational modeling available」——你可以把它当成一个带关系建模能力的 etcd。也就是说,它解决的不是「海量分析」,而是需要高可用、需要存关键配置/业务状态、又想要 SQL 查询能力的场景:云上去做弹性服务的可靠存储,或边缘设备上跑可靠应用。
它要替代的痛点组合是:
- 直接用 SQLite:简单,但单点,挂了就没了;
- 用 etcd/Consul:强一致高可用,但只有 KV 模型,不擅长复杂查询;
- 用 Postgres 主从:功能全,但运维重、资源开销大。
rqlite 想用「SQLite 的 SQL + Raft 的高可用 + 单二进制零依赖」把这三者的好处捏在一起。
二、是什么
官方描述:一个「功能丰富、健壮、容错的分布式关系数据库,构建在 SQLite 之上」,轻量、对开发者友好、极易运维。上手极简——一条命令起一个节点:
docker run -p 4001:4001 rqlite/rqlite随后通过纯 HTTP/JSON 读写:
curl -XPOST 'localhost:4001/db/execute?pretty' -H 'Content-Type: application/json' \
  -d '[ "CREATE TABLE foo (id INTEGER NOT NULL PRIMARY KEY, name TEXT)",
        "INSERT INTO foo(id, name) VALUES(1, \"fiona\")" ]'
curl -G 'localhost:4001/db/query?pretty' --data-urlencode 'q=SELECT * FROM foo'
官方强调「No extra services to install or manage」:在三台机器上跑这个二进制,rqlite 会自己组成集群;任意一个节点宕机,数据库不中断。
三、技术机制:Raft 复制 + 每节点一个 SQLite
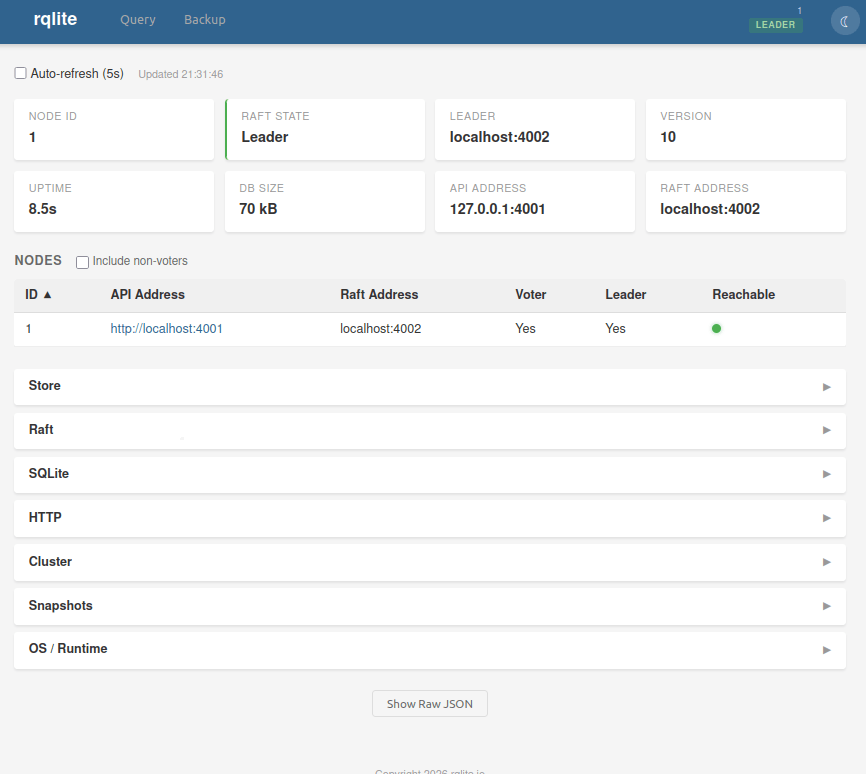
其架构可以概括为「每个节点内嵌一个 SQLite,节点间用 Raft 复制写请求日志」:
- 底层仍是 SQLite:完整 SQL 能力来自 SQLite,包括全文检索(FTS)、JSON 支持;还能加载 SQLite 扩展,例如向量检索(Vector Search)与加密(Crypto);
- Raft 做共识:写入不是各自直接落本地 SQLite,而是作为日志条目通过 Raft 复制到多数派(quorum)后才提交。控制台里直接可见 Raft State(Leader / Follower)、Voter 标记与节点的 Reachable 状态,这正是 Raft 集群的运行时画像;
- 动态集群:支持通过 Kubernetes、Docker Compose、Consul、etcd 或 DNS 自动发现并组建集群;
- 原子请求:单个 API 请求里的多条 SQL 可作为一个原子事务执行;
- CDC:可把数据库变更流式输出到外部系统。
读一致性与持久化是可调的(Tunable Consistency):官方允许你按应用需要权衡读一致性级别与持久化强度,而不是一刀切。备份方面支持热备份,并可自动备份到 AWS S3、MinIO、Google Cloud,也能直接从 SQLite 文件或云存储恢复。
四、关键事实(官方口径)
| 维度 | 内容 |
|---|---|
| 底层引擎 | SQLite(完整 SQL、FTS、JSON、可加载扩展) |
| 共识协议 | Raft(Leader/Voter/多数派提交) |
| 对外接口 | HTTP/JSON API,内置控制台、CLI 与客户端库 |
| 部署 | 单一二进制,无外部依赖;Linux/macOS(brew)/Windows/Docker/K8s |
| 高可用 | 多节点全复制,任一节点宕机不影响集群 |
| 集群发现 | K8s / Docker Compose / Consul / etcd / DNS |
| 备份恢复 | 热备份至 S3/MinIO/GCS,可从 SQLite/云存储恢复 |
| 安全 | TLS 端到端加密,丰富的认证/授权 |
| 一致性 | 读一致性与持久化级别可调 |
| Stars / 协议 | 约 18K Stars(官网导航栏),MIT 协议 |
五、评测方法与口径批判
rqlite 官方没有在 README/首页给出 TPS、延迟、线性扩展比等量化 benchmark,其卖点集中在「易运维、高可用、SQL 能力」。阅读时需注意:
- 它是共识优先的架构:每次写都要经 Raft 多数派确认,写入延迟天然高于单节点 SQLite,把它当成「更快的 SQLite」是误读;
- 「任意节点宕机不中断」以 N/2+1 多数派存活为前提,同时宕机超过半数节点仍会不可写;
- 「完整 SQL」指 SQLite 方言,不支持服务端 Postgres 那种存储过程、复杂复制拓扑与大规模并行;
- 「像 etcd 但有关系建模」并不意味着能替代 TiDB/CockroachDB 这类面向水平扩展的分布式 SQL——它的定位是小而稳的关键状态库,而非海量数据分片。
六、适用与不适用场景
适合:
- 需要高可用、但数据量中等的配置中心、业务状态、元数据服务;
- 边缘/多云环境,想要单二进制、低运维成本的强一致数据层;
- 已经熟悉 SQL,不想上 Postgres 主从那一整套重型栈;
- 想要 SQLite 的易用性,又要解决单点故障。
不适合:
- 写入吞吐要求极高、对 Raft 多数派延迟敏感的场景;
- 单表超大规模、需要水平分片与弹性扩展的业务;
- 需要 Postgres 高级特性(复杂存储过程、流式复制生态)的系统。
七、客观分析:优势与局限
优势:
- 运维极简:单二进制、HTTP API、自动集群,几乎零额外依赖;
- 真高可用:Raft 多数派复制,节点故障不中断服务;
- SQL 生态:复用 SQLite 的 SQL、FTS、JSON 与扩展(含向量);
- 灵活一致:读写一致性/持久化可调,备份与 CDC 齐全。
局限:
- 写性能受共识约束:多节点写入要过 Raft,吞吐有限;
- 不适合超大规模:不是为海量分片设计的分布式 SQL;
- SQL 方言天花板:受 SQLite 能力上限约束;
- 多数派前提:集群规模通常 3/5 节点,过半节点同时故障仍会停写。
八、它意味着什么
rqlite 代表了 SQLite 生态的另一个方向:不满足于「单文件 + 备份」,而是直接用 Raft 把 SQLite 拉进高可用分布式数据库的行列。对中小团队来说,它提供了一个比 Postgres 主从轻得多、又比裸 SQLite 可靠得多的选择——尤其适合那些「数据不是海量,但绝不能丢、绝不能停」的关键状态。它不是要替代分布式 SQL 数据库,而是把「小而稳」这一档做到了极致易用。