Redka:用 SQLite/PostgreSQL 重新实现的 Redis 兼容服务器
阅读时间: 大约 10 分钟
Redka:用 SQLite/PostgreSQL 重新实现的 Redis 兼容服务器
很多团队都有过这样的体验:生产环境用 Redis 做缓存,本地开发或跑集成测试时却要为”再起一个 Redis”头疼;或者你已经把所有数据都放在 PostgreSQL 里,却为了几个 list/set 又额外引入一个内存数据库。Redka 正是冲着这个缝隙来的——它把 Redis 的核心数据结构用 SQL 重新实现了一遍,后端是 SQLite 或 PostgreSQL,前端却说一口标准的 Redis RESP 协议。本文基于作者 Anton Zhiyanov 的官方博客与 GitHub 仓库,拆解它到底是什么、快不快,以及它自己承认的边界。
一、动机:把 Redis 的 API 接到关系库上
作者在博客里写得很坦白:他既是 Redis 的粉丝(欣赏它”超越 get/set、直接给复杂数据结构一个方便 API”的思路),也是关系数据库和 SQL 的粉丝(“从 1970 年代到今天,久经考验”)。于是他做了个实验:用关系后端把 Redis 重新实现一遍——先接 SQLite,后来(2025 年 7 月)又加了 PostgreSQL。
它带来的直接好处是:
- 数据不必塞进内存:Redis 是纯内存库,Redka 的数据落在磁盘上的 SQLite/Postgres;
- ACID 事务:复用关系库的事务语义,而不是 Redis 那种弱事务;
- 能用 SQL 直接分析:数据以普通表 + 视图存在,DBA 可以直接写 SQL 报表;
- 不单独起服务也行:可以作为 Go 库在进程内调用。
二、架构:两层壳 + 一个关系库
Redka 用 Go 写成,对外有两种形态:独立的 Redis 兼容服务器,或者进程内 Go module。作者博客里的分层图很直观:
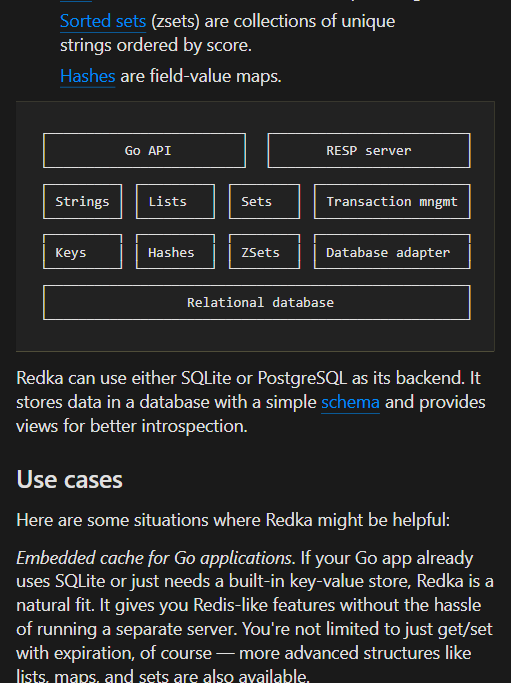
请求路径是:任意 Redis 客户端(redis-cli、redis-py、go-redis 等)说 RESP 协议,Redka 服务器把它翻译成 SQL,落到后端的 SQLite 或 Postgres。它的 RESP 服务器实现基于 tidwall 的 Redcon 库。
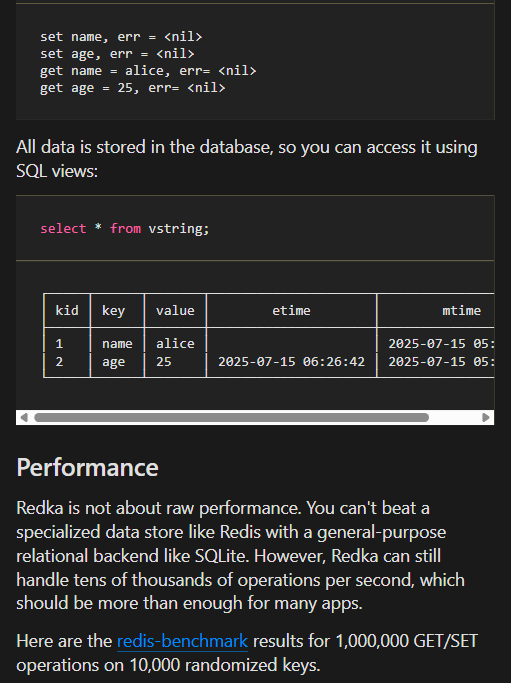
数据落库的 schema 非常朴素:一张 rkey 主表(存 key、类型、过期时间 etime、修改时间 mtime、元素个数 len),再加五张子表 rstring / rlist / rset / rhash / rzset,分别对应五类数据结构。为了方便人看,又对外暴露了 vkey / vstring / vlist / vset / vhash / vzset 等视图——你可以直接 select * from vstring 像查表一样看 Redis 数据。
三、命令覆盖:只有五类核心结构
Redka 明确只实现了 Redis 的五类核心数据结构:Strings、Lists、Sets、Hashes、Sorted Sets(zsets),外加键管理、服务器/连接管理和事务命令。作者自己在博客里列举 Redis 的丰富生态时提到了 streams、bloom filters 等——这些 Redka 都没有。也就是说,它不是”Redis 的完全克隆”,而是把最常用的那一半搬到了 SQL 上。
四、官方性能数据
作者用标准 redis-benchmark 做了对比,环境是 Apple M1(8 核)/ 16GB 内存,10 条并发连接、10000 个随机键、压测 GET/SET:
| 后端 | SET (ops/s) | SET p50 | GET (ops/s) | GET p50 |
|---|---|---|---|---|
| Redis(关闭 AOF) | 133,262 | 0.055 ms | 139,217 | 0.055 ms |
| Redka(SQLite,纯内存) | 36,188 | 0.167 ms | 104,406 | 0.063 ms |
| Redka(SQLite,落盘) | 26,774 | 0.215 ms | 103,093 | 0.063 ms |
| Redka(PostgreSQL) | 11,942 | 0.775 ms | 25,767 | 0.359 ms |
测试时 SQLite 开了 WAL、synchronous=NORMAL、temp_store=MEMORY、mmap_size=256MB;Postgres 也调过 shared_buffers、effective_cache_size 等参数。
五、评测方法批判:数字该怎么读
这组数据是作者自测,口径需要仔细看:
- 只压了 GET/SET(字符串),这是 Redis 最简单、Redka 翻译成本最低的路径。列表、集合、有序集合这些 Redis 真正的杀手级结构没有出现在 benchmark 里——而这些操作恰恰要多表读写,性能折损大概率比字符串大;
- Postgres 只跑了 10 万请求(其他都是 100 万),且走的是网络连接,和本地文件型 SQLite 不在一个维度;
- Redis 一侧关闭了 AOF(
--appendonly no),是”最薄”的 Redis;开了持久化后 Redis 自己的写性能也会下降,对比会更接近一些; - 有意思的是 GET 性能 Redka-SQLite 能到 Redis 的约 75%(103k vs 139k),因为读大多命中 SQLite 缓存;但 SET 只有 Redis 的约 1/5(落盘 26.8k vs 133k),写放大和事务开销是主因。
作者自己的总结很诚实:“Redka 不追求原始性能,你不可能用 SQLite 这种通用关系库打败 Redis 这种专用存储”,但”每秒几万操作,对很多应用已经够了”。
六、官方自己承认的局限
这一节直接来自 README 和博客,不是我们挑刺:
- 项目处于维护模式(maintenance mode),明确说不再计划加新功能。README 原文:“It’s currently in maintenance mode, and no new features are planned.”;
- 定位仅限”测试与非关键生产”:原文是”stable and ready to use for testing and non-critical production scenarios”;
- 这是一个一人项目(作者致谢里写”mostly a one-man project”),长期维护与响应速度要打个问号;
- 只覆盖五类核心结构,streams、pub/sub、Lua 脚本、集群、分片等 Redis 能力一概没有。
七、适用与不适用
适合:
- Go 应用的嵌入式缓存:本来就用 SQLite,想要 Redis 式的 list/set/hash,又不想额外起进程;
- 轻量测试环境:内存模式跑 Redka,替代 Redis testcontainers,每个测试用例完全隔离;
- Postgres 优先的团队:所有数据都在 Postgres,连 Redis 式结构也想放进同一个事务和备份体系里。
不适合:
- 高吞吐线上缓存:SET 只有 Redis 的零头, Pub/Sub、streams、Lua 都没有;
- 需要 Redis 完整协议兼容性的场景(脚本、集群、过期事件通知等);
- 期待项目持续加功能的团队——作者已经明示维护模式。
一句话:Redka 的价值不是”替代 Redis”,而是”当你其实不需要一个独立的内存数据库时,用已有的关系库顺手拿到 Redis 的 API”。