Qwen3-Coder:阿里通义开源的「最像 Agent」的代码大模型
阅读时间: 大约 10 分钟
Qwen3-Coder:阿里通义开源的「最像 Agent」的代码大模型
2026 年,代码大模型赛道进入「Agentic Coding」阶段——比的不再只是单行补全,而是能不能像 Claude Code 那样自主读仓库、调工具、改文件、跑测试。阿里云通义千问团队在这一节点开源了 Qwen3-Coder,并自称是「迄今为止最具 Agent 能力的代码模型」。本文基于其 GitHub 仓库(QwenLM/Qwen3-Coder)的一手 README 与技术报告信息,梳理它的型号矩阵、能力口径与需要注意的争议。
一、型号矩阵:一个系列三档
Qwen3-Coder 不是单一模型,而是覆盖不同部署规模的一族:
| 型号 | 类型 / 激活参数 | 上下文 | 定位 |
|---|---|---|---|
| Qwen3-Coder-480B-A35B-Instruct | MoE,总 480B / 激活 35B | 256K | 旗舰,对标闭源 |
| Qwen3-Coder-30B-A3B-Instruct | MoE,总 30B / 激活 3B | 256K | 小档、自部署友好 |
| Qwen3-Coder-Next | 基于 Qwen3-Next-80B-A3B-Base,混合注意力 + MoE | 256K | 面向编码 Agent 与本地开发 |
| 上述各档的 FP8 / GGUF 变体 | 量化版 | 256K | 本地 / 低成本推理 |
其中 Qwen3-Coder-Next 是这一代的技术焦点:它构建在「混合注意力 + MoE」的新架构上,并在大规模「可执行任务合成、环境交互、强化学习」上做了规模化的 Agent 训练,目标是用显著更低的推理成本拿到强编码与 Agent 能力。其技术报告为 arXiv:2603.00729(Qwen3-Coder-Next Technical Report)。
二、关键能力:长上下文、多语言、FIM、非思考模式
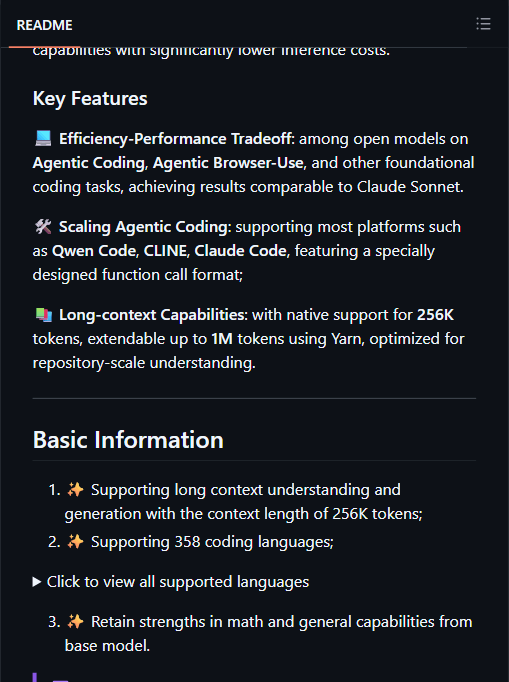
官方列出的硬指标包括:
- 长上下文:原生支持 256K tokens,并可通过 YARN 技术扩展到 1M tokens,针对「仓库级理解」优化;
- 语言覆盖:支持 358 种编程语言,并保留基座模型在数学与通用能力上的强项;
- Fill-in-the-middle(FIM):每个版本都支持代码填空,使用标准的
<|fim_prefix|>...<|fim_suffix|>...<|fim_middle|>模板; - 非思考模式:这些 instruct 模型只跑非思考模式,输出不产生
<think>块,也不再需要显式设置enable_thinking=False——对编码 Agent 来说,这意味着更短、更可控的输出; - Agent 平台兼容:原生支持 Qwen Code(团队 fork Gemini CLI 而来)、CLINE、Claude Code,并专门设计了一套 function call 格式。
需要提醒的工程细节:Qwen3-Coder 的函数调用依赖团队在 SGLang 与 vLLM 里提供的新 tool parser;同时 special token 及其 id 都有更新,必须使用配套的新 tokenizer,否则 function calling 会出问题。
三、性能口径:SWE-Bench 69.6% 与「媲美 Claude Sonnet」
据 Koala 项目库记载,Qwen3-Coder 在 SWE-Bench 上达到 69.6% 的解决率,官方宣称在 Agentic Coding、Agentic Browser-Use 等基础编码任务上达到「与 Claude Sonnet 相当」的水平。这里要做口径区分:
- 可引用的数字:SWE-Bench 69.6%——这是一个具体基准解决率;
- 厂商口径:「comparable to Claude Sonnet」「most agentic code model to date」属于相对评价,README 未给出逐项对照表;
- 部署前提:要复现这些数字,需要使用团队指定的 SGLang/vLLM tool parser 与新 tokenizer,否则本地跑出来的 function call 表现可能明显打折。
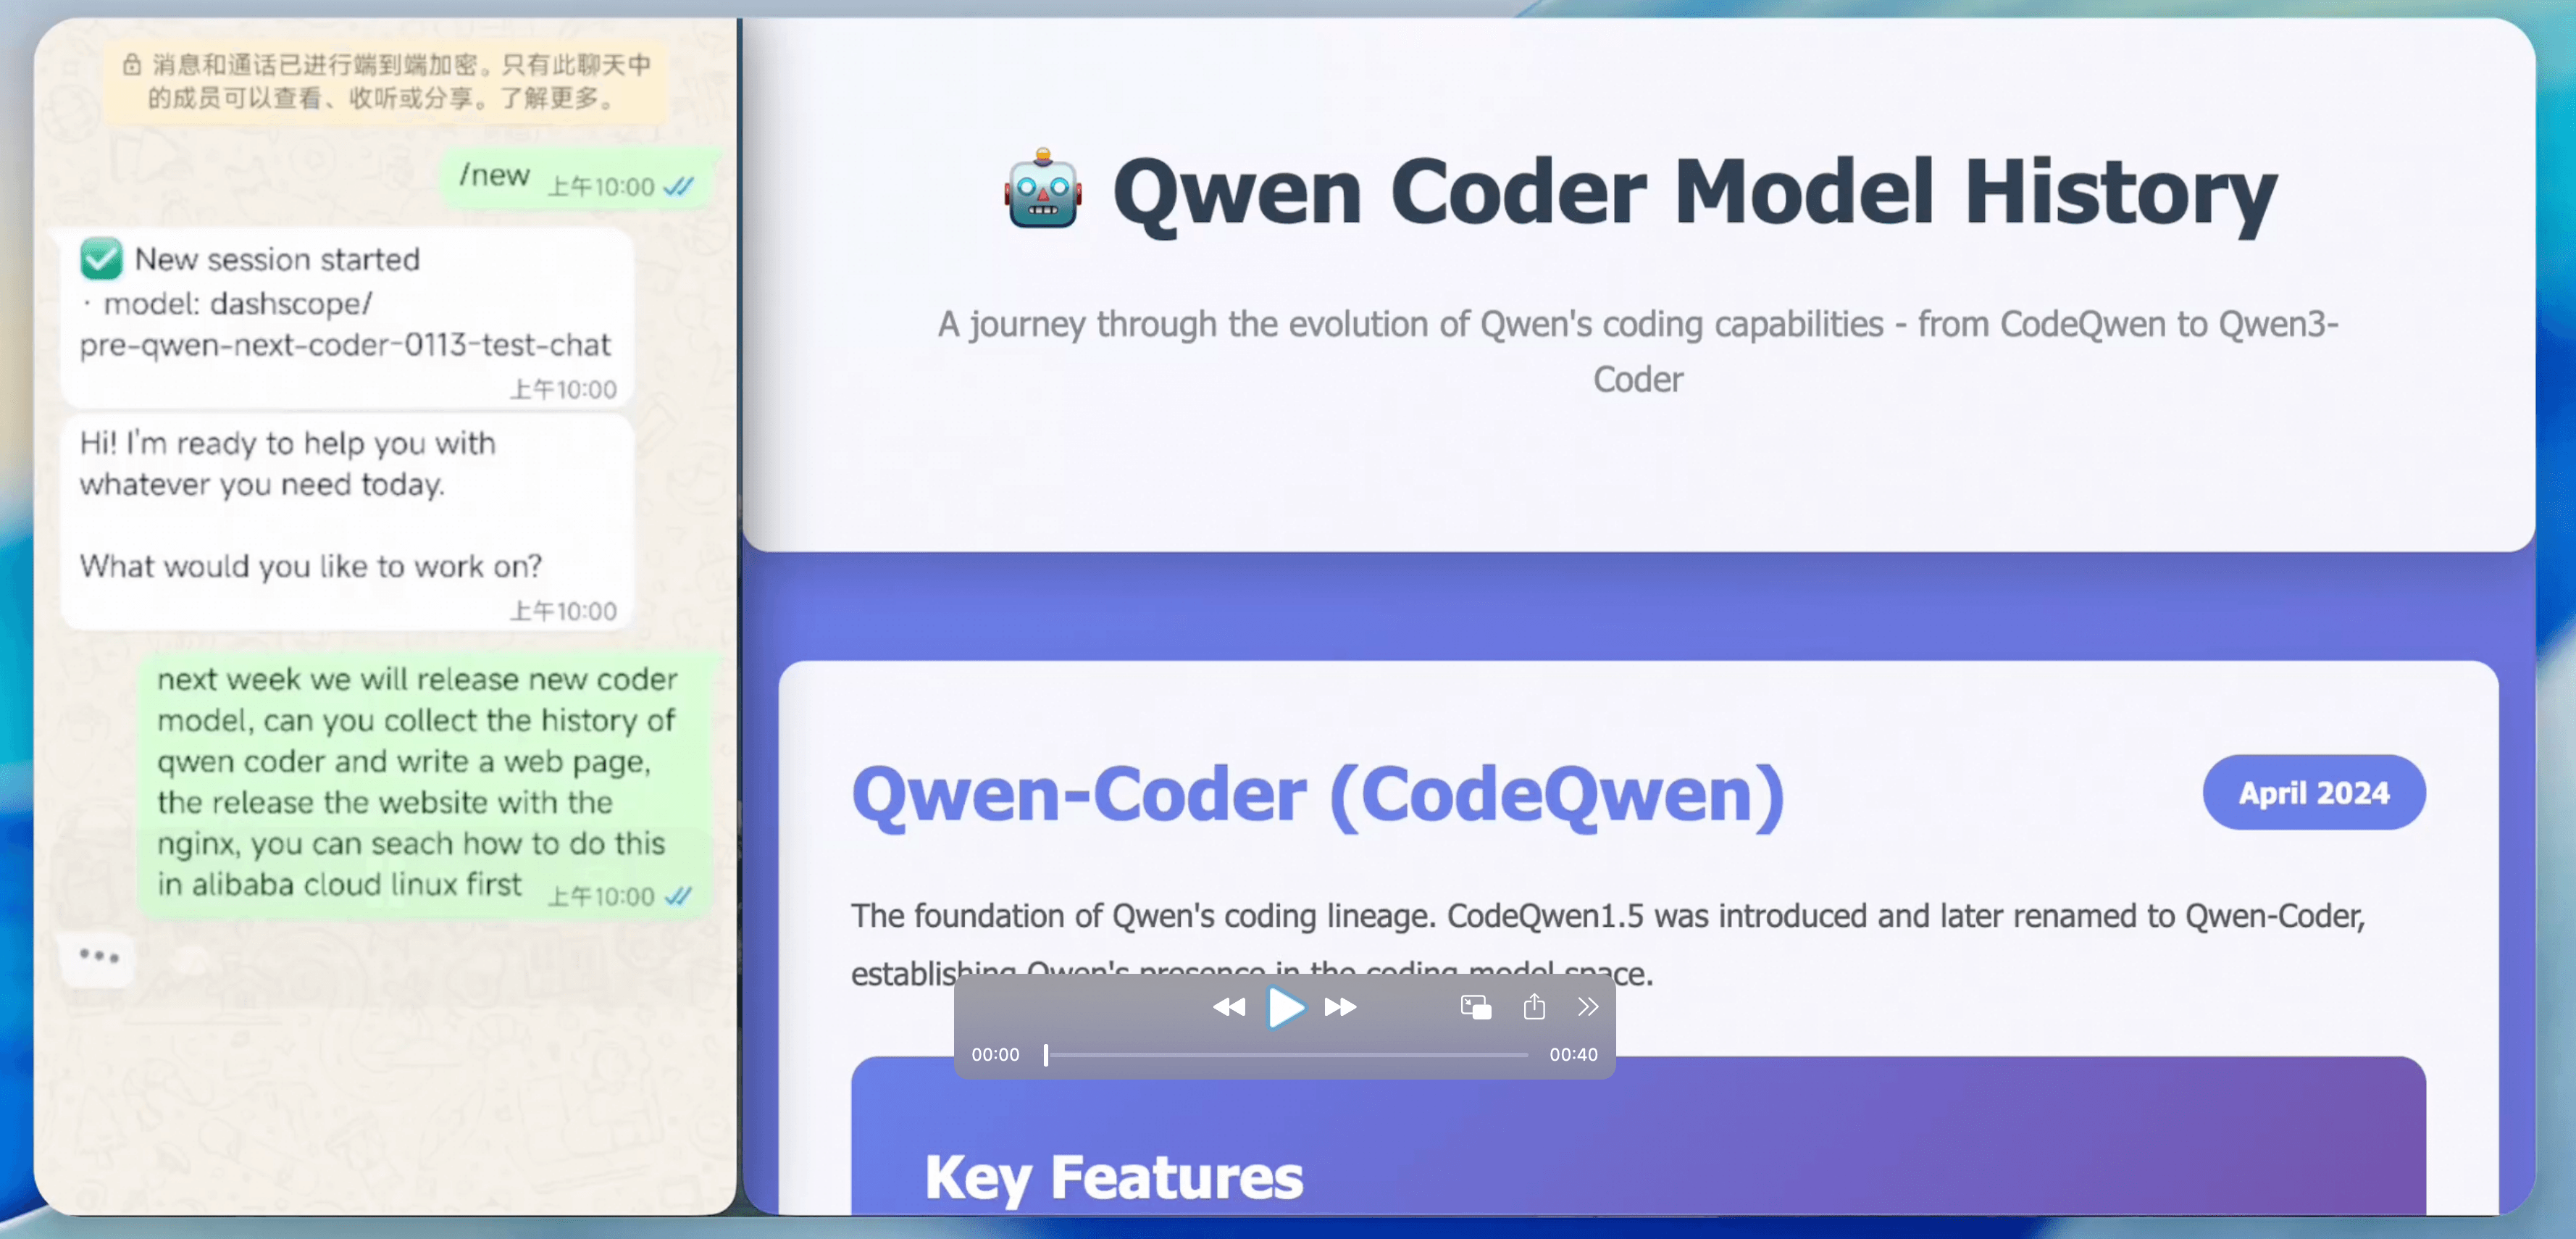
官方在 README 里演示了多个真实 Agentic 用例:用 OpenClaw 发布网站、用 Qwen Code 整理桌面、用 Claude Code 做「植物大战僵尸」、用 Cline 生成声音 ASCII 艺术、用 Browser Use Agent 做 vibe checking、用 Qwen Chat Web Dev 做跑酷游戏——这些例子主要展示「端到端把一个小项目做出来」的能力,而非标准基准。
四、争议:模型之外的 API 定价
Koala 项目库特别提到,Qwen3-Coder 发布后「因阿里云 API 的收费问题产生了一些争议」。这一点对用户选型很重要:开源权重本身可自由下载与自部署,但通过阿里云官方 API 调用这些模型时的计费方式、是否对长上下文 / Agentic 高 token 场景友好,会直接影响「用得起」的体验。换言之,模型权重的开放 ≠ 托管 API 的便宜,自部署(尤其 30B-A3B 与 GGUF 变体)反而是控制成本更可控的路径。
五、适用与不适用
适合:
- 想自部署一个接近闭源编码 Agent 能力的开源模型的团队;
- 需要仓库级(256K→1M)长上下文理解、358 种语言覆盖的代码场景;
- 偏好非思考式短输出、与 Qwen Code / CLINE / Claude Code 等 Agent 框架对接的开发者;
- 本地开发:30B-A3B、Next 的 GGUF / FP8 变体显著降低了本地跑编码 Agent 的门槛。
不适用:
- 只想做简单单行补全的 IDE 场景——杀鸡用牛刀;
- 无法接受更换 tokenizer、升级推理引擎(SGLang/vLLM)的旧部署环境;
- 期望「官方 API 一定便宜」的团队——定价争议未消,需以控制台实时价格为准;
- 需要严格 thinking / 长推理链的数学研究型任务——该系列定位为非思考式编码模型。
六、客观分析:优势与局限
优势:
- 同档开源模型里 Agentic Coding 能力第一梯队,SWE-Bench 69.6% 是实打实的高分;
- 型号矩阵完整,从 480B 旗舰到 30B-A3B、Next 本地档、GGUF/FP8 量化,覆盖自部署到本地全场景;
- 256K 原生 + YARN 1M 的长上下文,对仓库级任务友好;
- 主动兼容主流编码 Agent 框架(fork Gemini CLI 做了 Qwen Code),生态接入成本低。
局限:
- function calling 强绑定新 tokenizer 与特定推理引擎 parser,迁移有坑;
- 「媲美 Claude Sonnet」缺乏逐项公开对照,且 SWE-Bench 单一口径不能代表所有编码场景;
- 官方 API 计费争议未消,托管成本不透明;
- 非思考模式定位意味着它在需要深度多步推理的任务上,未必胜过带 thinking 的通用大模型。
七、它意味着什么
Qwen3-Coder 的意义在于:开源阵营第一次在「Agentic Coding」这个闭源模型的传统优势区,拿出了从旗舰到本地档都完整、且能直接驱动 Claude Code / CLINE 类 Agent 框架的系列模型。对中文开发者和自部署团队,它把「用得起、管得住数据」的编码 Agent 向前推了一步;但要把标称能力真正落地,务必升级 tokenizer、用对推理引擎 parser,并把 API 定价与自部署成本一起算清楚。