QMD:Tobi Lütke 做的本地 Markdown 混合搜索引擎
阅读时间: 大约 8 分钟
QMD:Tobi Lütke 做的本地 Markdown 混合搜索引擎
当你的笔记、会议记录、文档日积月累到几个 G,本地全文搜索就会从「够用」变成「不够用」:关键词搜得到精确词、却记不起语义;向量搜得到意思相近的段落、却漏了专有名词。QMD(Query Markup Documents)是 Shopify CEO Tobi Lütke 开源的一个端侧搜索引擎,专门解决「在自己的 Markdown 资料里又快又准地找到东西」这件事,并把结果直接喂给 AI Agent。本文基于其 GitHub README 做分析。
一、它是什么
一句话:一个跑在你自己机器上、给「你需要记住的一切」用的搜索引擎。索引对象是 Markdown 笔记、会议转录、文档与知识库;查询既可以是关键词,也可以是自然语言。它不是 SaaS,也不调云端 API——BM25 全文检索、向量语义检索、LLM 重排三部分全部通过 node-llama-cpp 加载 GGUF 模型在本地运行。包名 @tobilu/qmd,MIT 协议。
二、混合搜索是怎么拼的
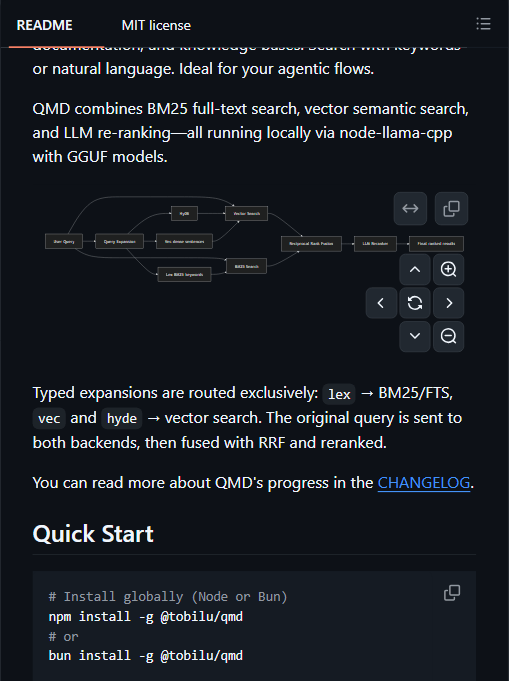
从 README 的架构图与文字看,QMD 的检索管线分四步:
- 查询扩展(Query Expansion):把原始问题扩展成若干子查询;
- 类型化路由:带
lex前缀的子查询走 BM25/FTS,带vec/hyde前缀的走向量检索——README 强调这是「exclusively(独占路由)」;原始查询本身则同时发给两个后端; - RRF 融合:两路结果用 Reciprocal Rank Fusion(倒数排名融合)合并;
- LLM 重排:融合后的结果再经本地重排模型打分,输出最终排名。
对应到命令行,质量从快到高分三档:
qmd search "..."—— 纯 BM25 关键词,快;qmd vsearch "..."—— 纯向量语义;qmd query "..."—— 混合 + 重排,官方称质量最好。
三、为 Agent 而生的输出与 MCP 集成
QMD 设计上明显瞄准 agentic workflow:--json、--files、--min-score 等参数让 LLM 能直接拿到结构化结果或过滤后的文件清单,qmd get --full 可取全文。它还暴露一个 MCP(Model Context Protocol)服务器,对外四个工具:
query—— 带类型化子查询(lex/vec/hyde)搜索,RRF + 重排;get—— 按路径或 docid 取文档(带模糊匹配建议);multi_get—— 按 glob、逗号列表或 docid 批量取;status—— 索引健康与集合信息。
配置上,Claude Desktop 只要在 claude_desktop_config.json 加一段 command: qmd, args: ["mcp"];Claude Code 则推荐直接装插件 claude plugin install qmd@qmd。
四、工程细节与官方自己标注的安全口径
有两个设计细节值得单独点出:
模型常驻 vs 重复加载。默认 MCP 走 stdio,每个客户端起一个子进程、重复加载模型很慢;所以 QMD 提供 HTTP transport(
qmd mcp --http,默认localhost:8181),让 embedding/重排模型常驻 VRAM 跨请求复用。官方口径是:请求间模型常驻显存,embedding/rerank 上下文空闲 5 分钟后释放、下次请求透明重建(约 1 秒惩罚,模型本身仍驻留)。DNS rebinding 防护。HTTP 服务默认绑 localhost,但 README 专门强调「光绑 loopback 不够」——浏览器从你本机发请求,照样能通过 DNS rebinding 读你的索引。因此每个请求都校验
Origin与Host:非 loopback 的 Origin 直接 403。并给出QMD_ALLOWED_ORIGINS/QMD_ALLOWED_HOSTS环境变量;一旦你--host 0.0.0.0暴露到非本机,官方明确警告:端点是无认证的,必须自己在前面加鉴权。
五、必须自己承担的代价(官方未夸大的部分)
- 「全部本地」不是免费的:embedding 模型、重排模型都要下载 GGUF 并常驻显存/内存;没有独显、内存吃紧的机器上,
qmd query(混合+重排)的延迟会明显高于qmd search。README 没有给硬件门槛的量化建议(「官方称本地运行」是架构描述,不是性能承诺)。 - 索引要先建:
qmd embed生成向量是一次性但耗时的步骤,文档库变动后要重跑;它不是实时增量索引的银弹。 - 项目很活跃但年轻:仓库 issues 103、PR 90,最近提交「3 周前」。这种高并发 issue 数既是关注度,也意味着 API 与行为仍在快速变动。
六、适用与不适用场景
适合: 笔记/文档/会议记录都在本地 Markdown、且已在用 Claude Desktop/Claude Code 的个人开发者与知识工作者;对数据隐私敏感、不愿把笔记发到云端向量库的团队;想要一个「关键词 + 语义 + 重排」完整混合检索样例来参考其路由与 RRF 设计的人。
不适合: 没有独立显存、想秒级响应查询的低配机器;多人协作共享索引(它是单用户端侧工具);非 Markdown 为主的资料库(PDF、扫描件不在主打范围)。
七、客观分析:优势与意义
优势: 混合检索管线设计完整(类型化路由 + RRF + 本地重排),不是只接一个 embedding API;MCP 一等公民,与 Claude 生态即插即用;全程本地、隐私不出机;安全上连 DNS rebinding 这种边角都想到了。
局限: 硬件门槛与索引维护成本被轻描淡写;单用户、本地单实例;与成熟桌面搜索(如 VS Code 全局搜索、Obsidian 插件)相比,生态积累尚浅。
QMD 的意义不在于「又一个全文搜索」,而在于它示范了一件事:当本地小模型(GGUF)足够便宜,个人知识库的「语义检索 + 重排」可以完全搬回端侧,并通过 MCP 直接成为 Agent 的一只眼睛。Tobi Lütke 亲自下场写代码这件事本身也提醒业界:CEO 保持技术手感,往往是一个公司工程文化的晴雨表。