Promptfoo:把测试驱动开发搬进 LLM 应用
阅读时间: 大约 8 分钟
Promptfoo:把测试驱动开发搬进 LLM 应用
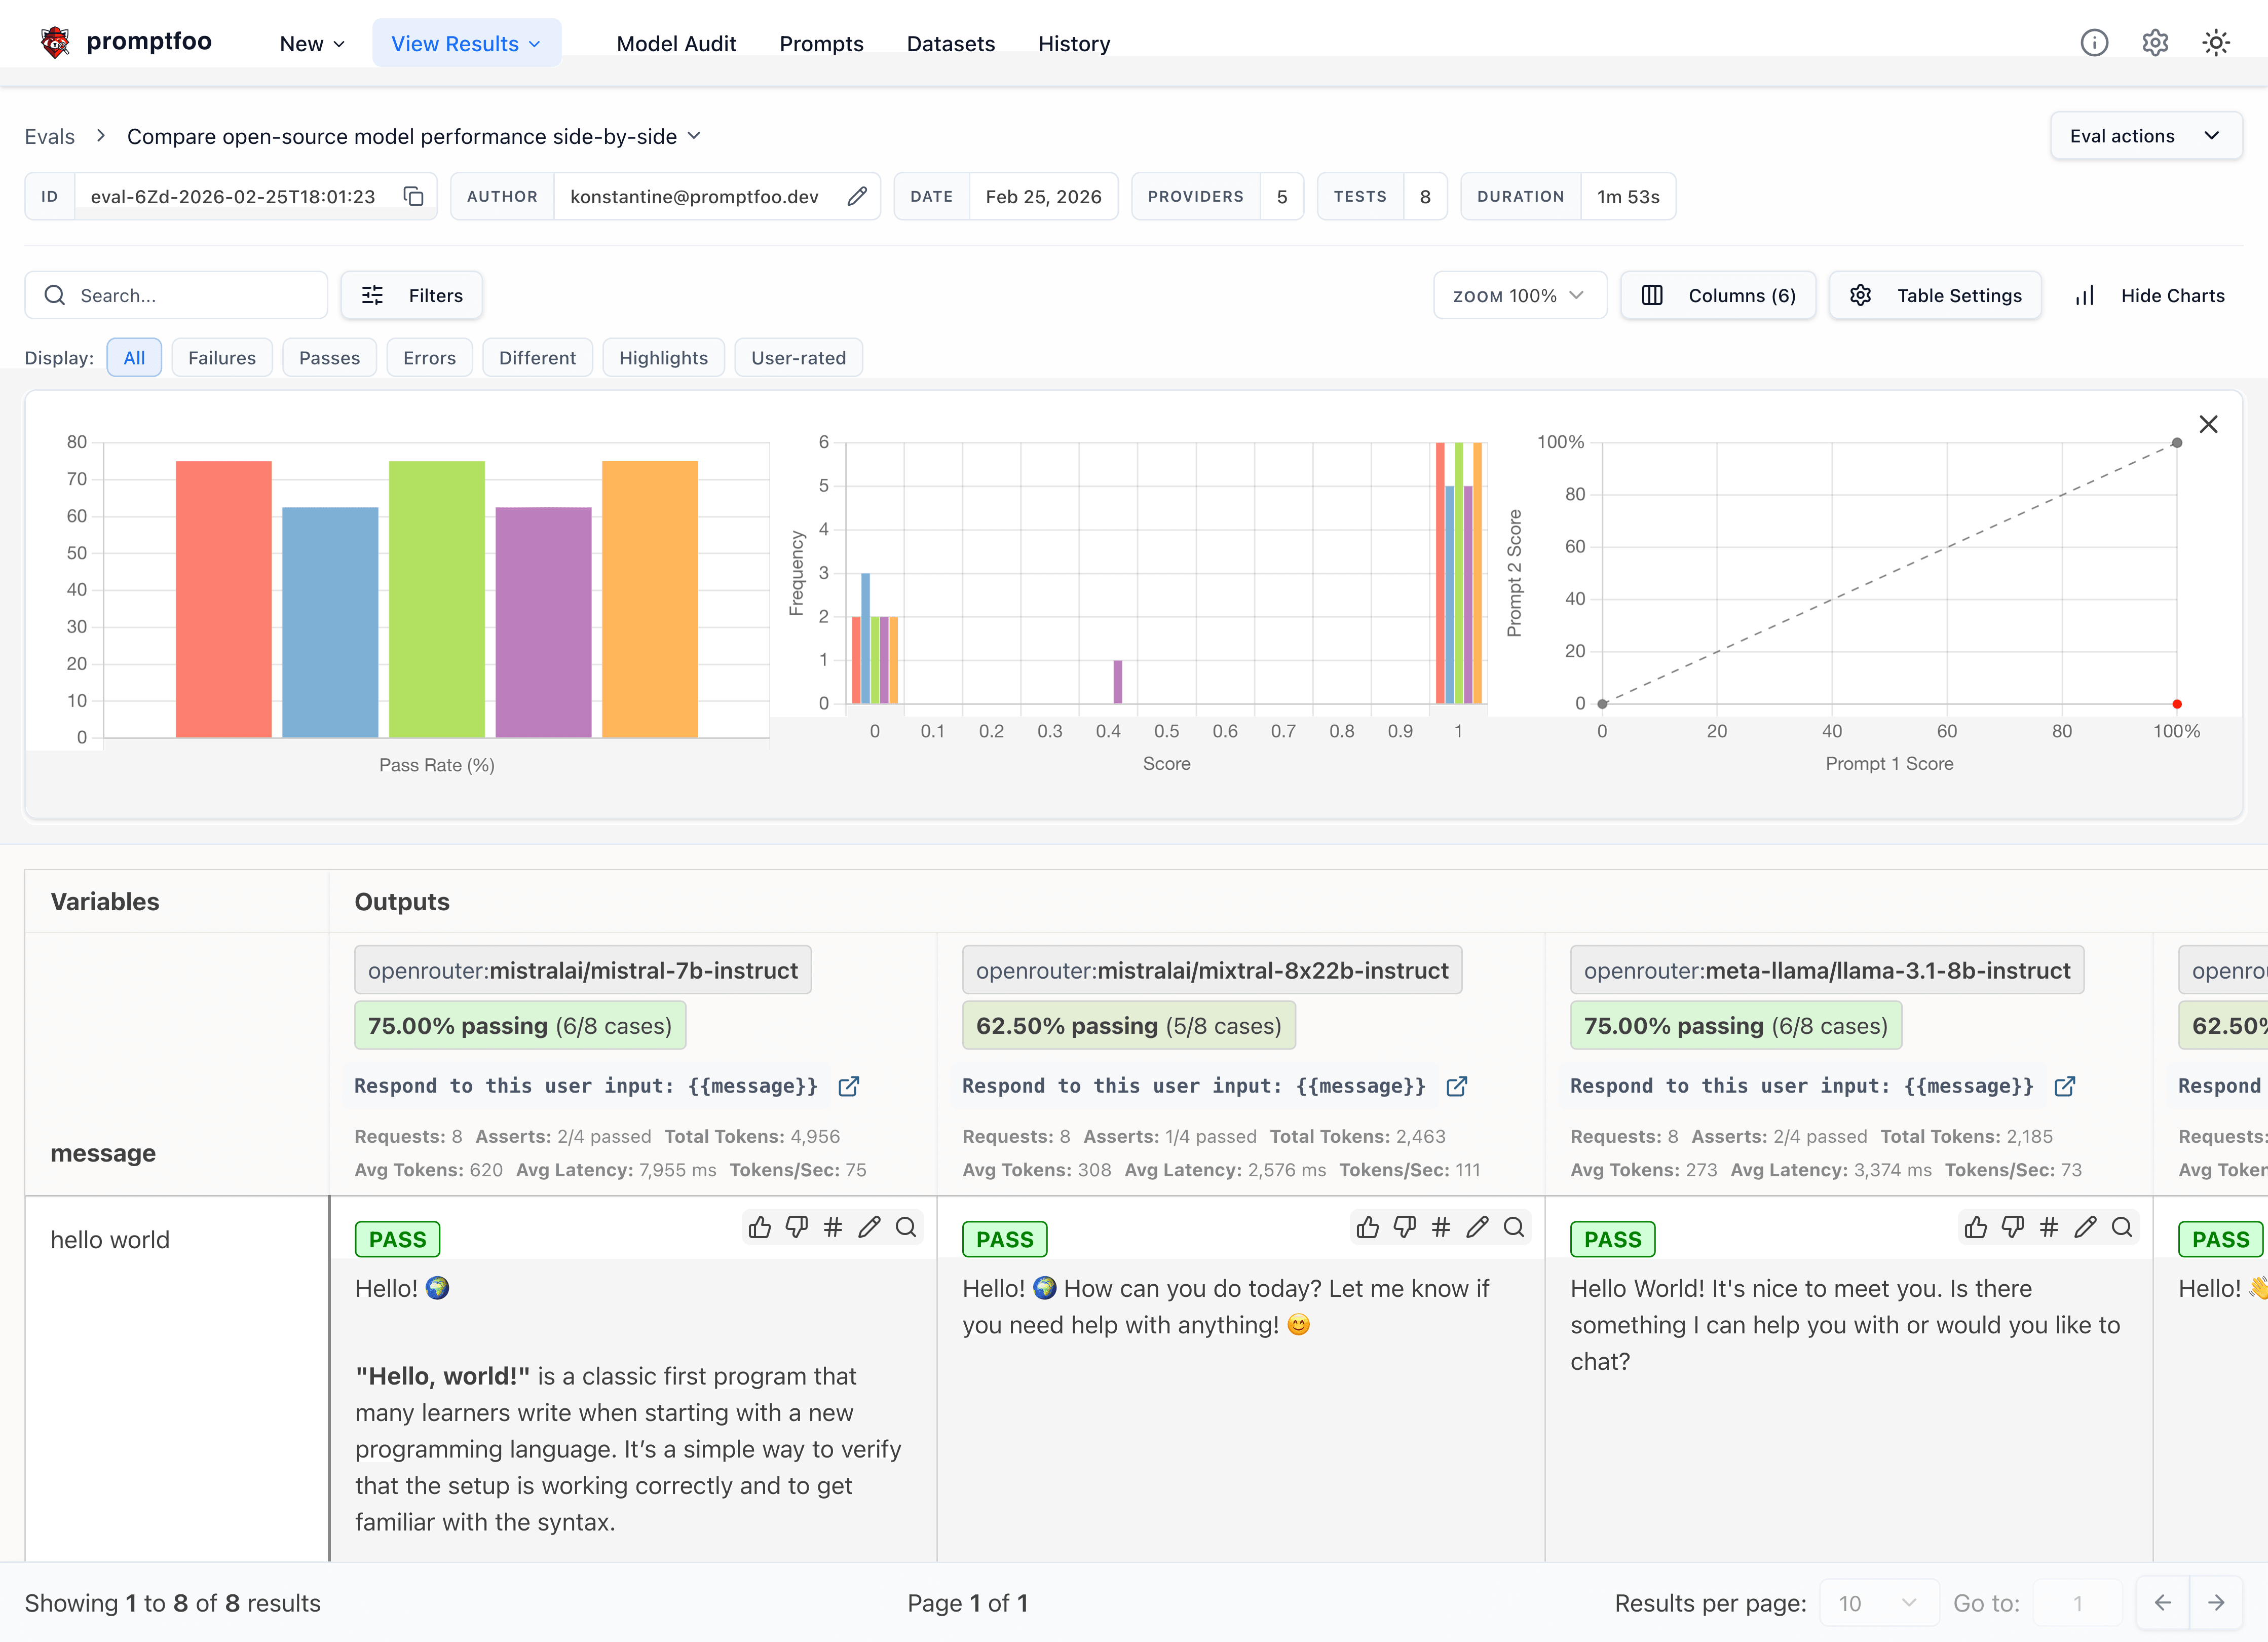
在大模型应用早期,团队普遍靠”人工跑几个 case、肉眼看看输出”来判断 Prompt 改得好不好。这种试错式流程在模型能力快速迭代、Agent 开始接入生产系统之后迅速失效。Promptfoo 试图解决的就是这个问题:它把传统软件工程里的”测试驱动开发(TDD)“方法论搬到 LLM 应用上,用声明式配置定义测试用例,自动对比多个模型的输出,并对 Prompt 注入、数据泄露等风险做红队扫描。本文基于其官方 GitHub 仓库(promptfoo/promptfoo)README 与项目库条目,做一次克制的分析。
一、背景动机:从”试错”到”可回归”
LLM 应用的质量问题和传统软件很不一样:同一个 Prompt,今天能答、明天模型一升级就可能崩;接入新模型供应商时,输出风格、稳定性、安全性都要重新验证。如果没有一套可重复执行、可接入 CI 的评估手段,每次改动都等于赌博。
Promptfoo 官方把自己定位成 “CLI and library for evaluating and red-teaming LLM-based apps”,口号是 “Stop using trial-and-error… start shipping secure, reliable agents”。它覆盖两类需求:
- 评估(evals):对同一组用例,并排跑 OpenAI、Anthropic、Gemini、DeepSeek 等多家模型,按断言自动打分;
- 红队/安全(red teaming):自动模拟 Prompt 注入、越狱、敏感数据泄露等攻击,输出漏洞报告。
二、它是什么:声明式配置 + Web 视图
从 README 看,Promptfoo 的使用方式很贴近工程习惯:
npm install -g promptfoo      # 也支持 brew install / pip install
promptfoo init --example getting-started
promptfoo eval                # 跑评估
promptfoo view                # 打开 Web 视图看结果
测试用例以 YAML 声明,包含输入、期望断言、要对比的模型列表;跑完后在本地 Web 界面里矩阵式地查看每个模型在每个用例上的得分与输出(即首图所示)。这种”配置即测试、命令即回归”的设计,是它区别于手工评测脚本的关键。
三、关键事实与口径
需要区分”官方称”与”可在仓库核实”的信息:
- 可核实(README 明文):项目以 MIT 协议开源,提供 CLI 与库两种用法,支持 npm、brew、pip 三种安装方式;README 顶部明确写着 “Promptfoo is now part of OpenAI. Promptfoo remains open source and MIT licensed.”——即公司被 OpenAI 收购后,项目仍保持开源与 MIT 许可。
- 官方称/项目库转述:项目库点评提到 Anthropic 在其官方博客中称内部使用 Promptfoo 做 Agent 质量评估;README 标题也写有 “Used by OpenAI and Anthropic”。这类”谁在用”属于自我声明的背书,未经独立审计,应视为营销口径而非可复核的采用率数据。
- 合规映射:项目库称其合规报告可映射到 OWASP、NIST 等标准。README 中确实将其定位为 “red teaming / pentesting / vulnerability scanning for AI”,与 OWASP LLM Top 10 一类框架对齐是其卖点,但具体覆盖度需要在实际报告中核对。
四、评测方法本身的偏向
这一点值得单独说。Promptfoo 这类工具解决的是”可重复”,但并不自动等于”更正确”:
- 断言由人写:用例和打分规则仍由开发者定义,工具只是机械化执行。如果测试集本身偏向某类输出风格,对比结果会系统性偏向那个方向。
- 模型版本会漂移:对比的是调用时点的线上模型,供应商静默升级后历史结果不再可复现,需要固定模型快照版本才严谨。
- 红队覆盖率是下界:能扫出已知攻击模板,不代表没有未被模板覆盖的新绕过方式;“通过红队扫描”不等于”安全”。
五、适用 / 不适用场景
适合:
- 已经有多模型或多 Prompt 分支、需要每次改动做回归对比的团队;
- 想把 LLM 质量门禁接进 CI/CD,避免人工把关;
- 上线前做一次系统化的 Prompt 注入/越狱自查,并产出可交付的合规材料。
不适合:
- 还在探索期、Prompt 一天一改的早期 demo,写 YAML 用例的成本可能高于收益;
- 把它当成”模型好不好”的最终裁判——它只对”你定义的那组用例”负责。
六、客观分析:优势与局限
优势:
- 工程化程度高:声明式配置、CLI、Web 视图、CI 集成齐全,迁移成本低;
- 双能力合一:评估与红队在同一套配置体系下,不用在两个工具间切换;
- MIT 开源 + 被 OpenAI 收购后仍开源:避免了工具本身被单一厂商闭源锁定的风险;
- 多供应商中立:不绑定某一家模型,便于横向比价与对比。
局限:
- 质量取决于用例质量:工具不保证评测结论正确,只保证可重复;
- 红队是模板化扫描:对新型越狱的覆盖依赖社区规则库更新;
- 关键截图托管在独立文档域:本文实测其红队漏洞报告截图位于 promptfoo.dev,当前网络环境无法直接抓取,故正文仅使用了 GitHub 仓库内可下载的评估矩阵图(首图),第二张官方图因域名不可达未能收录。
七、它意味着什么
Promptfoo 的真正信号不在于某个新算法,而在于一个趋势:LLM 应用正在从”炼丹式试错”走向”有测试、有门禁、有合规材料”的软件工程阶段。当 Agent 开始真正操作生产系统,可观测性与测试覆盖会和传统后端一样成为刚需。对正在把 LLM 推上生产线的团队,把这类工具提前接进 CI,远比事后救火便宜。