pg_durable:微软把持久化执行塞进 PostgreSQL,不再需要 Temporal 与 Redis
阅读时间: 大约 10 分钟
pg_durable:微软把持久化执行塞进 PostgreSQL,不再需要 Temporal 与 Redis
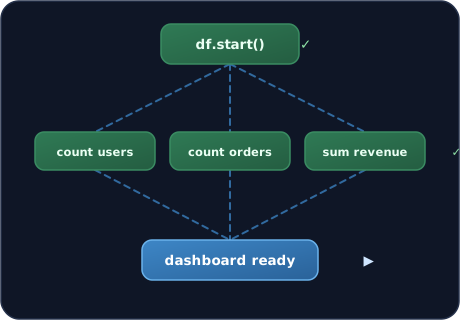
持久化执行(durable execution)这两年火了:Temporal、Restate、AWS Step Functions 专门做编排系统,让长任务在崩溃、重启、某步失败后能从检查点恢复。微软的 pg_durable 反其道而行——把这套能力直接做成一个 PostgreSQL 扩展,让你用 SQL 定义和执行长时间运行、可容错的工作流。它由 Rust + pgrx 开发,无需 Redis、无需 Temporal、无需任何外部服务。本文基于微软官方 GitHub 仓库,做一次冷静拆解。
一、背景动机:别再用 cron + jobs 表 + worker 拼可靠后台任务
团队今天在做后台任务时,往往是这么拼出来的:pg_cron 加一张 jobs 表、加状态列、加重试计数、再写一个轮询 worker;或者用 Airflow/Temporal/Step Functions 外部编排后回调 Postgres;或者写个 plpgsql 过程,一直跑到崩溃或长事务把锁拖垮才重来。
这种拼法的痛点很具体(README 原文列举):长任务中途重启就得重跑已成功的步骤;一行失败或一次 API 调用失败就要手工清理、不确定能否重放;长事务持锁、撑大 WAL;并行逻辑散在应用层到处是部分失败 bug;工作流逻辑分散在 SQL、worker、队列、dashboard、状态表里。pg_durable 的赌注是:如果你的状态本来就在 Postgres,那把执行引擎也搬进 Postgres,能省掉一整套 worker 与队列基础设施。
二、是什么:SQL 形状的持久化函数
一个 pg_durable 函数就是一张 SQL 步骤构成的图:PostgreSQL 边执行边给每步打检查点。数据库崩溃、重启、或某步失败后,从最近的持久检查点恢复,而不是你手工重建状态。它的定位是”Durable Execution inside PostgreSQL”,属于微软”把计算带到数据身边(bring compute close to data)“这一使命的一部分,并已内置进微软新的云 PostgreSQL 服务 Azure HorizonDB。
快速示例(README 原文):
SELECT df.start(
    'SELECT id FROM documents WHERE processed = false LIMIT 100' |=> 'batch'
    ~> 'UPDATE documents SET processed = true WHERE id IN (SELECT id FROM $batch.*)'
);
用 |=> 把查询结果命名为 batch,用 ~> 串联下一步,df.start() 返回实例 ID,之后可从 df.instances 等表查询状态与结果。
三、技术机制:扩展 + 后台 worker + 行级安全
- 零基础设施:作为 PostgreSQL 扩展运行,无 Redis、无 Temporal、无外部服务;自带后台 worker 执行;
- SQL 原生:用可组合算子(
~>、|=>)定义调度、条件、并行; - 数据库感知:调度、条件、并行执行是一等原语;运行可见性来自
df.instances等表,与你的数据共用同一套认证与备份模型; - 多租户隔离:用行级安全(RLS)做多用户隔离;
- 发行物:为 PostgreSQL 17/18(amd64)发布 Debian 包,并提供 Docker 镜像(
ghcr.io/microsoft/pg_durable); - 语言:Rust + pgrx。
README 列出的典型负载:向量嵌入流水线(切块→调 embedding API→upsert 进 pgvector)、批量摄取(暂存/去重/转换/发布)、定时维护(检测膨胀→通知→等审批→执行)、fan-out 聚合(并行跑独立查询再 join)、外部 API 工作流( enrichment、分类、webhook)。
四、关键事实表
| 项目 | 官方口径 |
|---|---|
| 出品方 | Microsoft |
| 定位 | PostgreSQL 内的持久化执行扩展 |
| 开发语言 | Rust + pgrx |
| 外部依赖 | 无(无需 Redis/Temporal) |
| 兼容 PG 版本 | PostgreSQL 17 & 18(amd64) |
| 许可证 | PostgreSQL License |
| 隔离方式 | 行级安全(RLS) |
| 云服务内置 | Azure HorizonDB |
| 状态可见性 | df.instances 等 Postgres 表 |
五、口径偏差与官方自己承认的”不要用”清单
这一节是本文最该细读的部分——README 专门写了 “When not to use it” 和 “Limitations”:
- 模型是刻意 SQL 形状的。README 原话:“The model is intentionally SQL-shaped.” 如果某步需要任意代码、非 HTTP SDK、或丰富的内存控制流,你得把那部分逻辑包成 SQL 函数、暴露成 HTTP 端点给
df.http()调用,或者干脆那一段用通用编排器。 - 不要用在这些场景(官方明确):任务只是一条
INSERT ... SELECT普通 SQL;需要亚毫秒级同步请求处理(它做的是持久化后台执行);你的 Postgres 环境不允许装扩展或跑后台 worker;工作流主要活在 Postgres 之外、跨多个异构系统;需要无法干净映射到 SQL 步骤/分支/循环/HTTP 调用的任意应用逻辑。 - Docker 镜像仅供学习,禁用于生产。官方警告:发布的 Docker 镜像为了开箱即用,开启了超级用户 durable 实例、并在启动时显式配置了受限 HTTP——“do not use it in production”。
- 与数据库强耦合。Koala 点评也指出代价:工作流和 Postgres 绑定,跨语言、跨服务的复杂编排未必合适。它适合”状态就在 Postgres”的团队,不适合微服务间的通用编排总线。
- 基准是自构建 harness。benchmarks 目录提供的是用 pgbench 测完成工作流的脚本,官方未给出与 Temporal/Restate 的横向对比数字;本文也不代为编造性能结论。
六、适用 / 不适用场景
适合:
- 已经把状态存在 Postgres、想消掉 cron+jobs 表+轮询 worker 这套胶水的后端/数据工程师;
- DBAs/SRE 自动化那些”必须能重启后继续、且能在 SQL 里审计”的 runbook;
- AI/数据流水线里”每行/每文档/每批”都需要持久化执行的场景(向量嵌入、批量摄取);
- 想靠近数据、不想额外维护一套编排集群的团队。
不适合:
- 工作流跨多个异构服务、需要通用语言 SDK 的复杂编排——上 Temporal;
- 亚毫秒同步请求路径;
- 无权装扩展/后台 worker 的托管 Postgres;
- 只是单条 SQL 能搞定的任务——杀鸡用牛刀。
七、客观分析:优势与局限
优势: 零额外基础设施、状态与可见性都在 Postgres(统一备份/认证/审计)、崩溃重启自动从检查点恢复、RLS 多租户、与 pgvector 等生态天然契合、微软背书并内置 HorizonDB。
局限: 表达力被 SQL 形状限制、Docker 镜像不可生产用、强耦合 Postgres 不适合跨服务编排、缺公开横向基准、仍早期(仓库 issues/PR 数量尚小)。
它意味着什么: pg_durable 代表了 2026 年”数据库正在吃掉周边基础设施”的趋势——消息队列、工作流引擎、调度器正被一个个吸进 Postgres。对本来就重度依赖 Postgres的团队,它确实能显著降低运维心智;但它不是 Temporal 的通用替代品,而是**“Postgres 内部的持久化执行层”**。选型时最该问自己一句:我的工作流是住在 Postgres 里,还是跨在一堆服务之间?前者用 pg_durable 很香,后者请回到 Temporal。