Apache OpenDAL:一个统一抽象层接通所有存储
阅读时间: 大约 11 分钟
Apache OpenDAL:一个统一抽象层接通所有存储
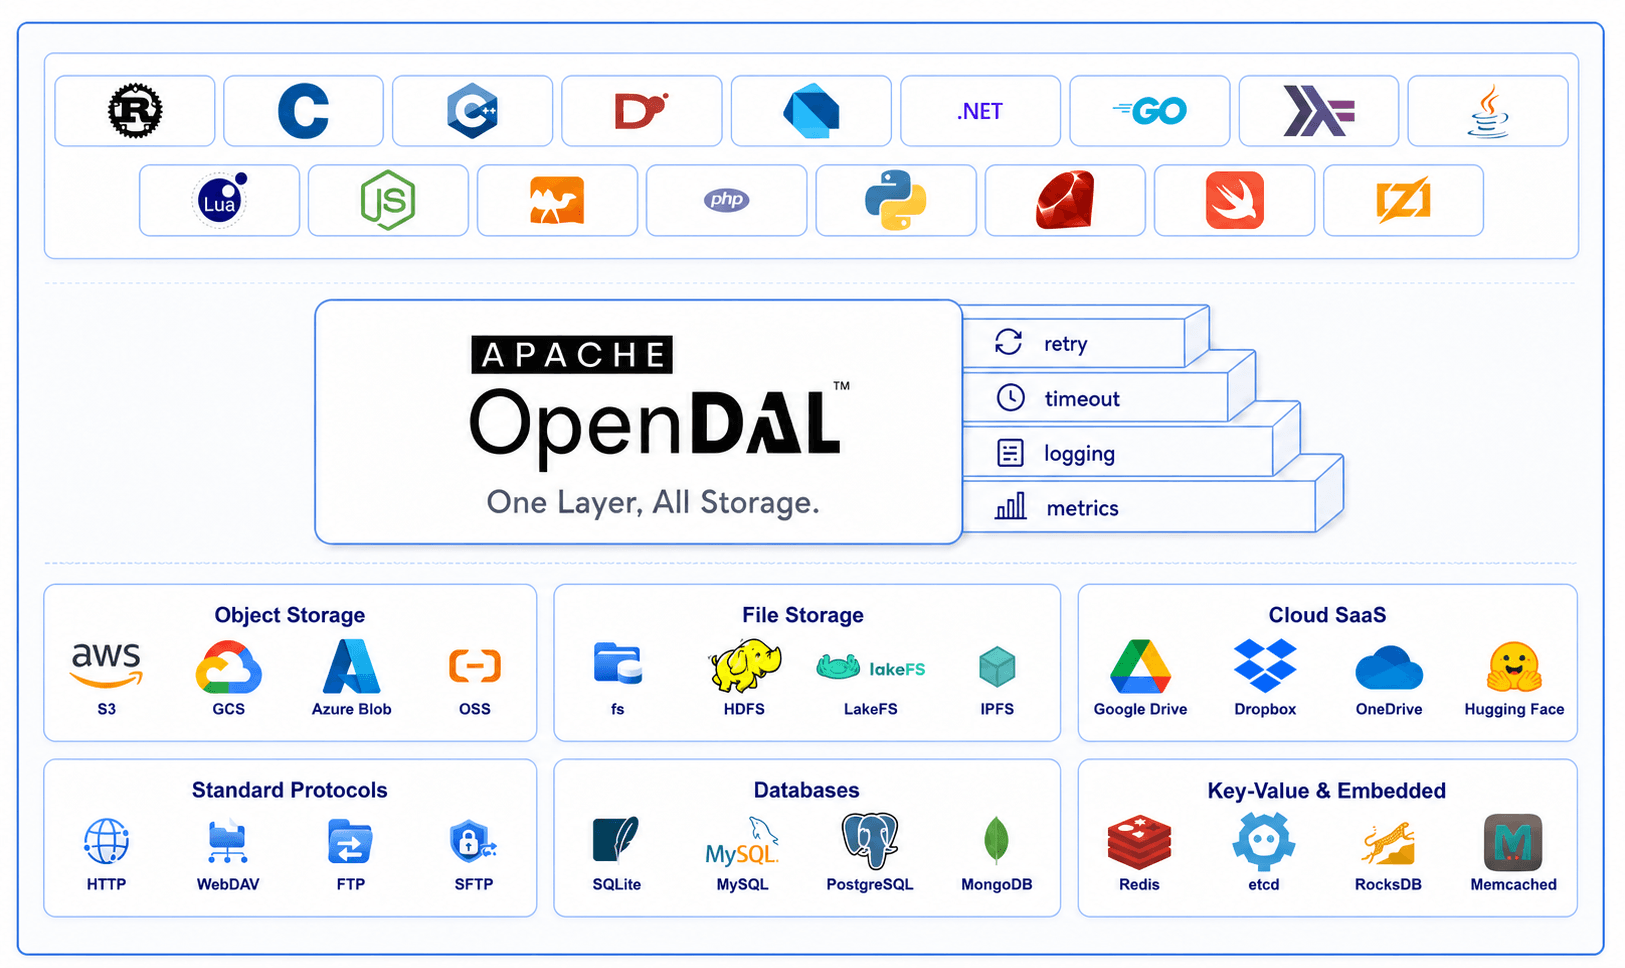
现代应用要面对的存储越来越碎:S3、GCS、Azure Blob、阿里云 OSS、华为云 OBS、腾讯云 COS 各家对象存储 API 互不兼容,本地文件、HDFS、WebDAV、FTP、SFTP 又是另一套,再加 Google Drive、Dropbox、OneDrive、Hugging Face 这类云 SaaS,以及 Redis、etcd、SQLite、PostgreSQL 这些数据库/KV。每接一种存储就要写一套 SDK、处理一遍鉴权与重试。Apache OpenDAL 的野心是用一层统一抽象把它们全部抹平,口号是 “One Layer, All Storage”。它以 Apache 2.0 协议孵化,核心用 Rust 编写。本文基于官方 README 与架构图,分析它到底抽象了什么、覆盖多广、以及版本口径上的坑。
一、背景:存储碎片化带来的”胶水代码税”
做数据系统的人都熟这种痛:一个数据仓库既要能读 S3 又要能读 HDFS,一个备份工具要同时支持七牛、阿里、腾讯三家对象存储,一个 CLI 要能把数据从本地文件搬到 Google Drive。每接一个后端,就要引入一个 SDK、处理一套错误模型、自己写重试与超时。OpenDAL 的判断是:这种”存储适配”是横切关注点,不该由每个应用重复实现,于是把它抽成一个独立的数据访问层。
二、是什么:Operator 抽象 + 层(Layers)+ 服务(Services)
OpenDAL 的核心抽象很克制:
- 核心包是 Rust crate
opendal,主抽象叫Operator; - 三类扩展点:语言绑定(bindings)、层(layers)、服务(services);
- 层是可组合的横切能力:重试、超时、日志、tracing、metrics、Prometheus、OpenTelemetry、限流、并发控制、MIME 推断、路由、缓存等,按需叠在 Operator 上。
官方强调 “zero-cost core”:用 Rust 写出可组合的服务与层,应用只引入自己真正用到的后端与能力,不会为用不到的存储白编译一堆代码。
三、技术机制:一套 API,六类存储
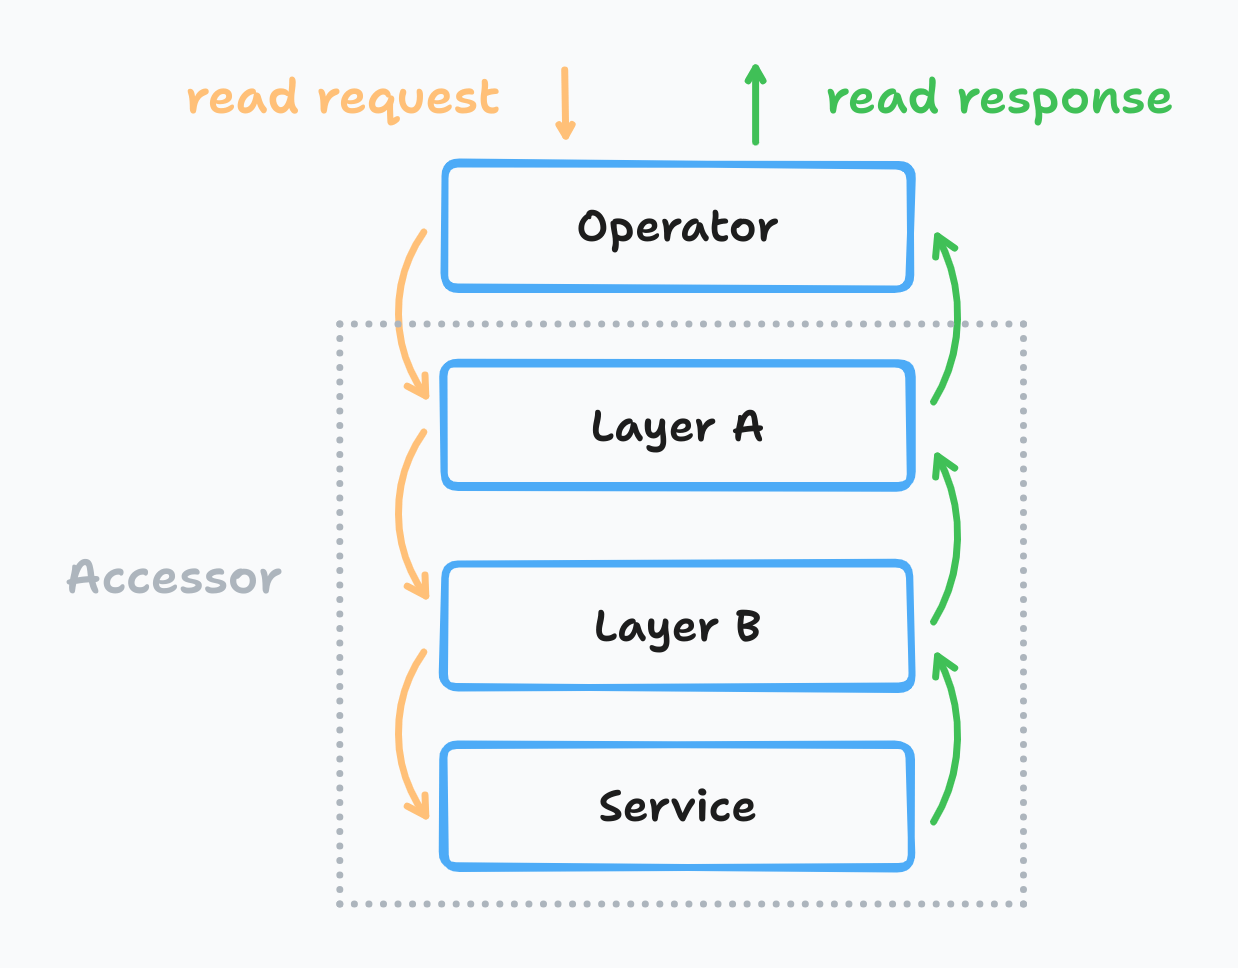
上面这张图来自官方博客《How OpenDAL read data》,把 OpenDAL 的运行时结构画得很直白:一次 read request 先进入统一的 Operator,然后像穿洋葱一样自上而下经过若干层(Layer A、Layer B),最后才落到真正访问后端的 Service;响应沿同一路径自下而上返回。retry、timeout、tracing、限流这些横切能力,就是插在这条链路上的层——业务代码只面对 Operator,不关心请求到底被中间哪些层加工过。
从官方架构图与 README 的服务清单看,OpenDAL 把接入目标分成六大类:
| 存储类别 | 代表后端(官方列举) |
|---|---|
| 对象存储 | S3、GCS、Azure Blob、阿里 OSS、华为 OBS、腾讯 COS、火山 TOS、Backblaze B2、Upyun、Vercel Blob |
| 文件存储 | 本地 fs、HDFS、WebHDFS、LakeFS、IPFS、Alluxio、DBFS、GridFS |
| 云 SaaS | Google Drive、Dropbox、OneDrive、阿里云盘、Hugging Face、GitHub、pCloud、Seafile |
| 标准协议 | HTTP、FTP、WebDAV、SFTP |
| 数据库 | SQLite、MySQL、PostgreSQL |
| KV / 嵌入式 | Redis、etcd、MongoDB、SurrealDB、D1、RocksDB、Memcached、Cloudflare KV、TiKV、FoundationDB、sled、moka |
语言绑定同样广:Rust 核心之外,官方列出了 C、C++、D、Dart、.NET、Go、Haskell、Java、Lua、Node.js、OCaml、PHP、Python、Ruby、Swift、Zig 共约 17 种语言绑定——也就是说一个 Rust 写的存储抽象,可以被几乎任意技术栈的应用以原生包的方式调用。
四、关键数据与口径
OpenDAL 不是一个靠 benchmark 说话的项目,README 里可核对的量化信息主要是覆盖面:
| 维度 | 官方口径 |
|---|---|
| 语言绑定数量 | 约 17 种(含 Rust 核心) |
| 存储服务大类 | 6 类(对象/文件/云 SaaS/协议/数据库/KV) |
| 可组合层 | retry、timeout、logging、tracing、metrics、Prometheus、OTel、限流、并发控制、缓存等 |
| 核心语言 | Rust |
| 协议 | Apache License 2.0 |
五、口径偏差与官方自承认的边界
这一节是选型时最容易被忽略、但官方写得很明白的点:
- 每个绑定版本号独立演进:README 在语言绑定表上方专门加了 Note——“Each binding has its own independent version number, which may differ from the Rust core version”。查兼容性时,必须看具体那个语言绑定的版本,而不是 Rust core 的版本。这意味着你在 Node.js 侧看到的
opendal版本与 Python 侧、Rust 侧可能完全不同步,能力矩阵(某服务是否在该绑定里已实现)也因此不能跨语言照搬。 - “One API, all storage”是目标而非全等:不同后端能力天然不对称——对象存储没有 rename、文件系统没有多版本、SaaS 服务有自身限流。OpenDAL 用 layers 抹平横切行为,但底层能力差异仍要靠各服务自身的 feature flags 暴露,不能假设一个服务的操作在所有后端都等价。
- 它是访问层,不是存储本身:OpenDAL 不替你存数据,它只是统一了”怎么访问”。数据一致性、事务、权限仍由后端存储自己保证。
- 服务成熟度不齐:README 把服务列得很长,但官方从未宣称所有后端在所有语言绑定里都达到同等生产就绪度,新接的服务往往先在 Rust core 落地,再逐步反向上到各语言。
六、适用与不适用场景
适合:
- 要在多种存储后端之间移植的应用/数据系统(数据仓库、备份同步工具、CLI、AI 训练数据加载器);
- 想用一套代码同时跑本地 fs 与生产对象存储、开发与生产无缝切换的团队;
- 已经在 Rust 生态、想要零额外 SDK 开销的人。
不适合:
- 只接单一存储、且已重度使用该云厂商原生 SDK 高级特性(如 S3 Select、生命周期规则)的项目——抽象层反而可能屏蔽掉底层能力;
- 对”某个语言绑定 + 某个后端”组合的生产成熟度要求极高、却不愿去读该绑定独立版本说明的团队。
七、客观分析:优势与局限
优势:
- 覆盖面真的广:六大类、几十种后端、17 种语言绑定,在同类”存储统一抽象”项目里罕见,且覆盖了大量国内云(阿里 OSS、华为 OBS、腾讯 COS、火山 TOS、阿里云盘);
- Rust 核心 + zero-cost:运行时开销低,只编译用到的后端;
- 可组合层工程化好:重试、超时、tracing、Prometheus、限流做成可叠加 layer,正好是生产环境最常缺的横切能力;
- Apache 顶级项目背书:协议友好、社区规范,不再是某家公司私有。
局限:
- 多语言绑定版本不同步,能力矩阵需逐语言、逐后端核对;
- 底层存储能力不对称带来”抽象泄漏”风险,复杂操作仍要落到具体后端;
- 缺少公开性能基准:README 主打覆盖面,没有给出相对直连各 SDK 的额外开销数字,TCO 要自测。
八、谁该关注
如果你在做一个需要同时对接多家云存储、或要让同一份代码在本地与云上无缝切换的数据类项目,OpenDAL 是目前覆盖面最完整的开源答案之一。但落地前请务必做两件事:一是按你实际用的”语言绑定 × 存储后端”组合去查那个绑定的独立版本说明,别信 Rust core 的版本号;二是在你的真实读写负载上测一遍抽象层额外开销——它省的是胶水代码,不是网络与存储本身的延迟。