OmniParse:把文档、音视频、网页一口气解析成 LLM 友好的结构化数据
阅读时间: 大约 8 分钟
OmniParse:把文档、音视频、网页一口气解析成 LLM 友好的结构化数据
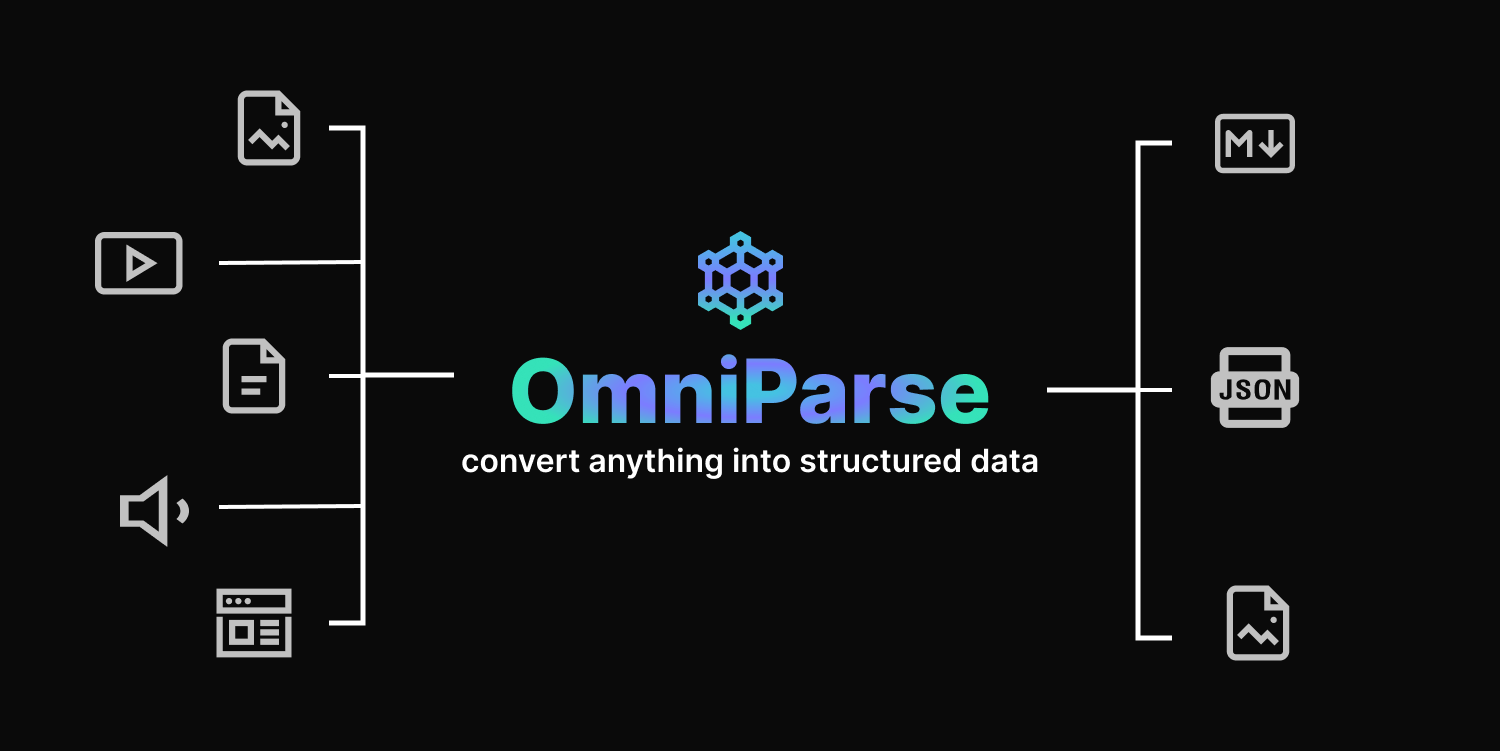
做 RAG 的人都知道一个朴素道理:垃圾进、垃圾出。模型再强,喂给它的 PDF 是乱码表格、扫描件 OCR 一塌糊涂,效果也好不了。Koala 项目库条目(ID 1210)把 OmniParse 称为”高质量数据解析器”——它是一个本地运行的解析平台,目标是把文档、表格、图片、音视频、网页统统吃进来,转成干净、结构化、LLM 友好的 Markdown/JSON。本文基于其官方 README,讲清它支持什么、靠什么模型栈跑,以及读它”高质量”宣传时必须留意的几处口径。
一、它解决什么问题
现实世界的数据”形状各异”:有 Word/PDF/PPT,有图片里的截图和表格,有会议录音和视频,还有动态网页。要把这些统统喂给 RAG 或微调流程,得分别接 OCR、表格识别、语音转写、网页爬虫等一堆工具。OmniParse 的定位就是把这些能力收拢成一个 ingestion/parsing 平台——你丢给它任意文件,它给你结构化、可直接进 GenAI 流程的输出。
二、支持哪些数据、靠什么模型
官方列出的支持类型(README 表格):
| 类别 | 支持的扩展名 |
|---|---|
| 文档 | .doc / .docx / .pdf / .ppt / .pptx |
| 图片 | .png / .jpg / .jpeg / .tiff / .bmp / .heic |
| 视频 | .mp4 / .mkv / .avi / .mov |
| 音频 | .mp3 / .wav / .aac |
| 网页 | 动态网页、任意 http(s) 页面 |
约 20 种文件类型。它不是自己从头训模型,而是把几个开源模型串起来(官方致谢里列得很清楚):
- Surya OCR 系列(Detect / Layout / Order / Texify):负责文档版面检测、阅读顺序、公式识别;
- Marker:底层 PDF 解析器;
- Florence-2 base:做图片描述(caption)、目标检测等视觉任务;
- Whisper Small:做音频/视频转写;
- Selenium / Crawl4AI:抓网页。
部署上一条 Docker 命令即可(docker run --gpus all -p 8000:8000 savatar101/omniparse:0.1),起服务后用 curl -F "file=@xxx.pdf" http://localhost:8000/parse_document 这种 REST 接口调用,另有 Gradio 交互界面。图片处理还支持指定任务:OCR、Caption、详细描述、目标检测、Dense Region Caption 等。
三、关键口径偏差:本地免费,但”商用”要打个问号
这一节是本文重点。OmniParse 主打”完全本地、无外部 API、装进 T4 显卡就能跑”,听起来又自由又省钱,但 README 末尾的许可条款藏着几个必须知道的坑:
- 项目代码是 GPL-3.0,但底层模型权重是”非商用”许可:OmniParse 自己的代码是 GPL-3.0;可它依赖的 Marker 与 Surya OCR 模型权重采用 cc-by-nc-sa-4.0——NC 就是 Non-Commercial,原则上不允许商用。唯一豁免是:最近 12 个月总收入低于 500 万美元、且累计融资金额低于 500 万美元的机构。想超过这个门槛做商业产品,就得单独找 Marker/Surya 买商用授权或双授权。换句话说,“开源可商用”在这个项目上并不成立;
- “高质量”是 Koala 的形容词,官方自己列了一长串局限:README 专门有一节 Limitations——底层 Marker 无法把 100% 公式转成 LaTeX;擅长英文,对中文等语言会吃力;表格不保证 100% 正确、文字可能错位到错误列;空格和缩进不一定保留;断行不一定接对;
- “塞进 T4 显卡”是牺牲精度换来的:官方原话——为了把所有模型塞进 GPU,用的是各模型的最小变体(smallest variants),可能并非 best-in-class。也就是说,“轻量本地跑”和”解析精度天花板”之间是有 trade-off 的;
- 对扫描版 PDF 不友好:它为速度优化,只做有限 OCR 来修错,最适合本身就是电子文本的数字 PDF;重度扫描件/手写件效果会打折;
- 服务端只支持 Linux:README 明确说 server 因依赖问题在 Windows/macOS 上跑不了,Windows 用户只能靠 Docker。
四、优势与局限
优势:
- 一站式、全本地:文档+图片+音视频+网页一个入口搞定,数据不出本机,合规友好;
- 资源门槛低:宣称 T4 级 GPU(官方建议最低 8–10GB 显存)就能跑,普通团队够得着;
- 工程化交付:Docker 一键起、REST API、Gradio UI、Colab 可玩,接 RAG 流程顺;
- 组合成熟开源模型:Surya/Marker/Florence-2/Whisper 都是各自领域被验证过的开源件。
局限:
- 商用许可不清爽:权重 NC 限制 + GPL 传染,商业产品化前必须先过法务;
- 精度有天花板:用最小模型变体,表格、公式、非英文语言都有已知错误模式;
- 只吃数字 PDF:扫描件、复杂版面、中文文档要单独评估效果;
- 生态仍在早期:LangChain/LlamaIndex/Haystack 集成在 Roadmap 里还没落地,批处理、动态切分也是”coming soon”。
五、谁该关注
- 要做私有知识库 RAG、数据不能出内网的团队:全本地、无外部 API 的特点正中下怀;
- 需要同时处理文档+音视频+网页的多模态数据管线:一个平台覆盖比拼多个工具省事;
- 年收入/融资超 500 万美元、想商用的公司:先解决 Marker/Surya 的商用授权问题再上生产;
- 中文为主、扫描件多、对表格公式精度要求高的场景:务必先拿自己的真实样本测一轮,别信”高质量”三个字直接上线。