Needle:把工具调用、结构化抽取和 Embedding 塞进一个 8–29 MB 的端侧模型
阅读时间: 大约 8 分钟
Needle:把工具调用、结构化抽取和 Embedding 塞进一个 8–29 MB 的端侧模型
过去一年,“端侧小模型”成了热门方向,但绝大多数所谓端侧模型仍在百兆量级、且主要做聊天。Cactus Compute 开源的 Needle 走得更极端:它把自己定位为”面向极小设备的自动化基础模型”,整个模型是单个 8–29 MB 的二进制,跑在手机、手表、智能家居、机器人、汽车乃至单片机上,专攻三件事——工具调用、结构化抽取和文本 Embedding。本文基于其 GitHub 仓库(cactus-compute/needle)做一次拆解。
说明:周报选题时该项目以 Needle 2 亮相;目前仓库主线已迭代到 Needle 3,并通过
generation=2参数保留 Needle 2 兼容旧部署。下面以最新的 Needle 3 为准。
一、出发点:端侧不需要”会聊天”,需要”会执行”
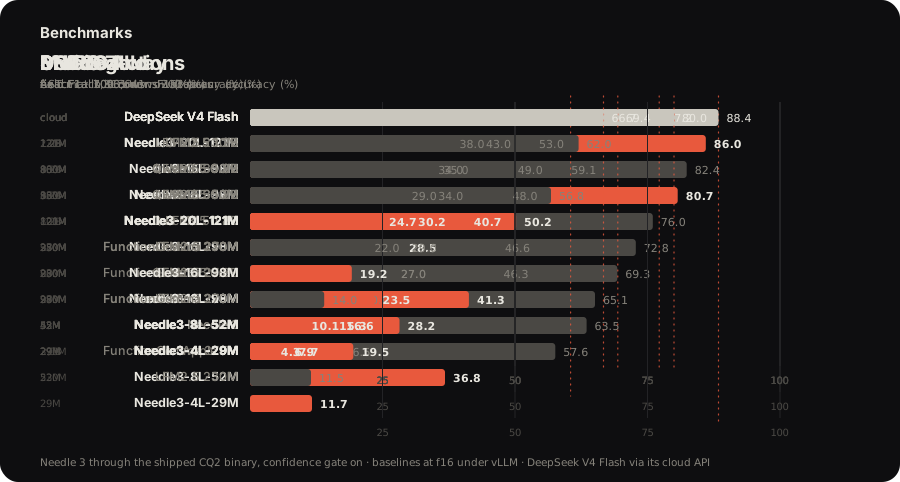
Needle 的设计哲学很明确:主动放弃通用聊天能力,把全部容量砸在端侧最常见的三类自动化任务上。官方的说法是——用牺牲通用对话的代价,在移动端工具调用上击败体积大 10 倍的模型,在结构化抽取上追平体积大 2–3 倍的模型。
它承诺的行为契约很具体:
- 工具调用:给定 App 暴露的函数,Needle 自己挑对函数、从用户原话里把每个参数填好;用户要两件事就按顺序发两个调用;问到没有工具覆盖的事,返回空列表而不是瞎猜;
- 结构化抽取:声明一个 schema,丢给它一堆杂乱文本,返回类型化字段(发票、预订、通知、表单);解码语法保证输出可解析,并可推广为分类;
- 文本向量:同一个模型还能输出句向量,让 App 在本地做搜索、匹配与路由。
二、技术机制:Laddered Simple Attention Network
Needle 3 不是”缩小版 LLM”,而是一套为小尺寸重设计的架构,官方称之为 Laddered Simple Attention Network:
- 用 Monarch Hadamard MLP 替换传统 FFN;
- GQA 注意力 + 因果卷积 tap;
- engram n-gram 记忆,通过 gather 读取;
- 多通路超连接(multi-lane hyper-connections);
- 关键是”阶梯”设计:训练时让从 2 层到 20 层的每一个深度都是一个可独立部署的模型。
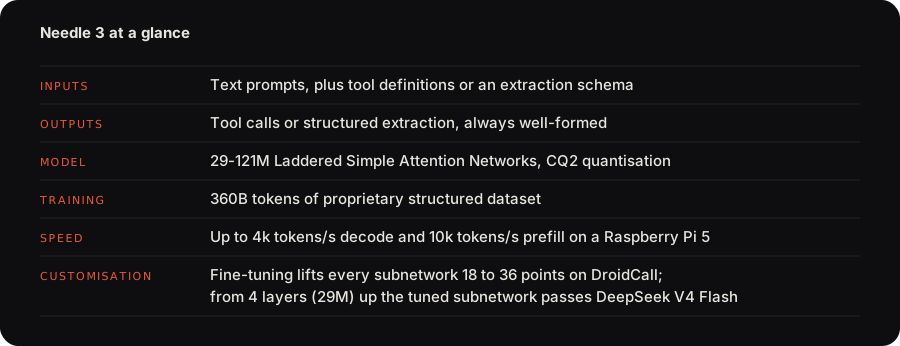
官方称,模型的大部分参数放在 engram 里,因此 121M 的模型做的是 50M 模型的”算术量”。此外,从你的 schema 编译出的字节级语法会约束每一个 token,保证输出合法;每次响应还带一个由专门学习的头输出的校准置信度分数。
量化方面,权重采用 Cactus Quants,约 2.125 bit/权重,整个模型打包成 .cact 文件;每个部署目标附带一个 小于 1 MB 的预编译引擎,启动时再加载权重。
三、上手与微调
安装与试用非常轻:
pip install cactus-needle装饰一个函数即可完成一次工具调用闭环(签名给出参数类型、docstring 即工具描述):
import needle
@needle.tool
def get_weather(city: str):
    "Get the current weather for a city."
    return {"city": city, "temp_c": 27, "sky": "clear"}

agent = needle.Needle(tools=[get_weather])
print(agent.run("what's it like in Lagos right now?")["results"])
# [{'city': 'Lagos', 'temp_c': 27, 'sky': 'clear'}]
每次回合返回一个 JSON 对象,包含 function_calls、模型的 reasoning 和校准后的 confidence。
微调是它的一大卖点,分两条路:
本地 needle finetune | 平台 needle platform finetune | |
|---|---|---|
| 训练内容 | 注意力投影上的 LoRA,基座冻结 | 全模型、从 2 层起每个深度 |
| 精度 | 4-bit | 2-bit,与发布版一致 |
| 置信度头 | 不动,confidence 为 None | 连同模型一起微调、按你的工具校准 |
| 算力 | 自己机器(CPU/CUDA/Metal) | Cactus GPU |
官方称,在 DroidCall 上微调可把每个子网络的指标提升 18–36 分;从 4 层起、微调后的子网络即可超过 DeepSeek V4 Flash,起点仅 29M 参数。
四、客观评价:优势与边界
优势:
- 体积与任务高度对口:8–29 MB、引擎 <1 MB,是真正能塞进嵌入式/端侧设备的模型,且专攻工具调用而非泛聊天;
- 行为契约诚实:无匹配工具返回空列表、输出由语法约束、带校准置信度——这些都是端侧自动化最需要的”可托付”性质;
- 阶梯式部署:同一权重可裁剪到 2–20 层,按设备算力选尺寸,工程上很灵活;
- Apache-2.0,权重与引擎在 Hugging Face 开放。
边界与存疑:
- 牺牲了通用对话:它明确不是聊天助手,复杂对话与开放式推理不在其能力圈;
- 基准为官方自报:“击败大 10 倍模型""超过 DeepSeek V4 Flash”均来自官方测试集(如 DroidCall、Mobile Actions),缺少第三方独立复现;
- 遥测默认开启:二进制默认开遥测,需手动设
NEEDLE_TELEMETRY=0与DO_NOT_TRACK=1关闭——对隐私敏感的端侧场景要注意; - 微调平台依赖 Cactus:2-bit 全量微调需用其托管 GPU,本地只能做 4-bit LoRA,且置信度头不参与。
五、它适合谁
- 移动端 / IoT 开发者:想在离线、无网条件下让 App 本地完成意图识别、表单抽取、设备控制;
- 可穿戴、车机、单片机:算力与内存极端受限、又必须做”一句话触发一个动作”的场景;
- 做端侧 Agent 的团队:把高频、可枚举的工具调用留在本地,只把复杂推理上云。