Modal Training Gym:把 RL 后训练的脏活全包了,你只写奖励函数
阅读时间: 大约 8 分钟
Modal Training Gym:把 RL 后训练的脏活全包了,你只写奖励函数
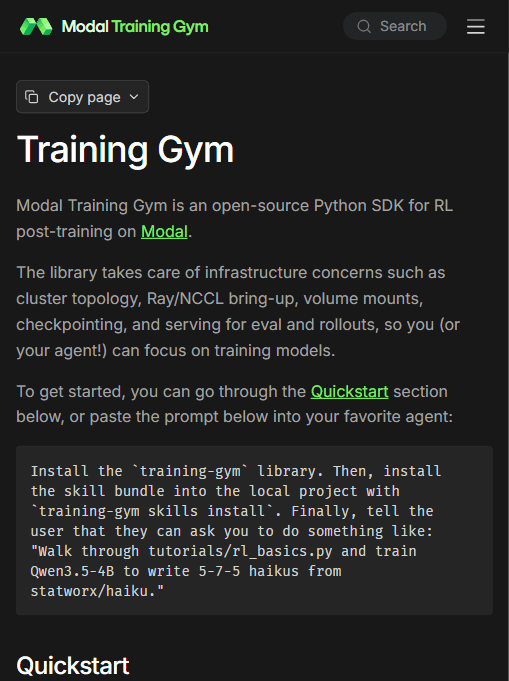
RL(强化学习)后训练现在是大模型能力提升的主战场,但它的工程门槛极高:多机多卡集群拓扑、Ray/NCCL 通信组启动、卷挂载、断点续训、评测与 rollout 服务,光是把这些跑通就要几周。Modal(一家云 GPU 平台)推出的开源 Training Gym 想把这层基础设施全包了——开发者(或你正在用的 coding agent)只需要写训练逻辑和奖励函数。本文基于其官方文档与 GitHub,核对它到底替你做了什么、支持哪些模型,以及绑定 Modal 云这个前提。
一、背景:RL 后训练难在”系统”不在”算法”
微调一个模型做 SFT(监督微调)已经被各类框架打磨得很顺,但 RL 后训练不一样:它要在训练循环里不断rollout(让模型生成)、reward(打分)、再更新策略,这就要求训练集群旁边同时挂着推理服务、评测服务、多机多卡的分布式通信。把这些组装起来并保持稳定,是绝大多数团队真正的瓶颈。
Training Gym 的定位就是把这整层”系统工程”产品化:它是一个跑在 Modal 云上的开源 Python SDK,替你处理集群拓扑、Ray/NCCL 启动、卷挂载、checkpoint 断点续训、以及评测与 rollout 所需的模型服务。
二、开发者要写多少代码
官方 Quickstart 给的示例很能说明问题。整个 RL 训练程序的核心其实就是两段:
- 一个奖励函数(以 GSM8K 数学题为例):解析模型输出里的
\boxed{}答案,和标签比对,返回 0 或 1 的 reward; - 一个 TrainConfig:指定模型(如
Qwen3_5_4B())、数据集(HuggingFaceDataset指向 HF repo)、配方(Qwen3_5_4B_Recipe),然后config.launch()。
也就是说,分布式集群、NCCL、rollout 服务这些你一行都不用碰——SDK 按 recipe 起好。这种”奖励函数 + 配置 = 一次 RL 训练”的抽象,是它和手写 Ray/NCCL 脚本最大的区别。
三、支持哪些模型与框架
官方文档列出的已适配模型家族(已核实):
| 家族 | 模型 |
|---|---|
| DeepSeek | DeepSeek-V4.1-Flash |
| GLM | GLM-4.7 |
| Gemma | gemma-4-26B-A4B-it |
| Inkling | Inkling-Small |
| Moonlight | Moonlight-16B-A3B-Instruct |
| Qwen3 | 0.6B / 1.7B / 4B / 8B / ASR-1.7B / VL-8B-Instruct |
| Qwen3.5 | 0.8B / 2B / 4B / 9B |
| Qwen3.6 | 27B / 35B-A3B |
| Qwen3.8 | 27B |
覆盖从小到 0.6B 的教学模型到 35B-A3B 的 MoE,且包含多模态(VL)与语音(ASR)型号。周报称其内置 13+ 套模型配方、覆盖 Qwen 与 Gemma 系列,支持 slime 与 miles 两套训练框架,并带观测面板与 14 个可直接跑的教程。
四、一个有意思的设计:agent 原生
Training Gym 不只是给人用的,它明确为 coding agent 设计。官方文档直接给了一段可以”粘进你最喜欢的 agent”的提示词:装好 training-gym 后跑 training-gym skills install 把技能包装进项目,然后让 agent”带你过一遍 tutorials/rl_basics.py,把 Qwen3.5-4B 训练成会写 5-7-5 俳句的模型”。配合 training-gym setup 起 dashboard,整个 RL 实验可以由 agent 驱动。这反映了当前工具链设计的趋势:框架本身变成 agent 的技能包。
五、口径与局限
- 绑定 Modal 云:它是”on Modal”的 SDK。你需要
modal setup认证、在 Modal 的云 GPU 上跑,不是本地或自有集群方案。想要在自己的 Slurm/机房跑 RL,这个 SDK 帮不上——它卖的是”Modal 云上开箱即用”。 - 依赖 Git 主分支安装:目前通过
git+https://.../training-gym.git@main安装,意味着跟的是 main 分支,生产使用要自己 pin 版本。 - Python 3.12 硬要求:环境有门槛。
- 奖励函数仍要自己写对:SDK 替你跑系统,但 reward function 的设计(怎么解析输出、怎么防 hack、怎么防止 reward hacking)仍然决定训练成败——它不替你判断奖励信号合不合理。
- 模型适配是手工维护的配方:支持列表是 Modal 团队逐个适配的,新模型要等他们加 recipe,不是任意 HF 模型都能直接跑。
六、适用与不适用
适合:想快速验证一个 RL 想法、又不想花几周搭多机分布式训练基础设施的研究者和小团队;已经在用 Modal、或愿意把训练跑在云上的人;想让 coding agent 帮忙跑 RL 实验的人。
不适合:要在自有机房/裸金属集群做训练的团队(它是 Modal 云绑定的);需要深度定制训练循环、超出其 recipe 抽象的高级研究者;想离线、零云依赖的场景。
七、它意味着什么
Training Gym 的信号是:RL 后训练的竞争正在从”谁能搭起分布式系统”转向”谁能把这层系统做得像调 API 一样简单”。当一个团队只需要写一个奖励函数和一个配置就能在云上拉起一次多卡 RL 训练,RL 实验的迭代成本被砍到了原来的零头——这意味着更多小团队能负担得起”用 RL 打磨自己模型”这件过去只有大厂玩得起的事。它和 Modal 云深度绑定是商业上的必然,也意味着它的”开箱即用”是建立在你愿意把训练负载交给 Modal 的前提上的。对想快速上手 RL 后训练的人,这是目前门槛最低的路径之一。