Mistral OCR:把 PDF 变成 Markdown 的 1 美元千字新基准
阅读时间: 大约 11 分钟
Mistral OCR:把 PDF 变成 Markdown 的 1 美元千字新基准
Mistral OCR(模型 ID mistral-ocr-latest / mistral-ocr-2503)是 Mistral AI 于 2025 年 3 月 6 日发布的文档 OCR API。它的定位不是”把图片里的字打出来”,而是把 PDF/图片结构化地还原成带版面顺序的 Markdown 文本与切分图片,直接喂给下游 RAG 系统。API 定价 1 美元 / 1000 页,批量任务减半。本文基于 Mistral 官方公告、Azure AI Foundry 模型目录与第三方复评数据做分析。
一、背景:RAG 的瓶颈不在大模型,在 PDF
过去两年大模型上下文窗口从 8K 涨到百万 token,但企业知识库的第一关从来不是”模型读不读得动”,而是”PDF 能不能被干净地读出来”。扫描件、双栏论文、嵌套表格、LaTeX 公式、混排图片——传统 OCR 引擎(Tesseract、各家云 OCR)输出的纯文本会把版面结构彻底打碎,导致向量检索时表格行列错位、公式变成乱码。
Mistral OCR 押注的就是这个痛点:直接用多模态大模型”看懂”整页版面,输出按阅读顺序交错排列的文本块与图片块。
二、它是什么:OCR + 理解的组合
按 Azure AI Foundry 上 Mistral 官方提供的模型目录页:
- 输入:图片或 PDF;
- 输出:
.md格式——按阅读顺序交错的文本与切分出的内嵌图片;需要 JSON 时官方建议串联 Mistral Small 3.1 做二次格式化; - 上下文长度:128,000 tokens;
- 语言:官方宣称可解析”数千种文字、字体与语言”,Azure 目录标注 27 种语言;
- 定位:轻量、低时延,官方称单节点可处理每分钟数千页(InfoQ 报道中具体为 2000 页/分钟);
- 已有落地:Le Chat 的默认文档理解模型,供数百万用户使用;权重(mistral-ocr-2503)在 Hugging Face 开放。
工程限制(InfoQ 引述官方):单文件 ≤50MB、≤1000 页。
三、官方基准:全面领先,但要看清测试集
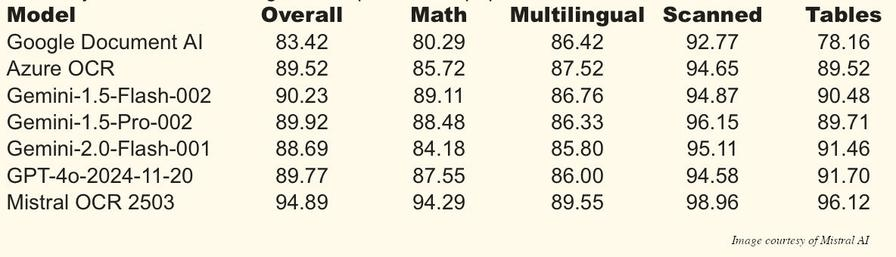
Mistral 在官方公告中给出的对比(见上图),测试集是 Mistral 自有的 “text-only” 内部测试集——样本为各类出版论文与网络 PDF:
| 模型 | Overall | Math | Multilingual | Scanned | Tables |
|---|---|---|---|---|---|
| Google Document AI | 83.42 | 80.29 | 86.42 | 92.77 | 78.16 |
| Azure OCR | 89.52 | 85.72 | 87.52 | 94.65 | 89.52 |
| Gemini-1.5-Flash-002 | 90.23 | 89.11 | 86.76 | 94.87 | 90.48 |
| Gemini-1.5-Pro-002 | 89.92 | 88.48 | 86.33 | 96.15 | 89.71 |
| Gemini-2.0-Flash-001 | 88.69 | 84.18 | 85.80 | 95.11 | 91.46 |
| GPT-4o-2024-11-20 | 89.77 | 87.55 | 86.00 | 94.58 | 91.70 |
| Mistral OCR 25.03 | 94.89 | 94.29 | 89.55 | 98.96 | 96.12 |
另一项”Fuzzy Match in Generation”指标上,Mistral OCR 为 99.02,高于 Azure OCR(97.31)、Gemini-2.0-Flash(96.53)、Google Document AI(95.88)。
分语言准确率(节选,Azure 目录页):
| 语言 | Azure OCR | Google Doc AI | Gemini-2.0-Flash | Mistral OCR 2503 |
|---|---|---|---|---|
| 中文 zh | 91.40 | 90.89 | 91.85 | 97.11 |
| 法语 fr | 97.50 | 96.36 | 97.06 | 99.20 |
| 德语 de | 98.39 | 97.09 | 97.19 | 99.51 |
| 西班牙语 es | 98.54 | 97.52 | 97.75 | 99.54 |
| 印地语 hi | 96.45 | 95.65 | 94.99 | 97.55 |
| 土耳其语 tr | 95.91 | 93.85 | 94.66 | 97.00 |
四、定价与成本结构
| 计费方式 | 价格 | 说明 |
|---|---|---|
| 同步 OCR | $1 / 1000 页 | /v1/ocr 端点 |
| 批量 OCR | $1 / 2000 页(五折) | 异步 .jsonl 批量提交 |
需要注意:这只是”识别”这一步的价格。OCR 输出的 Markdown 如果还要再交给 Mistral Small 3.1 做 JSON 结构化或摘要,那是另一笔 token 费用——官方推荐的”OCR + Small 3.1”流水线,实际成本要两段相加。
五、评测方法批判与口径偏差
官方数据很漂亮,但有几个必须拆开的点:
- 测试集是自己的、不公开。 上表来自 Mistral 内部 “text-only” 测试集,论文/公开数据集均未发布,第三方目前无法在同一套题目上复算。这属于典型的”自证基准”。
- 对比口径本身被设计成有利于自己。 官方承认:其他 LLM 对比项”不具备抽内嵌图片的能力”,所以特意只在文本维度上评测。也就是说,图表里”碾压 GPT-4o/Gemini”的部分,是把对方放在自己擅长维度的缩水版上比较。
- “数千种语言” vs 实测 27 种。 官方文案强调”覆盖所有大洲的数千种文字、字体”,但 Azure 目录明确标注支持 27 种语言,且分语言表里没有列出的小语种(如阿拉伯语、泰语、越南语)准确率无数据。
- 第三方复评并不全是好消息。 一篇 2026 年的法语 PDF 转 Markdown 专项评测(arXiv:2602.11960)中,mistral-ocr-latest 在干净文档上得分 0.993(最高),但在手写体上只有 0.170、图形 0.286——它本质上是印刷体文档模型,手写识别不是强项。
- “每分钟 2000 页”是单节点峰值口径。 未说明并发、页面复杂度、是否含排队开销,生产环境按此规划容量需自行压测。
六、优势与局限
优势:
- 价格屠夫:$1/1000 页、批量 $0.5/1000 页,把 RAG 预处理的边际成本打到极低;
- 版面还原度好:按阅读顺序输出 Markdown + 切图,天然适配 RAG/知识库入库;
- 官方称唯一同步抽内嵌图:表格、公式(LaTeX)、图片一并还原,不用再二次切图;
- 已在 Le Chat 大规模验证,不是纸面 Demo。
局限:
- 手写体、强图形场景弱,第三方复评暴露明显短板;
- 官方基准不可复现,对外宣传的”全面领先”需打折采信;
- 单文件 ≤50MB / ≤1000 页,超大型 PDF 需自行切分;
- 结构化输出需串联第二个模型,端到端成本不是只算 OCR 那一美元。
七、谁该用它
- 知识库/RAG 团队:大量历史 PDF、扫描论文、技术文档要入库;
- 数字化项目:历史文献、档案、手册的批量电子化;
- 客服与法务:把手册、条款变成可检索、可问答的语料。
对手写单据、复杂工程蓝图,建议先小批量实测再全量切换。