Memray:Bloomberg 开源的 Python 内存分析器,能穿透到 C/C++ 扩展
阅读时间: 大约 12 分钟
Memray:Bloomberg 开源的 Python 内存分析器,能穿透到 C/C++ 扩展
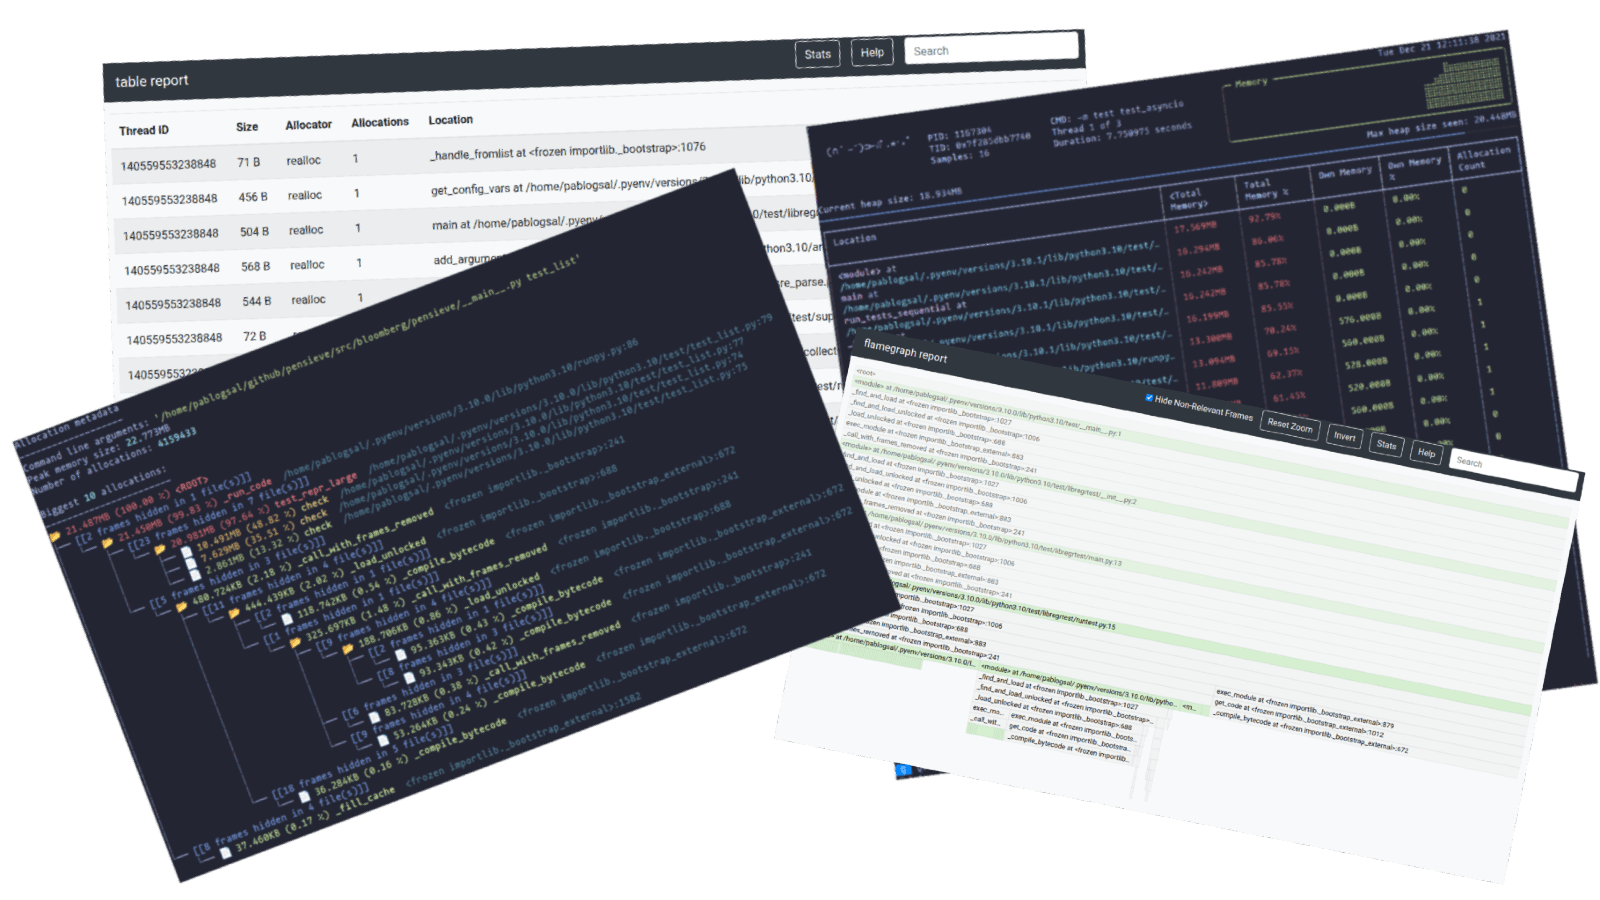
Python 长期有个尴尬现实:业务代码是 Python 写的,但真正吃掉内存的往往是 numpy、pandas、PyTorch 这类 C/C++/Rust 扩展。传统内存工具要么只看 Python 层、要么是采样式抽样,很难把”谁分配了内存”这条调用链完整地拼出来。Memray 是金融信息巨头 Bloomberg 在 2022 年 4 月开源的 Python 内存剖析器(memory profiler),以 Apache-2.0 协议发布,目标就是把从 Python 代码到原生扩展的每一次分配都追踪到底。本文基于 bloomberg/memray 仓库与官方文档,梳理它的机制、报告形态,以及官方自己标注的平台局限。
一、背景动机:为什么需要”全栈”内存剖析
Python 生态里做内存分析的工具不少(memory_profiler、guppy、objgraph、tracemalloc 等),但普遍有两类短板:一是采样式——每隔一段时间打断程序看一眼栈,错过的分配就永远看不到;二是只看 Python 对象层——一旦分配发生在 C 扩展里,栈就断了,你只知道”pandas 操作后内存涨了”,却不知道具体是哪一行原生调用。Bloomberg 内部跑着大量数据密集型 Python 任务,对定位内存泄漏、找出临时分配热点有刚需,于是做了 Memray。
二、是什么:概念与定位
按官方定义,Memray 是一个 memory profiler for Python:它能追踪 Python 代码、原生扩展模块乃至 Python 解释器自身的内存分配,并生成多种报告。它既可以当 CLI 工具用,也可以作为库嵌入代码做更精细的剖析。
几个标志性能力(来自官方 README):
- 追踪每一次函数调用,而非采样,因此能准确还原调用栈;
- 穿透到 C/C++ 原生调用,让整条调用栈(包括 Rust/C++ 扩展)都出现在结果里;
- 性能开销小:官方称仅轻微拖慢应用;开启原生追踪会慢一些,但可按需开关;
- 同时支持 Python 线程与原生线程(C 扩展里的 C++ 线程);
- 能生成火焰图等多种报告。
安装很简单:python3 -m pip install memray。它要求 Python 3.9+(README 口径)/ 官方文档支持 Python 3.8 起所有未 EOL 版本,目前到 3.14,且只支持 CPython;发布形式是带 C 扩展的二进制 wheel。
三、技术机制:插桩 + 分配追踪,产出 .bin 再离线分析
Memray 的工作方式是”先记录、后分析”:
- 用
memray run启动你的脚本或模块(memray run -m your_module),运行过程中把所有分配事件记录到一个二进制文件(如memray-my_script.2369.bin); - 再用报告子命令把这个 .bin 转成不同视图。CLI 共提供
run / flamegraph / table / live / tree / parse / summary / stats八个子命令:flamegraph:生成 HTML 火焰图,展示峰值内存;table:生成 HTML 表格,列出峰值时的所有分配记录(线程、大小、分配器、次数、位置);live:在终端里实时监控分配情况;tree / summary / stats:终端内的树状视图、函数摘要与高层统计。
这种”记录与分析分离”的设计很关键:剖析本身在目标进程里跑,报告渲染是离线的 HTML/TUI,不会在被剖析进程里再塞一个沉重的 UI。官方还提供了 pytest-memray 插件,可以在 pytest 里给每个测试出内存摘要,甚至给每个测试设内存上限,防止内存回退。
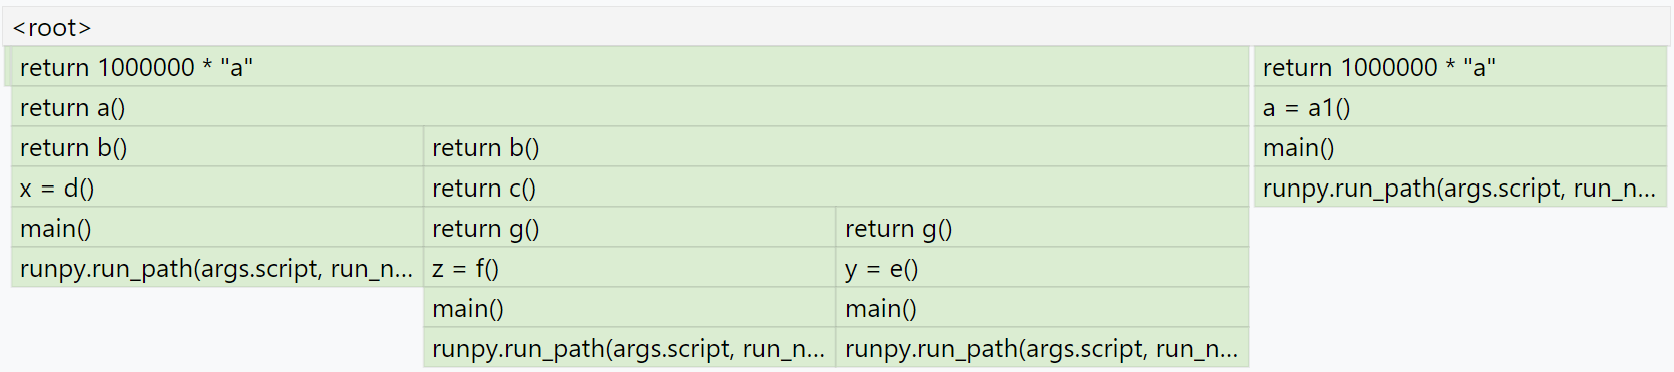
上图是官方文档里的反向火焰图示例:与普通火焰图”自顶向下看调用者”不同,反向火焰图把”分配最多的函数”放到最显眼位置,特别适合定位”到底是哪个调用点制造了这一大块内存”。
四、关键数据与能力边界
| 维度 | 官方口径 |
|---|---|
| 协议 | Apache-2.0 |
| 支持解释器 | 仅 CPython |
| 支持 Python 版本 | 3.8 起所有未 EOL 版本(当前至 3.14) |
| 操作系统 | Linux 体验最佳;macOS 11+;官方称”不太可能”支持 Windows |
| CPU 架构 | Linux: i686 / x86-64 / aarch64;macOS: x86-64 与 arm64(Intel + Apple Silicon) |
| libc | glibc 与 musl;遵循 manylinux2014 |
| 运行时要求 | 需要 C++17 运行时 |
| 原生追踪 | 支持 C/C++/Rust 调用栈与原生线程 |
| 多进程 | 可跨 fork 追踪,但不能跨 exec 追踪 |
五、评测方法批判:官方自己写明的平台 nuance
这是 Memray 最需要说清楚的部分——它的”快”和”全栈”都是有前提的:
- Windows 基本无望。官方明确写道:Memray 所用的检测内存分配的基本技术在 Windows 上理论可行,但库里很大一部分需要为非 POSIX 平台重写,而当前维护者没有这方面能力,因此”we are unlikely to ever support Windows”;官方只在 WSL 里做测试。Windows 本地开发者别想直接
pip install用原生能力。 - macOS 是”二等公民”。官方原话:在 Linux 上体验最好;macOS 虽所有功能都能跑,但由于 macOS 应用与 Python 库的典型分发方式,原生调用栈往往质量不佳、难以阅读甚至缺失函数调用。
- macOS 多进程有个具体坑:Memray 能跨
fork追踪,但不能跨exec追踪——一旦子进程调用os.exec起新解释器,新进程里的分配就报不到了。而 macOS 默认的 multiprocessing 启动方式恰恰是 “spawn”(底层用 exec),这意味着在 Mac 上用多进程,子进程内存经常抓不到。 - Cython 函数不会出现在 Python 栈里,即使 Cython 模块开了 profiling;要看 Cython 内部必须开原生追踪。
- greenlet 是实验性支持,在已有 greenlet 线程里再用 API 开启追踪,可能报出错误的栈。
- 官方称”blazing fast / 仅轻微拖慢”,但同时承认开启原生追踪会明显变慢——这个”快”是关掉原生栈时的口径,做原生剖析时要自己接受性能开销。
六、适用 / 不适用场景
适合:
- Linux 服务器上排查高内存占用、内存泄漏、分配热点;
- 大量使用 numpy/pandas/PyTorch 等 C 扩展、需要把栈穿透到原生层的项目;
- 想把内存基线纳入 CI(pytest-memray 设上限防回退)。
不适合 / 需注意:
- 想在 Windows 原生环境用——只能走 WSL;
- 在 macOS 上做深度原生栈分析——栈可能残缺,重要结论建议回到 Linux 复现;
- 依赖 macOS 默认 spawn 多进程、又想统计子进程内存——抓不全;
- 追求零侵入”开箱即快”——开原生追踪有可观测的性能代价。
七、客观分析:优势与局限
优势:
- 栈穿透能力是差异化卖点:Python + C/C++/Rust + 原生线程一把抓,这在开源 Python 内存工具里不多见;
- 全量插桩而非采样,不遗漏小分配,适合定位泄漏;
- 记录/分析分离,报告生态完整(火焰图、表格、TUI、pytest 插件);
- Bloomberg 背书 + Apache-2.0,可商用、治理友好。
局限:
- 平台面窄:无 Windows 原生支持,macOS 原生栈质量打折;
- 不能跨 exec 追踪,踩到 spawn 多进程就丢数据;
- 只支持 CPython,PyPy 等解释器不在支持范围;
- 原生追踪有性能开销,“快”是有条件的。
八、它意味着什么 / 谁该关注
Memray 把 Python 内存分析从”只能看 Python 对象”推进到了”能看到整条原生调用链”,对数据密集型和机器学习类 Python 项目价值尤其大。但它的官方文档非常诚实地把平台边界写在了明处:最佳体验在 Linux,macOS 可用但有原生栈与 spawn 多进程的坑,Windows 原生基本不支持。如果你是 Linux/容器化环境下的 Python 工程师,Memray 值得直接纳入排查工具箱;如果你主要在 Mac 或 Windows 本机开发,建议把它跑在与生产一致的 Linux 容器里下结论,而不是轻信本机看到的栈。