Mem0:给 AI Agent 补上"长期记忆"这一层
阅读时间: 大约 11 分钟
Mem0:给 AI Agent 补上”长期记忆”这一层
大模型本身是”无状态”的——每一次对话请求结束,模型就对上一轮发生了什么一无所知。要做出”记得用户偏好、越用越懂你”的 AI 助手或客服机器人,就得在模型外面自己拼一层记忆系统。Mem0(读作 “mem-zero”)就是这个赛道里目前声量最大的开源项目之一:YC S24 出身、Apache 2.0 协议、GitHub 仓库 mem0ai/mem0,并配套一个商业托管平台。本文基于其官方 GitHub README、文档与论文(arXiv:2504.19413),分析它到底做了什么、官方 benchmark 怎么读,以及哪些数字对开源用户并不成立。
一、背景:为什么 Agent 需要”记忆层”
大多数 LLM 应用的默认形态是”无状态”的:用户每开一个新会话,Agent 从零开始,上一次说过的偏好、历史工单、正在跟进的项目全部丢失,于是系统只能反复追问同样的信息,体验又重复又”健忘”。
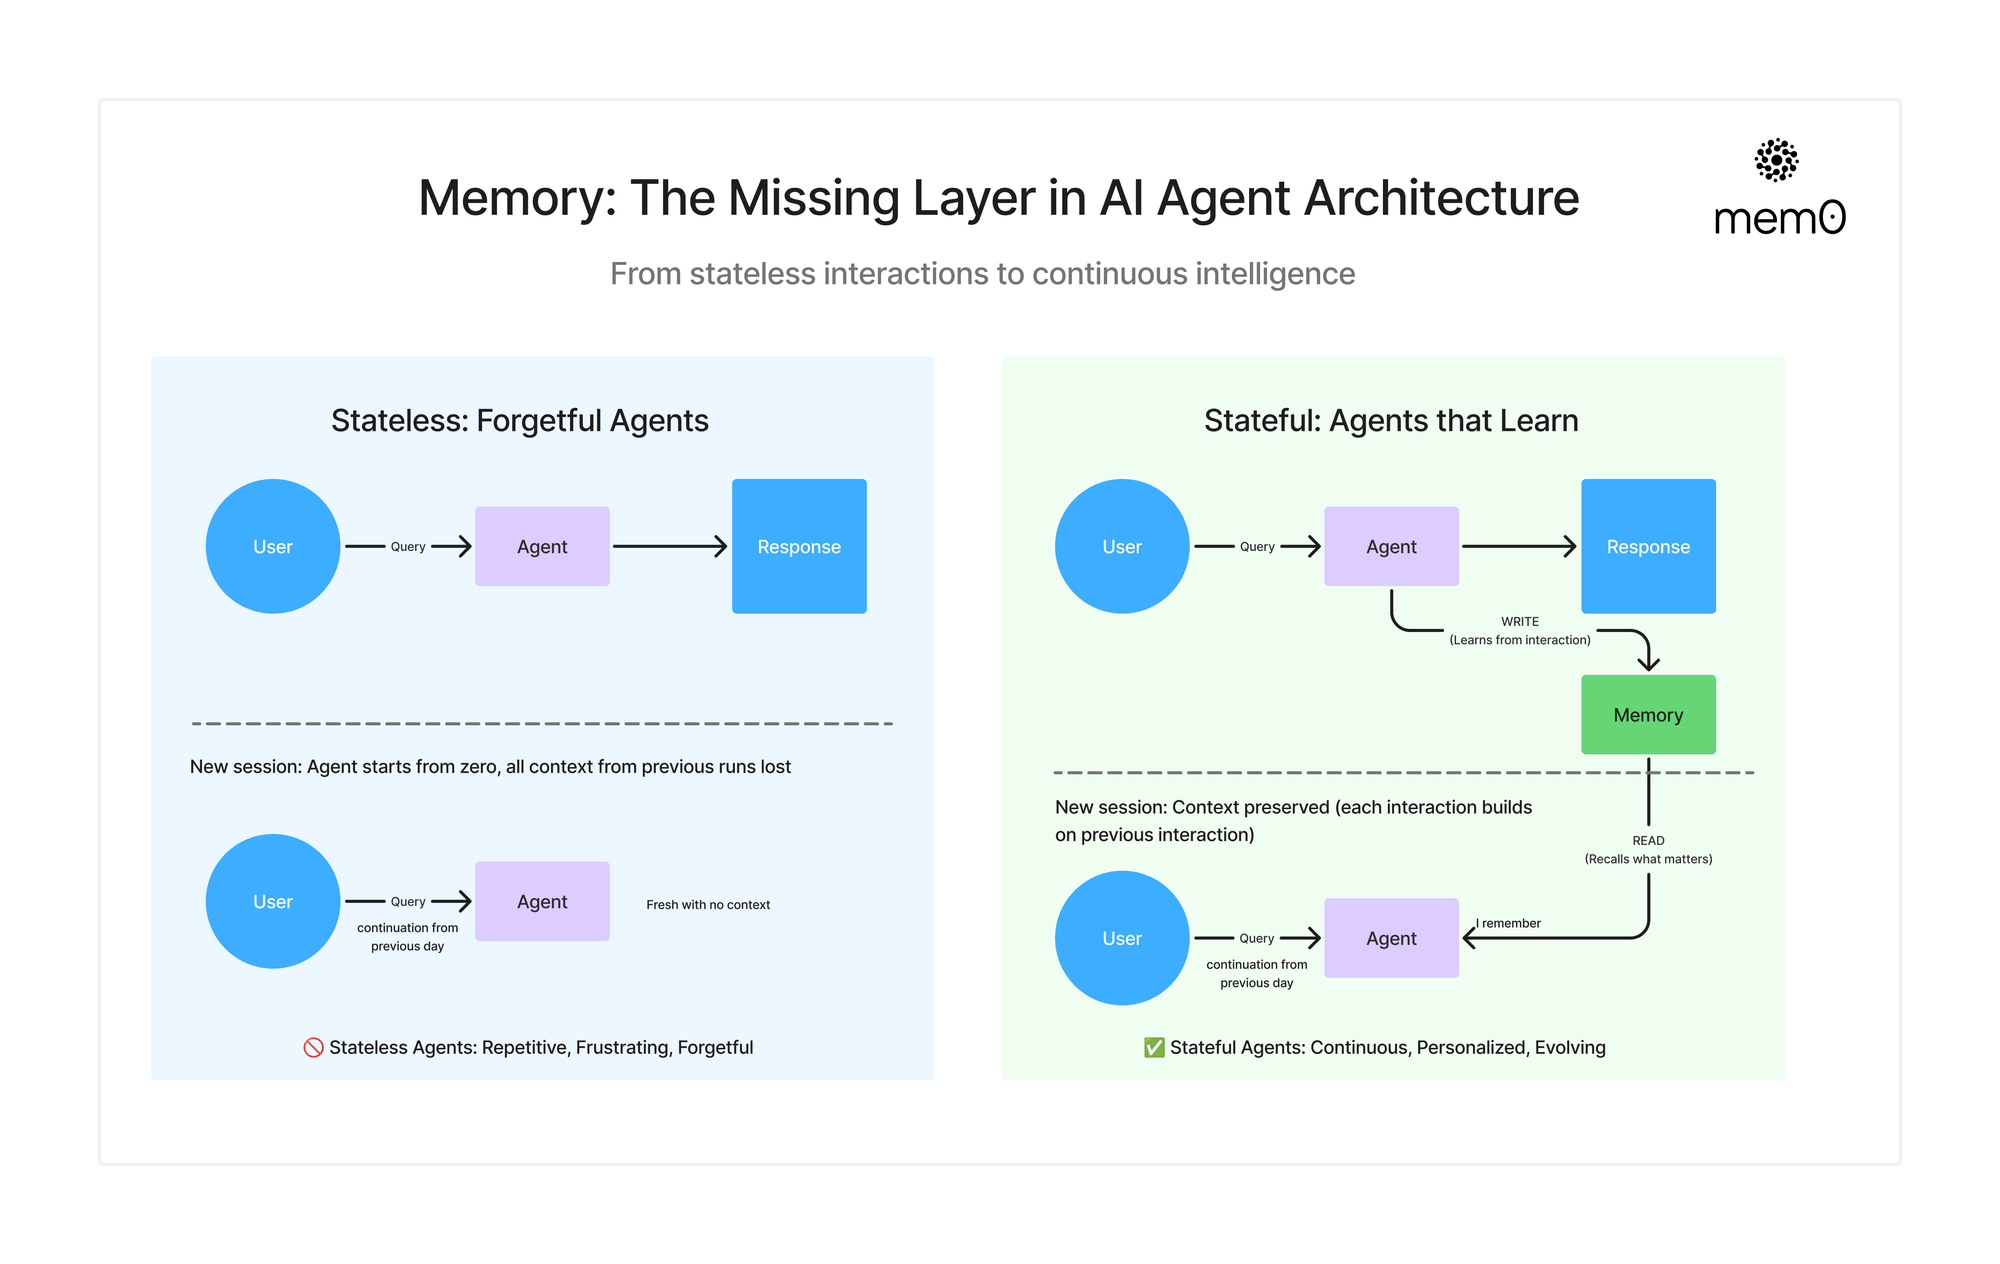
官方这张图把问题讲得很直白:左边是 Stateless——“新会话 Agent 从零开始,上一轮上下文全丢”;右边是 Stateful——每次交互先把新事实 WRITE 进 Memory,下次会话再 READ 出来拼接进上下文。Mem0 的定位就是中间这层绿色的 Memory:它不是模型,也不是业务库,而是一个专门负责”记住用户是谁、喜欢什么、之前发生过什么”的中间件。
二、它是什么:一个可插拔的记忆中间件
Mem0 官方自我定位是 “The Memory Layer for AI Agents”,主打三件事:
- 多层记忆:同时维护 User(用户偏好)、Session(会话内)、Agent(Agent 自身状态)三类记忆;
- 开发者友好:
pip install mem0ai即可起库,也有 npm 包;生产上提供自托管 Server(docker compose up,默认http://localhost:3000)和零运维的 Cloud Platform(app.mem0.ai); - 与主流栈解耦:本身需要一个 LLM 来做记忆抽取(默认 OpenAI
gpt-5-mini),并默认用text-embedding-3-small做向量嵌入,可换成其他模型。
换句话说,它不是又一个聊天产品,而是给任何 LLM 应用”加记忆”的基础设施层。典型用法是在每轮对话后把消息丢进 memory.add(),再在生成回复前用 memory.search() 把相关记忆捞出来拼进 system prompt。
三、技术机制:ADD-only 抽取 + 多信号检索
2026 年 4 月,Mem0 上线了一套新的记忆算法,核心变化是把过去”抽取—更新—删除”的多步写流程,改成了**单次、只增不改(ADD-only)**的抽取:一次 LLM 调用完成记忆抽取,记忆只累积、不被覆盖。
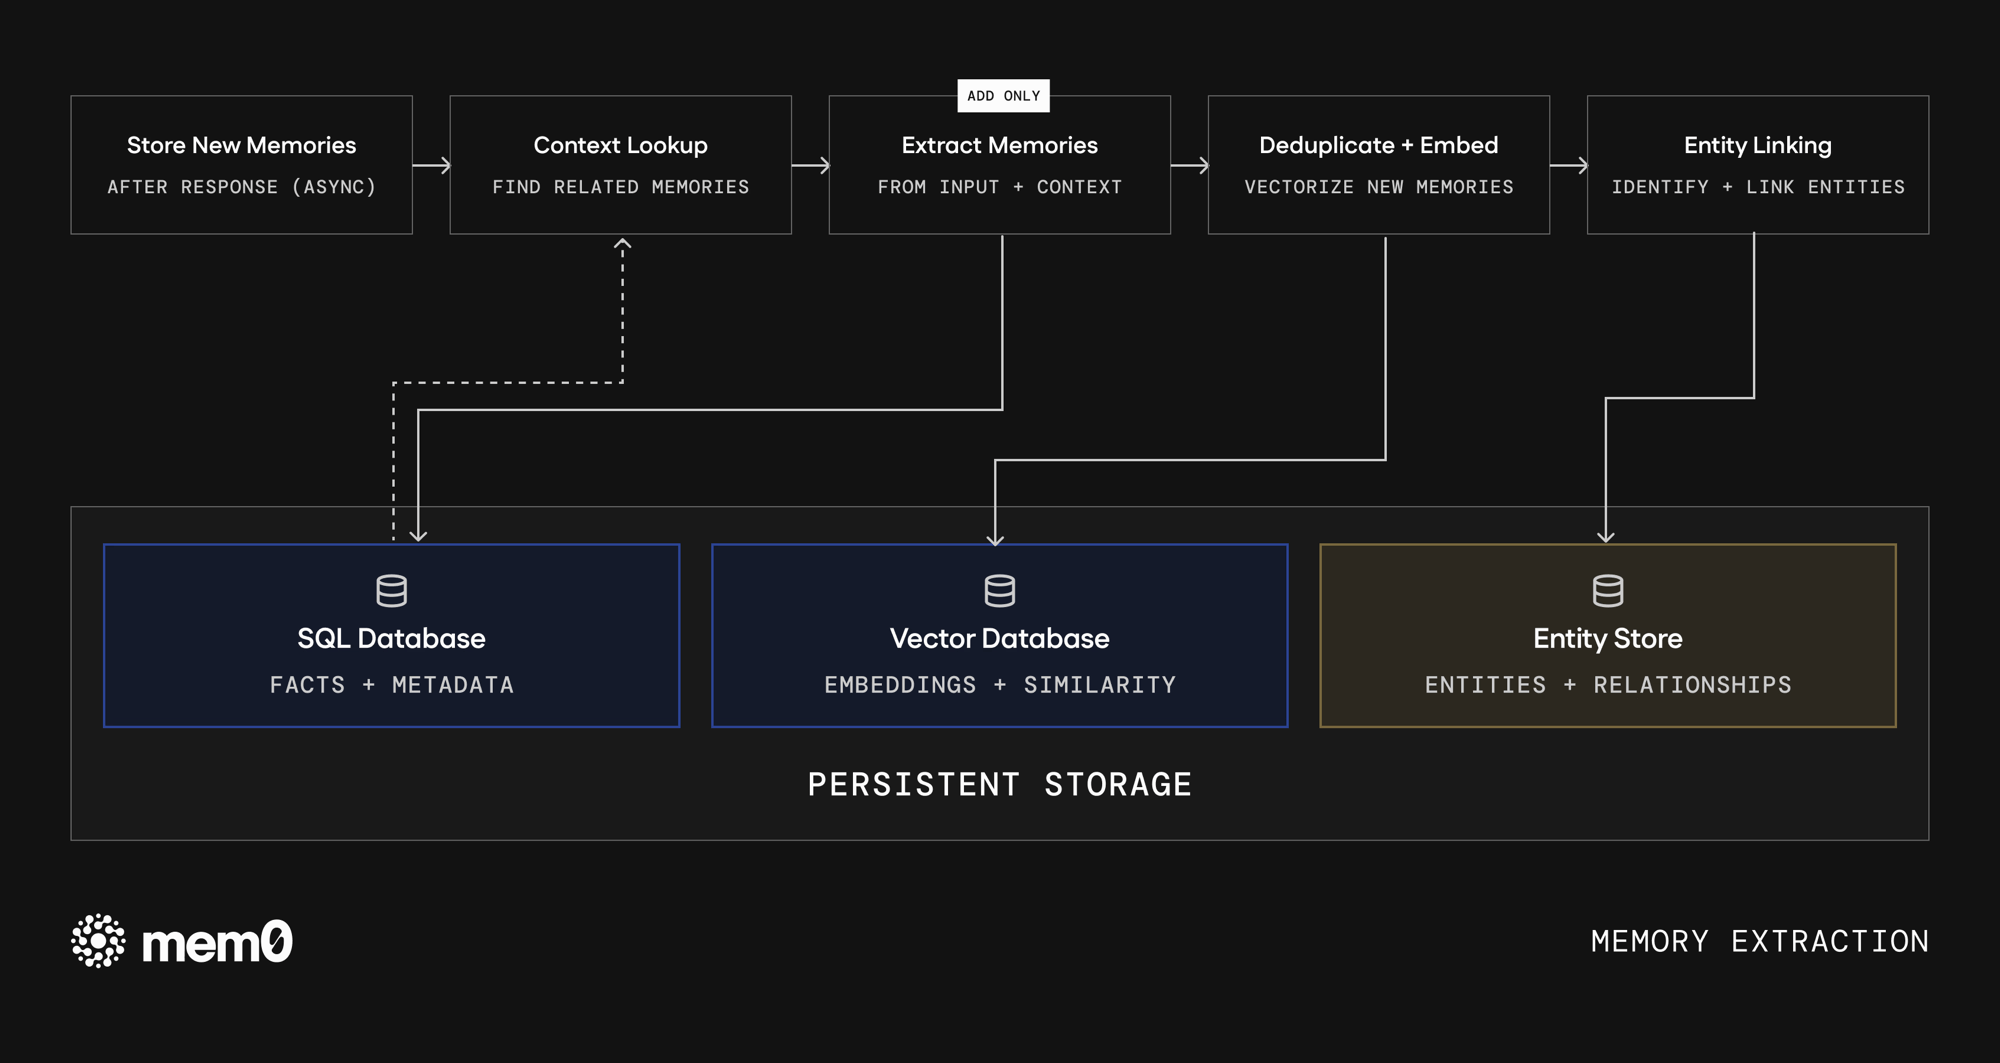
这张官方管线图对应 README 里列的几个机制点:
- Single-pass ADD-only extraction:一次 LLM 调用,没有 UPDATE/DELETE,记忆只追加;
- Agent-generated facts 一等公民:Agent 自己确认过的动作(如”已帮用户退订”)与用户口述事实同等权重存储;
- Entity linking:抽取实体后做嵌入并跨记忆链接,用于检索加权;
- Multi-signal retrieval:语义向量、BM25 关键词、实体匹配三路并行打分后融合;
- Temporal reasoning:带时间感知的检索,回答”现在状态/过去事件/未来计划”时挑对时间点。
落盘侧则是三类存储分工:SQL Database 存事实与元数据、Vector Database 存嵌入与相似度、Entity Store 存实体与关系。
四、关键数据:官方基准怎么读
下表是 README “New Memory Algorithm (April 2026)” 一节给出的官方数字(对比旧算法):
| 基准 | 旧算法 | 新算法 | 消耗 Tokens | 检索延迟 p50 |
|---|---|---|---|---|
| LoCoMo | 71.4 | 92.5 | 7.0K | 0.88s |
| LongMemEval | 67.8 | 94.4 | 6.8K | 1.09s |
| BEAM (1M) | — | 64.1 | 6.7K | 1.00s |
| BEAM (10M) | — | 48.6 | 6.9K | 1.05s |
官方同步给出的”亮点”是:LoCoMo 从旧版提升约 21 分,LongMemEval 提升约 27 分(其中 assistant memory recall 达 98.2),并在 1M token 规模的生产级记忆评测 BEAM 上拿到 64.1。
五、评测方法批判:这些数字开源用户未必拿得到
这一节是本文最想提醒读者的地方。README 在表格正下方其实自己写明了口径,只是容易被略过:
“Scores reflect Mem0’s managed platform, which includes proprietary optimizations not available in the open-source SDK; open-source users should expect directionally similar gains but not identical numbers.”
翻译过来就是:上面这套 92.5 / 94.4 的亮眼分数,跑在 Mem0 自家托管平台上,其中包含开源 SDK 里没有的专有优化;开源用户”方向上类似”,但拿不到一模一样的数字。 也就是说,把 README 的基准截图直接当成”自部署 Mem0 能达到的水平”是误读。
此外还有几层偏向需要注意:
- 检索配置是最优档:官方说明测试是 “single-pass retrieval (one call, no agentic loops) at a top_200 retrieval budget”——单次检索、无 Agent 循环、top_200 预算,属于精心调好的最佳配置,不是随手一接的默认表现;
- 模型栈不透明:测试跑在”同一套生产代表性模型栈”上,但具体是哪个 LLM + 哪个嵌入模型组合,README 没有逐项列出,第三方难以完全复现(官方称其 evaluation framework 已开源,可自行复现);
- 规模衰减真实存在:BEAM 从 1M 的 64.1 掉到 10M 的 48.6,说明上下文规模上去之后,记忆检索质量是明显下滑的,1M 以上场景不能照搬 1M 的预期;
- “省 80% 成本”是营销口径:Koala 项目库条目里提到”通过只发送相关数据给模型,最多可节省 80% 的 LLM 成本”。这是一个上限式的营销说法,而非在固定负载下实测出的平均值,实际省多少取决于你原本塞了多少冗余历史。
六、优势与局限
优势:
- 上手成本极低:库模式
pip install mem0ai三行代码接入,自托管 Server 一条docker compose up,商业平台零运维; - 算法确实有进步:ADD-only 抽取把写路径从多次 LLM 调用压到一次,p50 延迟控制在约 1 秒上下、每轮约消耗 7K tokens,工程上是划算的;
- 多信号检索方向正确:语义 + BM25 + 实体融合 + 时间感知,比纯向量检索更贴近真实记忆的检索方式;
- 协议友好:Apache 2.0,可商用,论文公开(arXiv:2504.19413)。
局限:
- 开源与托管存在性能鸿沟:核心 benchmark 数字归托管平台所有,自部署只能”方向类似”,想要表格里的分数基本得付费上云;
- 依赖外部 LLM 做抽取:记忆抽取本身要调一次模型,等于每次写记忆都有额外 token 成本和延迟,纯本地、零外部调用的诉求满足不了;
- 长规模下质量下滑:BEAM 10M 掉到 48.6,超大规模长期记忆仍未真正解决;
- “ADD-only 只增不改”是双刃剑:旧算法会 UPDATE/DELETE 去重纠错,新算法为省一次调用改为只追加,时间一长记忆库里可能累积过时或矛盾的事实,需要额外机制清理。
七、谁该关注
- 做个性化助手 / 客服机器人的团队:需要”记住用户偏好和历史工单”,又不想自己从零写抽取—存储—检索管线,Mem0 是目前接入成本最低的选择之一;
- 要私有化部署的团队:可以走自托管 Server,但要接受开源版拿不到官方 benchmark 里的最佳数字;
- 追求极致成本、可完全离线:Mem0 每次抽取都要调外部 LLM,这类场景应评估更轻量的纯本地方案;
- 1M token 以上超长生命周期 Agent:需要对 BEAM 10M 的掉点有预期,别把 1M 的成绩线性外推。