Marimo:把 Jupyter 重写成纯 Python 的反应式 Notebook
阅读时间: 大约 9 分钟
Marimo:把 Jupyter 重写成纯 Python 的反应式 Notebook
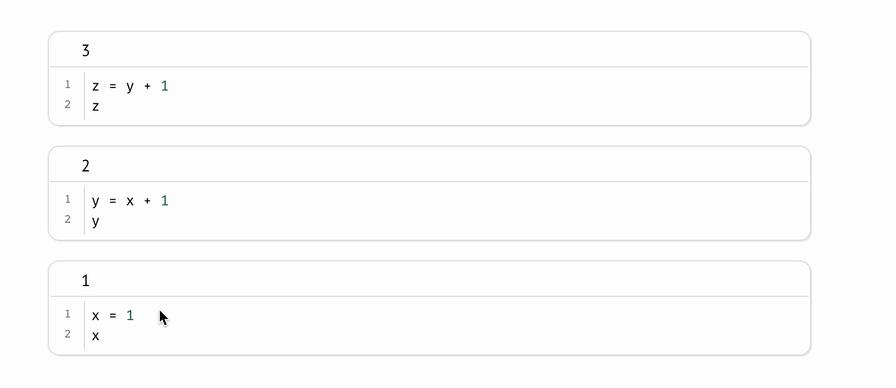
Jupyter Notebook 给数据科学带来了交互式探索,但也留下了一堆老大难问题:输出与代码不同步、“我刚才这个变量到底是什么值”、改了前面一个单元格后面全乱、.ipynb JSON 在 Git 里几乎不可读。Marimo 的目标就是把这些问题从根上重做——它自称”a next-generation Python notebook”,把 notebook 存成纯 .py 文件、按变量引用反应式执行。本文基于官网(marimo.io)与文档(docs.marimo.io)的一手资料做分析。
一、背景:传统 Notebook 的结构性痛点
Jupyter 的执行模型是”按你手动运行的顺序”,单元格之间没有依赖追踪。后果是:改了上游变量,下游输出就是”陈旧”的;删掉一个单元格,它定义的变量还在内存里(hidden state);.ipynb 是带输出的 JSON,Git diff 几乎没法看;想把 notebook 当脚本跑、当 App 分享,都要额外工具。Marimo 的设计就是冲着这一长串问题清单去的。
二、它是什么:开源反应式 Notebook
Marimo 是开源项目(NumFOCUS 附属项目,与 NumPy、SciPy、Matplotlib 同属一个社区组织),官网首页标注约 22.9k stars。官方文档点明它的核心承诺:运行一个单元格或交互一个 UI 元素,Marimo 会自动运行所有依赖它的单元格(或把它们标记为过期),让代码、输出、程序状态始终一致。它的灵感来源写明是 Pluto.jl、ObservableHQ 与 Bret Victor 的文章,属于”反应式数据流”这一大趋势。
三、技术机制:它具体怎么工作
从文档 Highlights 看,Marimo 的机制可归纳为:
- 反应式执行:静态分析代码中的变量引用,改了
x,所有用到x的单元格自动重跑;删除一个单元格,它的变量被从内存中清除(无隐藏状态); - 确定性执行顺序:执行顺序由变量依赖决定,而不是单元格在页面上的位置——你可以自由排版,让 notebook 更像”讲故事”;
- 惰性运行时(lazy runtime):对昂贵的 notebook,可配置为”只把受影响单元格标记为过期”而不自动运行,避免意外触发重计算;
- 纯
.py存储:notebook 就是合法 Python 文件,可 Git 管理、可当脚本python xxx.py执行、可作为模块 import、可用 pytest 测试; - 内置 SQL:SQL 单元格可查询 dataframe 与数据库,对接 Polars、Pandas、PyArrow、DuckDB、SQLite、Postgres、MySQL 等;
- 同步 UI 元素:滑块、下拉、dataframe 表格、可选图直接绑定 Python 变量,无需写回调。
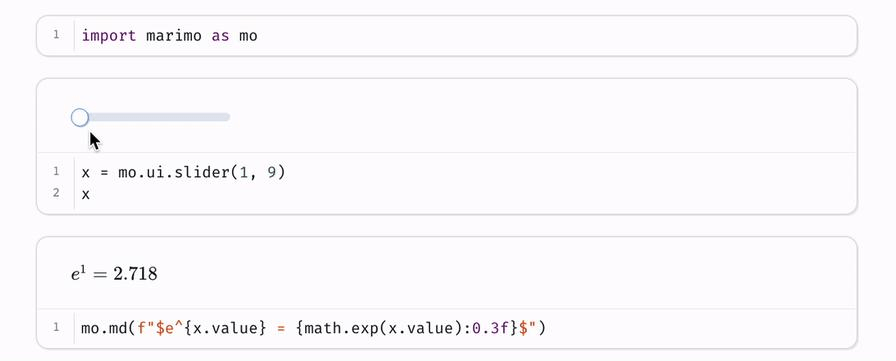
此外它还内置了包管理(可按 import 装包、按 PEP 723 在 notebook 里序列化依赖)、导出 WASM HTML、当 Web App 或幻灯片分享、VS Code 扩展与 PyCharm 插件、Vim 键位,以及面向 AI Agent 的 marimo pair(可对接 Claude Code、Codex 等)。
四、关键数据:官方口径
下表是从官网与文档核对到的信息(2026-10-02 时点):
| 指标 | 内容 | 出处 |
|---|---|---|
| GitHub Stars | 约 22.9k | 官网首页徽标 |
| 存储格式 | 纯 .py(Git 友好) | 官网 / 文档 |
| 执行模型 | 反应式,按变量引用确定性执行 | 文档 |
| 内置 SQL 后端 | Polars/Pandas/DuckDB/SQLite/Postgres/MySQL 等 | 官网 |
| 社区归属 | NumFOCUS 附属项目 | 文档页脚 |
| 资金来源 | 部分由美国 DOE CMEI/IESO 协议 34368 支持 | 文档致谢 |
| 自称替代对象 | jupyter、streamlit、jupytext、ipywidgets、papermill | 文档 Highlights |
五、评测口径批判:它是”替代”还是”换了范式”
需要清醒看待 Marimo 的几处宣传口径:
- “无隐藏状态 / 确定性执行”依赖静态变量引用分析。这对大多数常规 notebook 成立,但对动态
exec()、globals()、把同一变量当计数器反复原地改值这类 Jupyter 常见写法,反应式模型会判定依赖并重跑——它不是 Jupyter 的无痛升级,而是换了一套执行范式,迁移旧 notebook 时这类习惯写法需要改造; - “反应式自动重跑”本身有代价。正因为如此官方才额外提供惰性运行时(把受影响单元格标过期而非自动跑)——这等于官方承认自动重跑在贵 notebook 上既可能意外触发、也可能打断思路;
- “batteries-included,替代 jupyter/streamlit/…”是定位话术,不是功能对等声明;与 Streamlit 式”纯脚本拼 App”、Jupyter 插件生态的细节兼容性,仍要在具体项目里验证;
- 官网的名人背书与案例(Kaggle/Sumble、Pydantic、Bunkerhill、DNB、SLAC)都是合作方视角,属营销素材;
- Stars 是首页时点快照,且它有 DOE 科研经费背书(致谢页写明协议号),并非纯社区驱动项目,这点对关注治理模式的团队应知晓。
六、优势与局限
优势:
- 根治状态不同步:反应式 + 无隐藏状态,从机制上消除”陈旧输出”这类 bug;
- Git 与工程友好:纯
.py、可脚本化、可测试,天然契合现代 Python 工程流; - 数据能力内置:SQL 单元格 + dataframe 交互查看 + 包管理,少装一堆拼图工具;
- AI 原生:
marimo pair可对接主流编码 Agent,notebook 成为可被 Agent 操作的对象。
局限:
- 范式转变有迁移成本:旧 Jupyter 的动态 / 原地改值写法不能直接照搬;
- 自动重跑可能触发昂贵计算,需要配合惰性模式使用;
- 并非 Jupyter 生态的超集:特定 ipywidgets 生态、某些 Jupyter 插件的兼容要逐一验证;
- 背书与案例带营销性质,落地前建议在自身数据规模与团队习惯上试用。
七、适合谁、不适合谁
- 适合:受够了 Jupyter 状态混乱、希望 notebook 进 Git 与 CI、需要把分析一键变成可分享 App 或脚本的数据团队与研究者;
- 不适合:重度依赖 Jupyter 特定插件生态、或习惯大量动态原地改值写法且不愿改造的使用者——迁移前应先用
marimo convert转一个真实项目试水。