Malloy:Looker 创始人开源的语义建模查询语言,把 SQL 变成可复用模型
阅读时间: 大约 10 分钟
Malloy:Looker 创始人开源的语义建模查询语言,把 SQL 变成可复用模型
写 SQL 的人多半有过这种经历:一段”看起来对”的聚合,跑出来的合计数却怎么都对不上——join 放大了行数、不同粒度的 sum 被混在一起。Malloy 要解决的就是这类问题。它是一个开源的语义建模 + 查询语言,由 Looker 创始人 Lloyd Tabb 团队发起(诞生于美国加州 Santa Cruz),现在托管在 Linux 基金会旗下(Malloy a Series of LF Projects)。它不造数据库,而是写一种比 SQL 更结构化、可复用的语言,再编译成你所用数仓的 SQL。本文基于 malloydata.dev 官网与文档,拆解它的机制与定位边界。
一、背景动机:SQL 自由但不安全
官网把现状讲得很直白:SQL 给了最大的自由,却没有安全——计算没法被保存和复用到数据模型里,每个分析都从零写一遍;而像 LookML 这样的现有语义模型,虽然安全,却限制了分析的自由度。Malloy 的野心是把”语义模型的安全”和”关系查询语言的灵活”结合起来。它瞄准的是数据团队里反复出现的两类痛:一是业务口径(“活跃用户""GMV”)在不同报表间被各写各的、口径漂移;二是嵌套/层级报表要手写一堆 self-join 或 UNION。
二、是什么:一种编译成 SQL 的建模语言
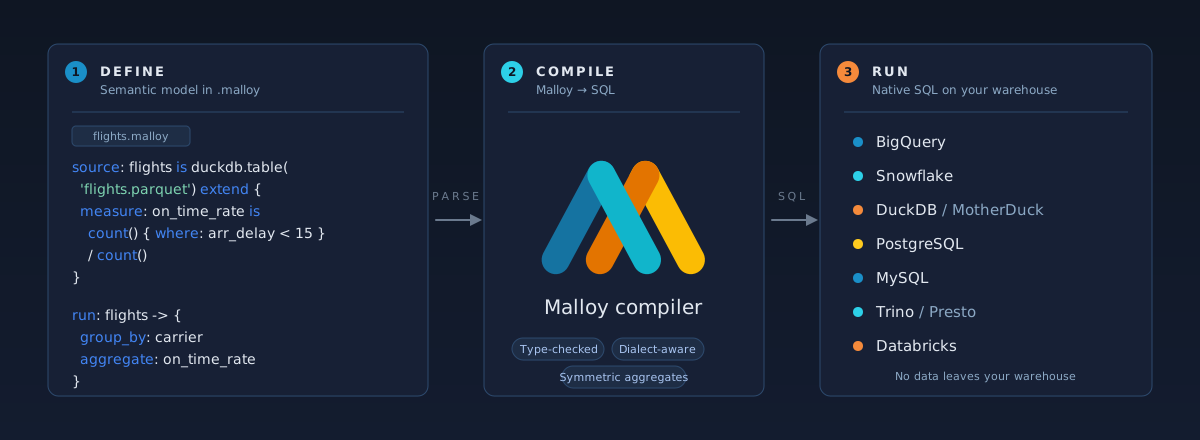
Malloy 本身不是数据库,也不执行计算。你在 VS Code 扩展里写 .malloy 模型和查询,Malloy 把它翻译成针对具体方言(BigQuery、Snowflake、Databricks、Trino/Presto、MySQL、PostgreSQL、DuckDB)优化过的 SQL,再丢给你已有的数仓跑。它提供:
- 语义模型(Model):把表关系、维度、度量、业务口径定义一次,到处复用;
- 查询(Query):用简洁、可读的语法表达分组、过滤、嵌套;
- 发布能力:REST API、React Publisher SDK、HTML 数据应用、Notebook,以及官方文档新列出的 MCP for AI Agents——让 LLM 直接对着语义模型提问。
三、技术机制:嵌套查询与对称聚合
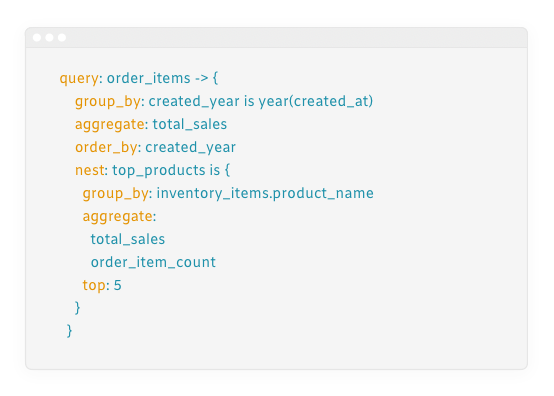
上面这张官方示例就是 Malloy 的核心卖点之一——嵌套查询。一条查询同时声明了两层粒度:
query: order_items -> {
  group_by: created_year is year(created_at)
  aggregate: total_sales
  order_by: created_year
  nest: top_products is {
    group_by: inventory_items.product_name
    aggregate:
      total_sales
      order_item_count
    top: 5
  }
}
“按年汇总销售额,并在每年里再嵌套 Top 5 商品”——在 SQL 里这要写 join、子查询或窗口函数,在 Malloy 里是一个可复用、可被别处引用的查询组件。
另一个关键机制是对称聚合(Symmetric Aggregates)。官网称它能”自动防止 sum、avg、count 这类聚合被算错”:当你在不同粒度之间切换、或模型里 join 了一对多关系时,Malloy 在编译期就阻止那种”行数被 join 放大后再 sum”的经典错误。Lloyd Tabb 本人对此的评价是”feels like magic”。
四、关键能力与生态:官方口径
| 项目 | 官方口径 |
|---|---|
| 项目归属 | Linux 基金会(Malloy a Series of LF Projects),开源 |
| 本质 | 语义建模 + 查询语言,编译为 SQL,非执行引擎 |
| 兼容数仓 | BigQuery、Snowflake、Databricks、Trino/Presto、MySQL、PostgreSQL、DuckDB |
| 主要入口 | VS Code 扩展、Malloy CLI、Python 包、Jupyter |
| 发布形态 | REST API、React Publisher SDK、HTML 数据应用、MCP for AI Agents |
| 与 dbt | 官方提供”Malloy for dbt Users”指引,定位互补 |
| 核心特性 | 嵌套查询、对称聚合、语义模型复用 |
五、评测方法与口径偏差
- “防止聚合算错”是编译期防护,不是运行时魔法:对称聚合确实能拦掉一类常见的 join-放大错误,但它依赖你在模型里正确声明关系基数;模型写错了,它不会替你发现业务口径错误;
- 性能取决于底层数仓:Malloy 只生成 SQL,真正的执行、成本、时延全在 BigQuery/Snowflake/Trino 那边。它”快”不代表数仓省,省不省取决于它生成的 SQL 质量与你的仓库;
- “比 SQL 易读”是主观主张:对熟悉 LookML/建模思路的人确实友好,但对纯写 SQL 的分析师有额外学习成本;
- 生态仍年轻:可视化主要靠官方 Explorer UI 与 Publisher,不是 Tableau/Looker 那种成熟 BI 市场;MCP for AI Agents 等能力较新,生产案例有限。
六、适用 / 不适用场景
适用: 已经有现代数仓(BigQuery/Snowflake/Databricks)、被”指标口径不统一”折磨的分析团队;想把业务逻辑沉淀成可复用语义层、并给 BI/AI 提问一个统一入口的团队;从 LookML 迁出、想要开源替代的人。
不适用: 还在 OLTP 库上直接跑即席查询、没有数仓的小团队(先建数仓更要紧);需要重型 ETL/数据转换工程的(那是 dbt 的地盘,Malloy 只做互补);团队不愿投入前期建模、只想随手写一次性 SQL 的场景。
七、客观分析:优势与局限
优势:
- 可复用的语义层:指标定义一次、处处一致,从根上减少口径漂移;
- 嵌套查询表达力强:层级报表不用手写一堆 join/子查询;
- 对称聚合降低出错率:把一类资深分析师才会踩的坑在语言层拦住;
- 不锁定数仓:编译成各方言 SQL,可跨仓库迁移;拥抱 AI(MCP)方向快。
局限(官方隐含或需警惕):
- 不是数据库:不解决存储与执行性能,TCO 仍压在数仓账单上;
- 前期建模投入:要先把模型、关系、度量定义好,才能享受复用红利,冷启动有成本;
- 生态与可视化较新:相比 Looker/Tableau,第三方集成与成熟 BI 组件少;
- 学习曲线:语法、模型组织、对称聚合的边界需要专门学习,并非”装了就会”。
八、它意味着什么 / 谁该关注
Malloy 代表了一个趋势:在独立数仓之上,语义层正在从商业 BI(LookML)里独立出来、变成开源的、可被人和 AI 共同消费的一层。它和 dbt(转换)、现代数仓(存储计算)一起,构成”转换—语义—消费”的新分层。对正在搭建指标体系、又不想被 Looker 商业许可绑定的团队,Malloy 值得做一次 PoC;但它是”建模投资换长期一致”,不是装上立刻见效的速效药。