LoRAX:单卡跑上千个微调 LLM 的多 LoRA 推理引擎
阅读时间: 大约 9 分钟
LoRAX:单卡跑上千个微调 LLM 的多 LoRA 推理引擎
LoRAX(LoRA eXchange)是 Predibase 开源的 LLM 推理框架,一句产品描述就是:在单张 GPU 上服务数千个微调模型,且不牺牲吞吐量与时延。它解决的是一个被大模型产品化长期忽视的问题——当你为每个客户/每个场景都微调了一个 LoRA 适配器时,推理成本怎么摊。本文基于其官方 GitHub README 做拆解。
一、背景:微调越多,部署越贵
大模型产品化的常见路径是:基座模型共享能力,但按租户、按业务线各自微调。传统做法是一个微调模型一个服务实例、一张 GPU——100 个租户就是 100 张卡,成本线性爆炸。而直接把所有请求打到 OpenAI 类 API 上,又拿不到专属于自己业务的微调效果,且 token 单价随调用量上涨。
LoRA(Low-Rank Adaptation)的发明本意就是”微调只存几十 MB 的小适配器”,但推理侧长期没有把这件事做穿:直到 LoRAX 出现,业界才有一个把”基座共享、适配器热插拔”工程化的开源引擎。
二、核心机制:三件套
LoRAX 基于 HuggingFace Text-Generation-Inference(TGI)fork 自 v0.9.4(Apache-2.0)二次开发,并借用了 Punica 项目的 SGMV 内核。它的架构由三个关键机制构成:
- 动态适配器加载(Dynamic Adapter Loading):请求里直接带
adapter_id(指向 HuggingFace Hub、Predibase 或本地文件系统上的 LoRA),运行时即时加载、不阻塞并发请求;还支持在单个请求里合并多个适配器做 ensemble。 - 异构连续批处理(Heterogeneous Continuous Batching):把不同适配器的请求打包进同一个 batch——这是它和 vLLM、TGI 原生”单模型批处理”的本质区别。官方声称:并发适配器数量增长时,时延和吞吐”几乎保持不变”。
- 适配器交换调度(Adapter Exchange Scheduling):在 GPU 显存与 CPU 内存之间异步预取/换出适配器,配合批处理调度优化整系统吞吐。
底层优化栈:张量并行、flash-attention、paged attention、SGMV kernel、bitsandbytes/GPT-Q/AWQ 量化、token streaming。
三、成本曲线:官方那张图说明什么
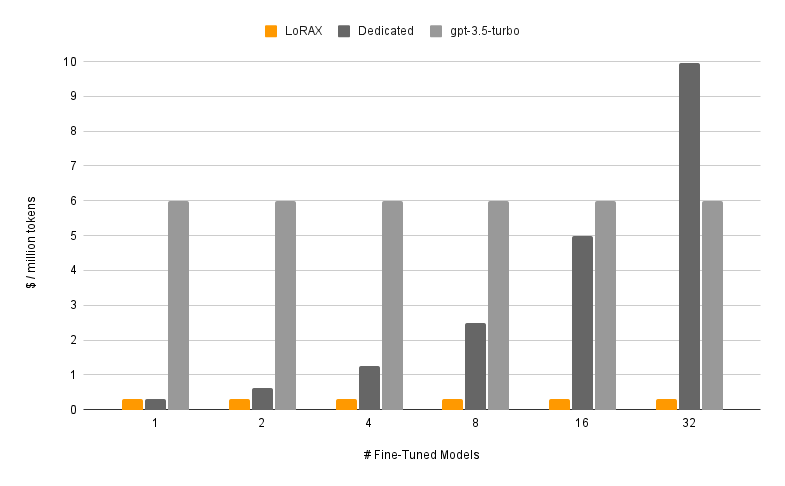
本文首图是 LoRAX README 里的官方成本对比,横轴是”已上线的微调模型数量”(1→32),纵轴是每百万 token 的成本(美元):
| 微调模型数 | LoRAX(共享基座) | 每模型独占 GPU | 调 gpt-3.5-turbo API |
|---|---|---|---|
| 1 | ~0.3 | ~0.4 | 6.0 |
| 2 | ~0.3 | ~0.7 | 6.0 |
| 4 | ~0.3 | ~1.3 | 6.0 |
| 8 | ~0.3 | ~2.5 | 6.0 |
| 16 | ~0.3 | ~5.0 | 6.0 |
| 32 | ~0.3 | ~10 | 6.0 |
读法很清楚:LoRAX 路线下,第 1 个模型和第 32 个模型的边际成本几乎不变;“每模型独占一张卡”的路线成本随模型数线性飙升,32 个模型时已到 10 美元/百万 token;而调商用 API(gpt-3.5-turbo 口径)则不管你多少模型,都固定 6 美元——也就是说,当你微调模型数量超过约 16 个之后,LoRAX 自部署反而比调 API 更便宜。
四、工程能力与使用方式
- 基座模型:Llama(含 CodeLlama)、Mistral(含 Zephyr)、Qwen 系列;fp16 或 bitsandbytes/GPT-Q/AWQ 量化加载;
- 适配器:兼容 PEFT、Ludwig 训练的 LoRA,任意线性层可适配;
- 接口:REST
/generate、Python client、OpenAI 兼容/v1/chat/completions(适配器名直接当model参数传),支持多轮对话与结构化 JSON 输出; - 生产件:预构建 Docker 镜像、Kubernetes Helm chart、Prometheus 指标、OpenTelemetry 分布式追踪、按请求租户隔离私有适配器;
- 硬件门槛:官方要求 Nvidia GPU(Ampere 架构及以上)、CUDA 11.8+、Linux。
五、评测方法与口径偏差
- “单卡服务上千个模型”是上限修辞,不是甜点。 官方原话是 “scales to 1000s of fine-tuned LLMs”。真实约束是显存:基座模型 fp16 占用大头,每个 LoRA 适配器虽小,但 GPU/CPU 之间的换入换出在适配器极多时会触发调度开销——官方的”时延几乎不随适配器数变化”成立于中等规模(图上到 32),上千个时的尾延迟需要自行压测。
- 成本图的对比基线选得有利。 “独占 GPU”路线按整卡价格摊销,本来就不是主流做法;gpt-3.5-turbo 的 6 美元/百万 token 是 2024 年中的旧价,与今天的 API 定价已不可比。这张图适合看”趋势”,不适合直接当预算依据。
- “不牺牲吞吐与时延”是官方承诺。 异构批处理把不同 LoRA 的请求塞进同一 batch,kernel 层面(SGMV)确实为这件事做了优化,但不同适配器的计算图形状差异会带来 padding 与内核切换开销,重度生产建议用官方 benchmark 脚本自测。
- 它是推理引擎,不是微调平台。 LoRAX 假设你已经用 PEFT/Ludwig 训好了适配器;“大规模微调”那部分成本和流程,由 Predibase 的商业平台承担,开源仓库本身不管。
- 硬件绑定 Nvidia + Ampere 以上,AMD/旧卡用户无缘;fork 自 TGI v0.9.4,与上游 TGI 新特性的合并节奏需关注。
六、优势与局限
优势:
- 多租户/多微调场景的成本拐点明确:模型越多越划算;
- Apache-2.0 完全开源可商用;
- OpenAI 兼容接口,现有应用改
base_url即可接入; - 生产件齐全:Helm、Prometheus、分布式追踪、租户隔离,不是玩具。
局限:
- 只服务”同一个基座 + 多个 LoRA”的场景,跨基座模型还是得多实例;
- Nvidia 硬件强绑定;
- 官方成本对比图的基线偏旧、偏理想化;
- 大模型快速迭代下,对新基座架构的支持滞后于 vLLM 等通用引擎。
七、谁该用它
- SaaS 平台:每个客户一个微调人格/一个垂直场景,基座共享;
- 垂直行业模型厂:同一基座(如 Llama/Mistral)派生几十个行业适配器,统一推理;
- 已经在 TGI 上跑、但需要多 LoRA 能力的团队,迁移成本最低。