LiteParse:LlamaIndex 开源的本地 PDF 解析器,2-5ms 一页
AI
RAG
开源
文档解析
2026/9/29
·
阅读时间: 大约 7 分钟
LiteParse:LlamaIndex 开源的本地 PDF 解析器,2-5ms 一页
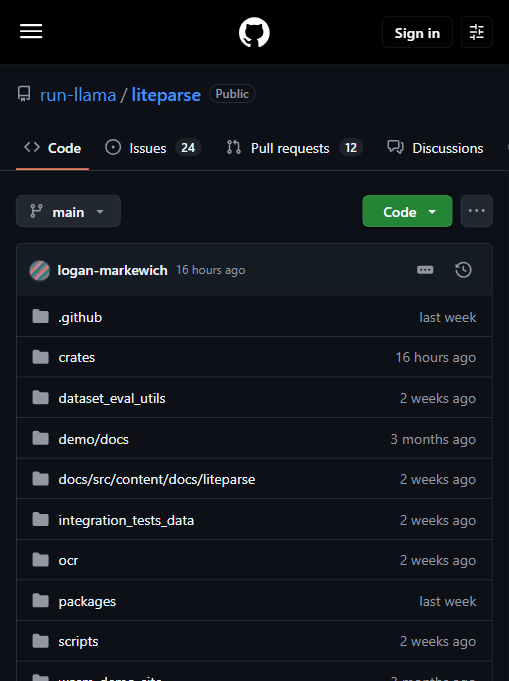
RAG 流水线最脏的活不是调 LLM,而是把 PDF 变成干净 Markdown:密集表格、多栏排版、扫描件、手写体。市面上 LlamaParse、MinerU、Marker 要么收费、要么要 GPU。LlamaIndex 团队开源的 LiteParse(run-llama/liteparse,Apache-2.0)走另一条路:纯本地、不用任何 ML 模型、PDFium 抽文本、按需才上 OCR,每页约 2-5ms。本文基于官方 README 实读,重点看它自己公布的基准成绩——这份表里藏着官方没明说的口径。
一、技术思路:先抽文本,OCR 按需触发
README 对定位讲得很克制:“standalone OSS PDF parsing tool, fast and light… without proprietary LLM features or cloud dependencies. Everything runs locally.”
管线设计有几个巧思:
- PDFium 抽空间文本:基于 Chrome 的 PDFium,输出带 bounding box 的文本位置——不是纯文本流,是结构化的版面元素;
- 复杂度检测:先便宜地判断一份文档”要不要 OCR”,扫描件才触发,正常文本 PDF 不浪费 OCR 算力;
- OCR 可插拔:内置 Tesseract(零配置打包),也能接 HTTP OCR 服务(EasyOCR、PaddleOCR、自研);
- 截图生成:给每页生成高质量截图,供视觉 LLM 直接看;
- 多语言绑定:Rust / Node.js / Python / 浏览器 WASM 四套;
- Worker Pool 模式:Python/Node 下用常驻 worker 进程真并行(PDFium otherwise 会串行化),单文档超时强杀, rogue 文件不卡死流水线。
二、官方基准:成绩单里的胜负
最难得的是 README 直接把自己和其他免费工具放到三份公开 benchmark 上比(官方声明:2026-09-09 各工具最新版、同机一条命令跑完、LiteParse 和”无模型”对手都不用 LLM/布局模型/GPU):
| Benchmark | LiteParse | +Tesseract | +PaddleOCR | 最佳其他无模型工具 |
|---|---|---|---|---|
| ParseBench(2049 文档,5 类平均) | 0.364 | 0.380 | 0.389 | pdf-inspector 0.283 |
| opendataloader-bench(200 文档) | 0.886 | 0.896 | 0.901 | opendataloader 0.842 |
| olmOCR-bench(1403 页,% 通过) | 39.6% | 41.1% | 42.2% | pdf-inspector 33.7% |
仔细看这张表,官方宣传里不会强调的事实:
- ParseBench 综合分其实输给 pdf-inspector:LiteParse 0.364 vs 对手 0.283 是更高分更好的话 LiteParse 赢,但分数体系要看指标定义——README 没写每个 benchmark 的分数方向,需要去看各自 metric 定义。
- opendataloader 与 olmOCR 上 LiteParse 领先:加 PaddleOCR 后 0.901 vs 0.842、42.2% vs 33.7%,这两项是真赢。
- 加 OCR 确实涨分但涨幅小:从 0.886 → 0.901,说明对”文字版 PDF”,纯 PDFium 文本提取已经足够好,OCR 只在扫描件上才显著——印证了”按需 OCR”的设计判断。
三、口径与局限
- “fast and light”的代价是不处理复杂版面。 README 自己写得很诚实:遇到密集表格、多栏、图表、手写、扫描件,“你会在 LlamaParse(云服务)上得到显著更好的结果”——LiteParse 是故意做”简单文档快而准”,复杂文档官方直接引导你去付费云服务。这是开源核心 + 商业云的经典打法。
- 2-5ms/页是文本版 PDF。 扫描件走 OCR 后这个数字不成立,Tesseract/PaddleOCR 每页要几百毫秒到秒级。
- 基准对比限定在”无 ML 模型”类。 它不和 MinerU/GOT-OCR 这种带视觉模型的方案比——那些准但要 GPU。LiteParse 的甜区是”不要 GPU、要快、文档大多是文字版”。
- V1 到 V2 是重写。 README 顶部挂着”Looking for LiteParse V1? Follow this link to the old code”——V2 是 Rust 重写(crates/ 目录),V1 旧代码另存,迁移要注意。
- Apache-2.0 友好,但 OCR 后端协议各异。 Tesseract 是 Apache 友好的;接 PaddleOCR 要单独注意其许可。
四、客观评价
优势:
- 纯本地、Apache-2.0、无云依赖,数据合规友好;
- PDFium 快(ms 级),按需 OCR 设计省算力;
- 四语言绑定 + WASM 浏览器端可用;
- 公开 benchmark 透明,甚至自曝弱项。
局限:
- 复杂版面/扫描件能力不如 LlamaParse/MinerU;
- 无 ML 模型 = 不理解图表语义;
- V2 重写早期,生态与文档仍在补;
- 官方最终目的是导流 LlamaParse 云服务。
五、谁该用
数据不出内网、文档以文字版 PDF 为主、要喂 RAG 流水线的企业——LiteParse 是目前合规又便宜的本地方案。文档里大量扫描件/复杂表格/手写体的,直接上 LlamaParse 或 MinerU,别在 LiteParse 上硬撑。追求极致解析质量且能联网,它的官方定位本来就是”轻量快速层”。