KTransformers:把 671B MoE 模型塞进 24GB 显卡的异构推理框架
阅读时间: 大约 12 分钟
KTransformers:把 671B MoE 模型塞进 24GB 显卡的异构推理框架
DeepSeek-V3/R1 这类 671B 参数的 MoE(混合专家)模型,官方推理通常需要多张旗舰显卡组成的集群。而 KTransformers 给出了另一条路:在单张 24GB 显存的消费级显卡 + 一台内存足够大的 x86 工作站上把它跑起来。这个项目由清华大学 MADSys Lab 主导,论文发表于 ACM SOSP 2025,是近年”压榨家用硬件跑大模型”路线里学术成色较高的一个。本文基于其官方文档站、GitHub 仓库与论文引用信息做一手梳理。
一、背景:MoE 模型的显存壁垒
MoE 模型把 FFN(前馈网络)拆成几十上百个”专家”,每次推理只激活其中少数几个。这种设计让总参数量冲到几百 B,但每次实际计算量却小得多。问题在于:尽管每次只激活 8 个专家,所有专家的权重都必须常驻内存,否则切带来回换页的延迟会让推理完全不可用。
DeepSeek-V3 总参数 671B,按 FP16 算权重就要约 1.3TB,靠 GPU 显存装下成本极高。KTransformers 的切入点正是这里:既然 MoE 里绝大部分参数是”每次只碰一点点、算术强度又低”的路由专家,为什么不把它们挪到内存大、显存便宜的 CPU 侧,而把真正吃算力的部分留在 GPU?
二、它是什么:CPU-GPU 异构推理/微调框架
根据官方文档,KTransformers 是一个”专注于通过 CPU-GPU 异构计算实现大语言模型高效推理与微调的研究项目”,目前对外提供两大能力:推理(kt-kernel)与基于 LLaMA-Factory 的 SFT 微调。仓库 kvcache-ai/ktransformers 创建于 2024 年 7 月,Python 编写,Apache-2.0 协议。它不是一个开箱即用的生产服务,更接近一套经过研究验证、并已被 SGLang 集成的优化内核。
三、技术机制:按”算术强度”切分模型
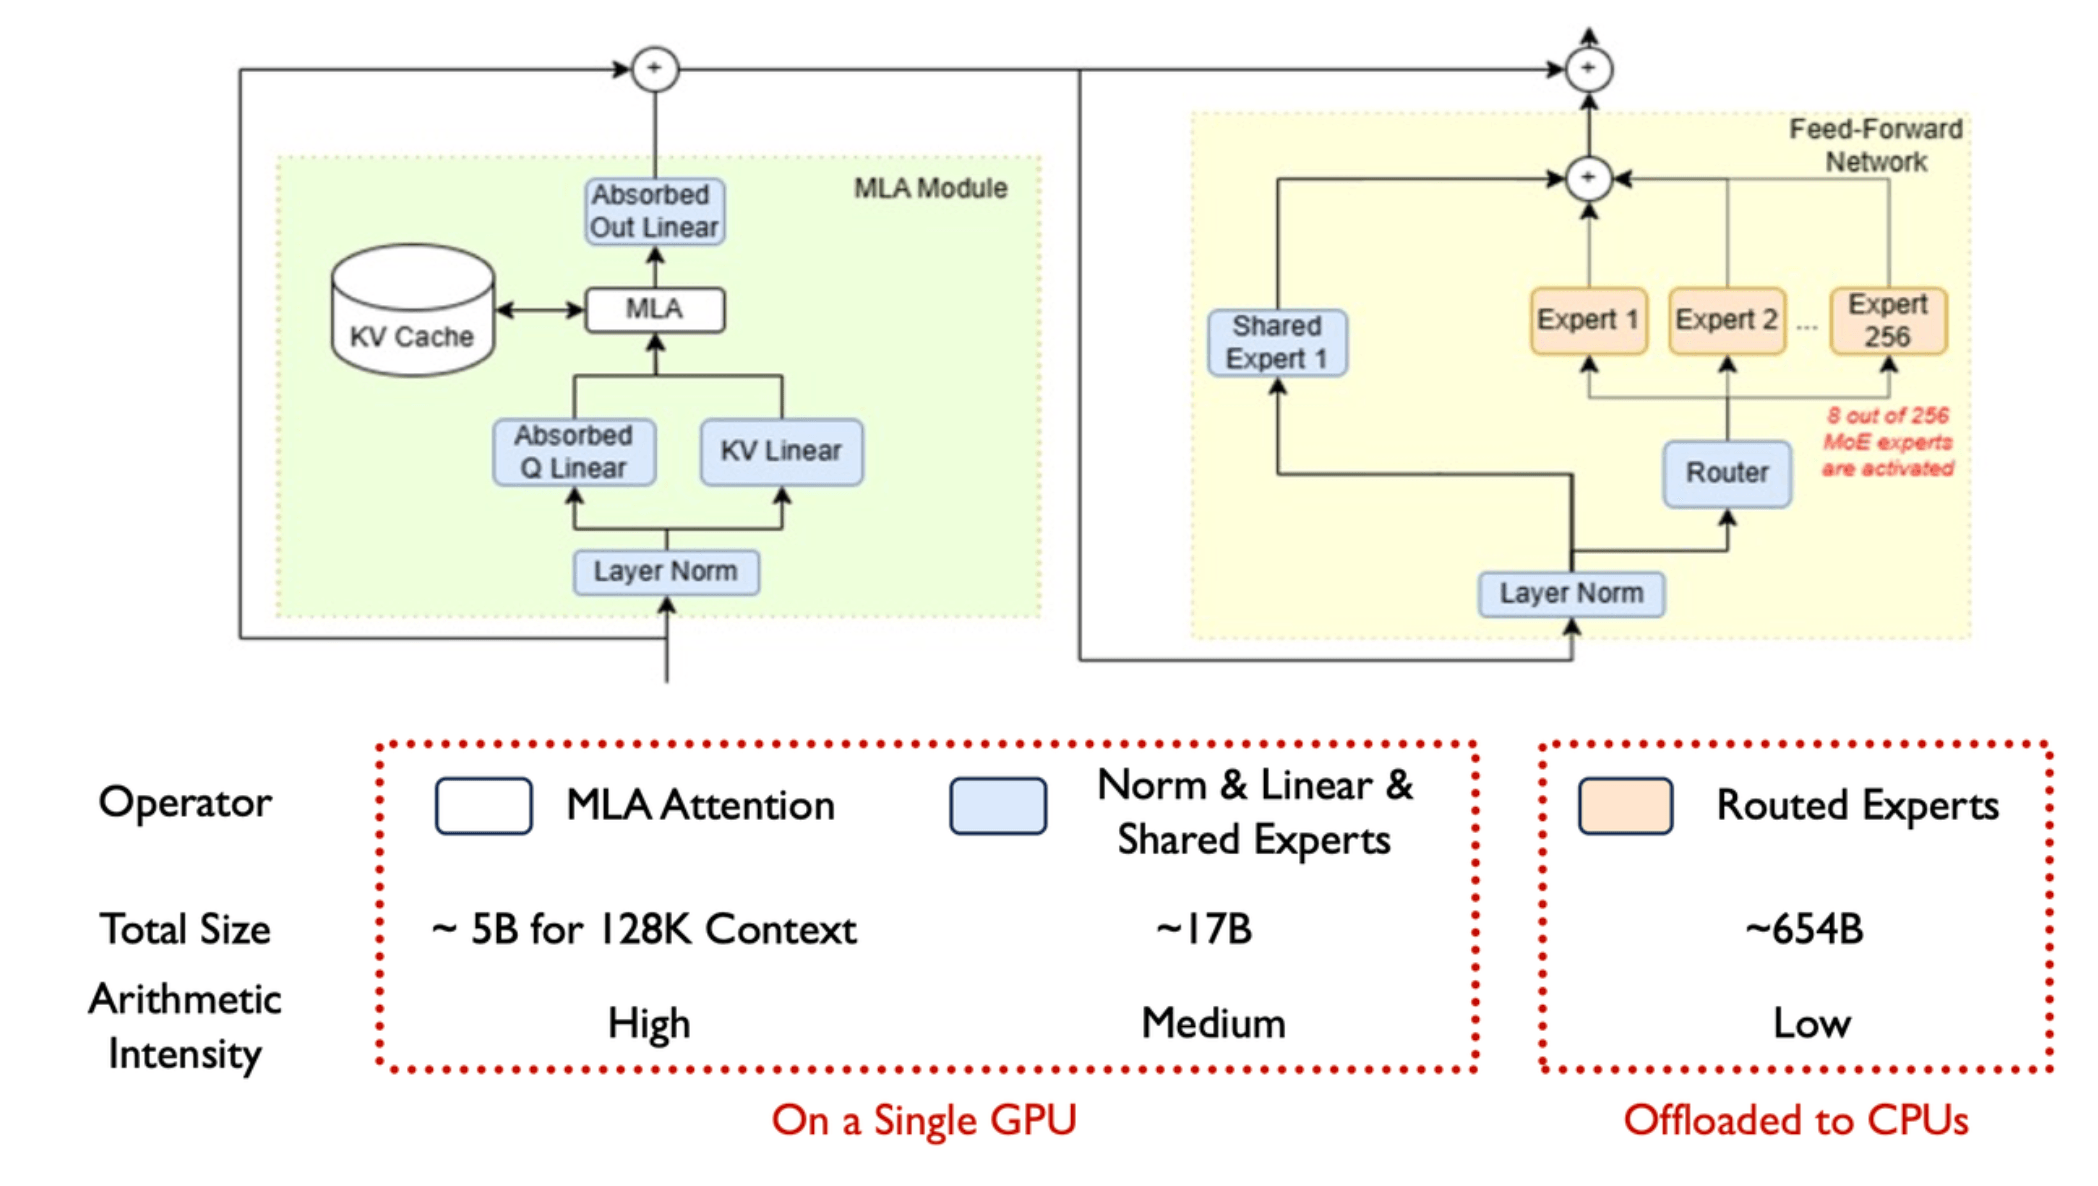
上面这张官方图讲清了它的核心思想。它把一个 Transformer 层按算子特性分成三类:
- MLA 注意力模块(左侧):包含 KV Cache、MLA、以及被融合的 Q/KV/输出线性层。这部分算术强度高、计算密集,而且 KV Cache 对带宽敏感,放在 GPU 上。图中标注约 5B(对 128K 上下文而言)。
- Norm + Linear + 共享专家(中间):约 17B,算术强度中等,同样留在 GPU。
- Routed Experts(右侧):约 654B,算术强度低——这正是 MoE 的特点,每次 256 个专家里只激活 8 个。这部分被卸载到 CPU,由 CPU 侧的量化内核负责计算。
配合的工程手段包括:CPU 侧 INT4/INT8 量化权重、GPU 侧 GPTQ、NUMA 感知的内存管理、以及”热专家放 GPU、冷专家放 CPU”的专家调度。CPU 内核针对 Intel AMX、AVX512/AVX2 做了优化,后续还支持了 AMD ROCm、Intel Arc GPU 与华为昇腾 NPU。
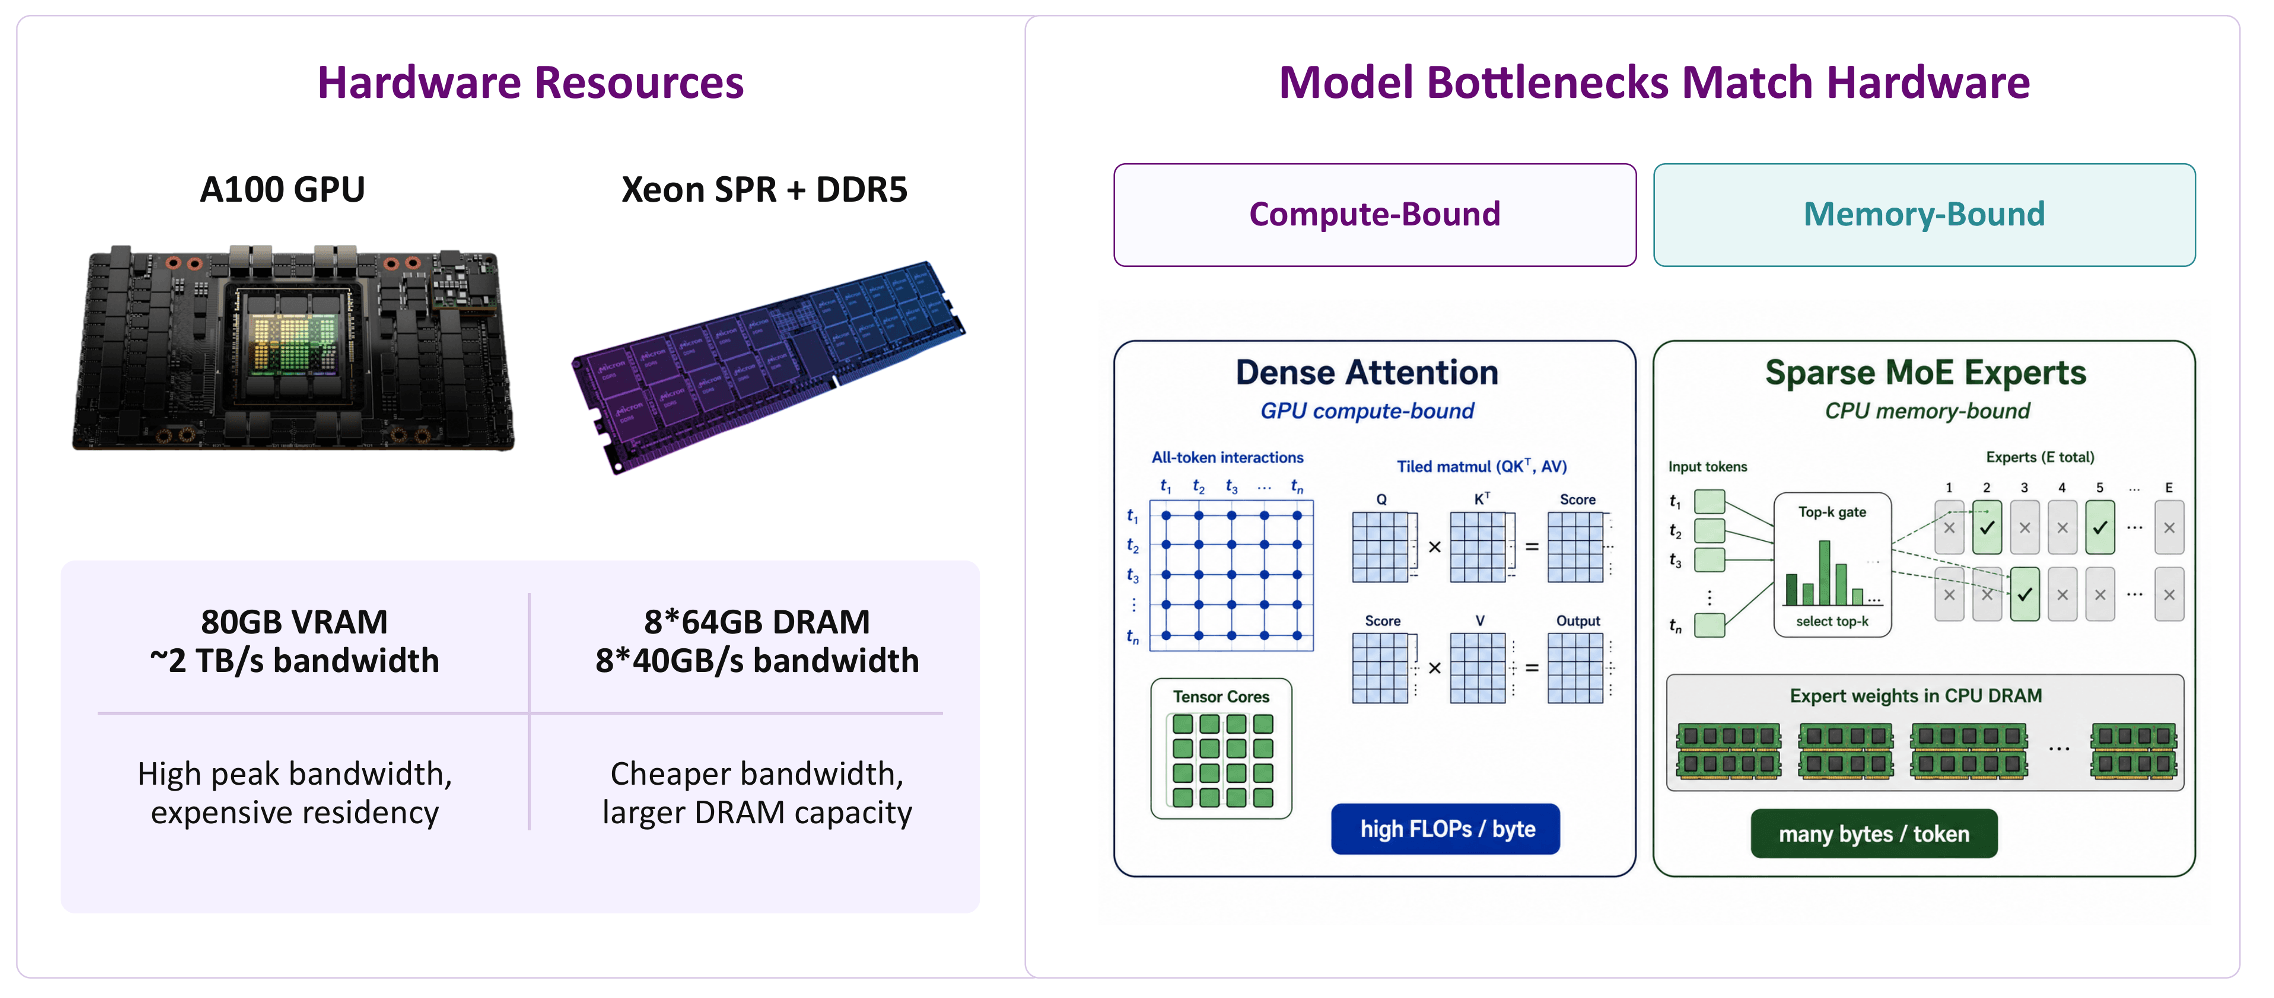
这张官方图把”为什么这么切”讲得最透:GPU(以 A100 为例)胜在算力与显存带宽,但显存昂贵;CPU 的 DDR5 胜在容量与单价,单通道带宽低但总容量大。于是”计算密集、高 FLOPs/byte”的 Dense Attention 交给 GPU 的 Tensor Core,而”访存密集、many bytes/token、每次只读少数专家权重”的 Sparse MoE 交给 CPU 内存。本质上是让每种算子待在最匹配它硬件特性的那一侧,而不是让 CPU 硬扛全部计算。
四、关键数据:能跑多快
下列数字均来自官方文档与 GitHub(统计时点 2026-09-30):
| 指标 | 数值 | 来源/口径 |
|---|---|---|
| 仓库 Star | 约 19,547 | GitHub API |
| Fork | 约 1,582 | GitHub API |
| 单卡门槛 | DeepSeek-V3/R1 在单张 24GB 显存 + 约 382GB 内存运行 | 官方 2025-02-10 更新 |
| 提速 | 相对朴素 CPU 推理最高约 3~28 倍 | 官方更新日志原文 |
| 长上下文 | 24GB 显存下 DeepSeek-V3/R1 支持到约 139K | 官方 2025-03-05 更新 |
| 推理吞吐 | DeepSeek-R1-0528 (FP8):8×L20 + Xeon Gold 6454S,总吞吐 227.85 tok/s,输出 87.58 tok/s(8 路并发) | 官方性能示例 |
| 微调速度 | DeepSeek-V3/R1:约 80GB 总占用、3.7 it/s(4×RTX 4090);Qwen3-30B-A3B:约 24GB、8+ it/s(单张 RTX 4090) | 官方 SFT 文档 |
| 微调对比 | 官方称比 ZeRO-Offload 在其基准 MoE SFT 负载上快约 6~12 倍 | 官方文档 |
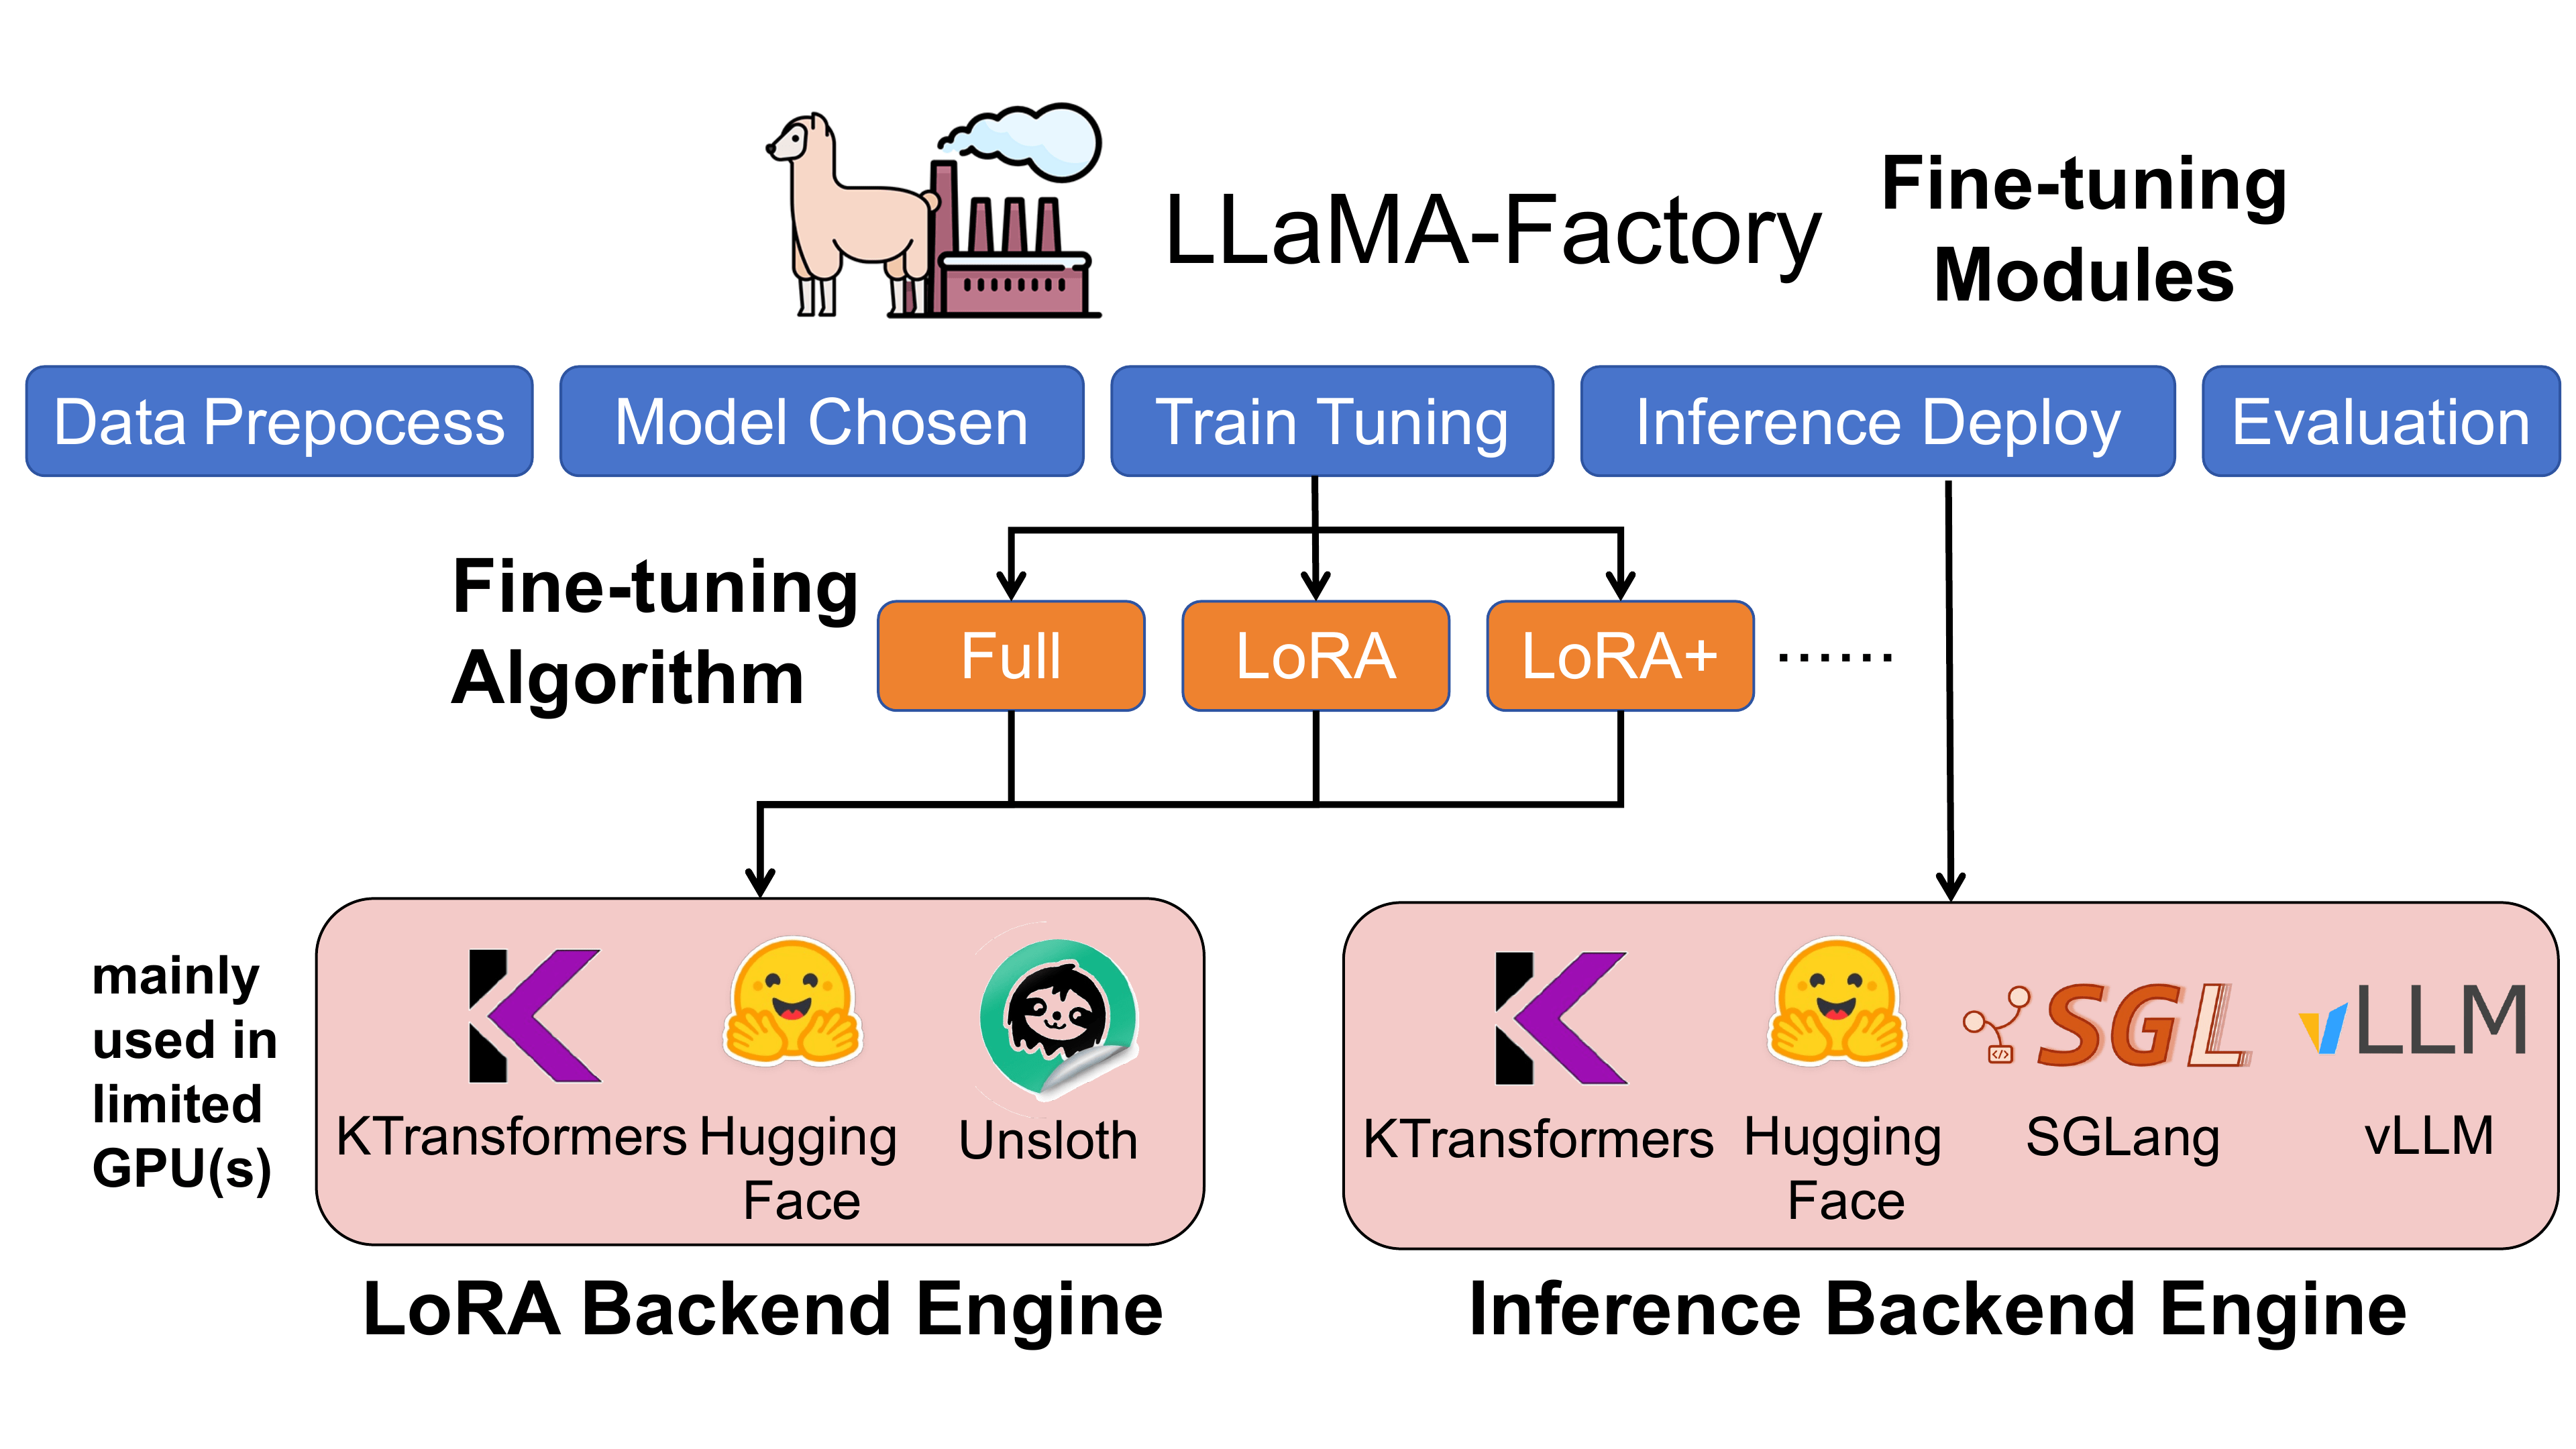
官方把微调能力做成了与 LLaMA-Factory 的集成:在有限 GPU 下,KTransformers 充当 LoRA/全参微调的后端引擎,推理部署侧再对接 SGLang、vLLM。这也解释了上表中”DeepSeek-V3/R1 约 80GB 总占用就能微调”的来源——专家权重下沉到 CPU/GPU 混合后端,而不是全部塞进 GPU。
需要特别说明:3~28 倍这个数字是”相对 baseline”的倍数,官方并未在首页给出 baseline 的具体配置;87.58 tok/s 是 8 路并发下的输出吞吐,不等于单请求的交互速度——单条请求在消费级硬件上往往只能达到每秒数个到十几个 token。读这些数字时必须看清楚是”总吞吐”还是”输出吞吐”、是”单路”还是”并发”。
五、评测方法与口径的坑
- “单卡 24GB 能跑”不等于”单卡够用”。它同时要求约 382GB 系统内存(CPU 侧装专家权重)和支持 AMX/AVX512 的服务器级 CPU。把它理解成”一张游戏显卡 + 一台大内存工作站”的组合,而不是普通台式机。
- 速度高度依赖 CPU 指令集。在没有 AMX、只有 AVX2 的消费级 CPU 上,官方明确标注是”support”而非高性能档;消费级 CPU 跑 671B 模型的单路速度对交互式体验仍然偏慢。
- 6~12 倍微调提速是”benchmarked MoE SFT workloads”口径,官方称只在其测试配置下成立,跨模型、跨硬件不可直接外推。
- 项目定位是研究/实验。官方在更新里大量出现”Day0 支持""实验性支持”字样,且已集成进 SGLang 用于 serving,但异构栈的调试复杂度远高于纯 GPU 推理。
六、适用与不适用场景
- 适合:有大内存 x86 服务器(或带 AMX/昇腾 NPU 的机器)、想用远少于多卡集群的预算体验/微调超大 MoE 模型、做学术复现或边缘/私有化部署验证的团队。它对”显存不够但内存和 CPU 核很多”的硬件配比尤其友好。
- 不适合:追求稳定生产 SLA、低延迟在线服务、或手头只有普通消费级 CPU 的用户。这种场景直接上多卡 GPU 或商用推理服务更省心。
七、它意味着什么
KTransformers 的价值不在于发明了新模型,而在于把”MoE 模型参数巨大但实际激活稀疏”这一结构性特点,翻译成了一套可落地的 CPU-GPU 切分工程。它和此前写过的 Mooncake(面向云端 KVCache 池化的分布式推理)是两条不同路线:Mooncake 解决的是数据中心内多机多卡的资源池化,KTransformers 解决的是单机内”用内存和 CPU 算力换 GPU 显存”。前者服务规模化集群,后者服务被显存门槛挡住的个人与小团队。对后者而言,KTransformers 证明了在消费级显卡上触碰数百 B 模型不再是幻想——但这份”能跑起来”离”跑得舒服、跑得稳”,中间还隔着 CPU 指令集、内存带宽和工程稳定性好几道坎。