Kokoro-82M:8200 万参数、约 1000 美元训练成本的开源 TTS
阅读时间: 大约 10 分钟
Kokoro-82M:8200 万参数、约 1000 美元训练成本的开源 TTS
Kokoro 是作者 @rzvzn 发布在 Hugging Face 上的开放权重文本转语音(TTS)模型,参数规模只有 8200 万(82M),权重采用 Apache-2.0 许可。它最常被引用的两个数字是:全部训练成本约 1000 美元(1000 小时 A100 80GB GPU 时),以及 API 市场价格不到 1 美元 / 百万字符输入。本文基于官方模型卡、官方 GitHub 仓库与 Artificial Analysis 的第三方对比数据,对它做一次不带滤镜的分析。
一、背景:TTS 领域的”小模型路线”
过去两年,TTS 赛道的主流叙事是大模型化: ElevenLabs、OpenAI gpt-tts、Google Sonic 等闭源模型动辄数十亿参数、以情感表现力和声音克隆能力竞争。但工程侧的真实需求是相反的——批量有声书、客服播报、产品内朗读,需要的是稳定、便宜、可自部署,而不是每句话都模仿名人语气。
Kokoro 走的就是这条路线:它不是为”声音克隆”设计的,而是用一个小而精的解码器,把 TTS 的单位生产成本压到接近音频存储的成本线。
二、它是什么:一个”解码器only”的 TTS 模型
按官方模型卡的 Model Facts:
- 架构基础:StyleTTS 2(arXiv:2306.07691,由 Li et al 提出)+ ISTFTNet 声码器(arXiv:2203.02395);
- 形态:Decoder-only,不附带扩散模型、不发布语音编码器;
- 采样率:24 kHz;
- G2P 前端:官方配套的
misaki库完成字形到音素(IPA)的转换; - 权重许可:Apache-2.0,可商用。
版本演进上,v0.19(2024-12-25)只用不到 100 小时音频、支持 1 个语言 10 个声音;正式版 v1.0(2025-01-27)扩展到”几百小时”数据、8 个语言、54 个声音。通过 lang_code 切换语言:a 美式英语、b 英式英语、e 西班牙语、f 法语、h 印地语、i 意大利语、j 日语、p 巴西葡语、z 普通话。
三、训练成本与数据:约 1000 美元的账
官方模型卡公开了完整的训练成本表,这在 TTS 模型里相当罕见:
| 训练项 | v0.19 | v1.0 | 合计 |
|---|---|---|---|
| A100 80GB GPU 小时 | 500 | 500 | 1000 |
| 平均时租 | $0.80/h | $1.20/h | $1.00/h |
| 成本(美元) | $400 | $600 | 约 $1000 |
数据侧,官方明确声明训练只使用宽松许可/无版权音频:公有领域音频、Apache/MIT 许可音频,以及由闭源商用 TTS 大模型合成的音频;并且特别注明”不使用开放 TTS 模型合成的数据、不使用自定义声音克隆数据”。其中 CC BY 授权的部分有明确披露:Koniwa tnc 数据集 <1 小时、SIWIS 数据集 <11 小时,均在 v0.19 阶段(2024-11-22 之后)加入。
四、市场价格:第三方交叉验证
官方称”截至 2025 年 4 月,Kokoro 的 API 市价低于 1 美元/百万字符输入,或低于 0.06 美元/小时音频输出”,并给出两个供应商报价:ArtificialAnalysis 经 Replicate 为 0.65 美元/百万字符,DeepInfra 为 0.80 美元/百万字符。官方同时给出换算口径:1000 字符输入 ≈ 1 分钟音频输出。
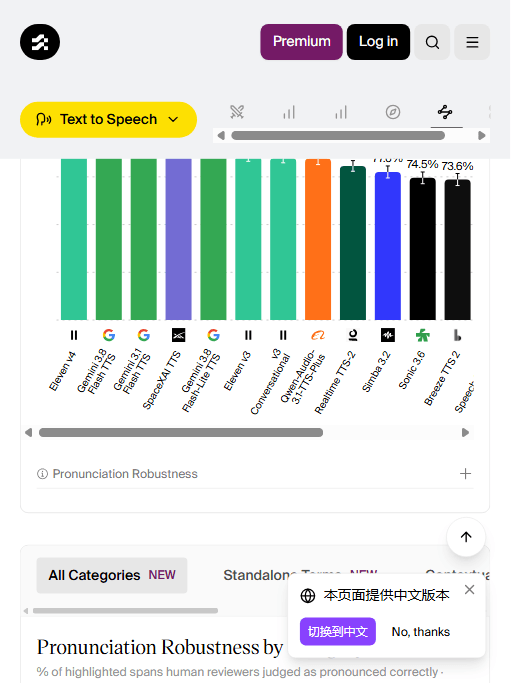
第三方对比平台 Artificial Analysis 2026 年更新的 TTS 榜(76 个模型)交叉验证了这一点:
| 指标(第三方 Artificial Analysis) | Kokoro 82M v1.0 @ Replicate | 榜单位置 |
|---|---|---|
| 价格(美元/百万字符) | 0.65 | 76 个模型中最低 |
| 生成速度(字符/秒) | 245.2 | 约第 2(仅次于 Flash v2.5 的 479.8) |
| 质量 Elo(人工偏好投票) | 1056 | 中游(榜首 Realtime TTS 1.5 Max 为 1208) |
五、评测方法与口径偏差(重点)
这一节是本文的核心,Kokoro 的宣传口径里有几处必须拆开看:
- “质量媲美更大模型”是宣传语,不是评测结论。 官方原文是 “delivers comparable quality to larger models”。但第三方 Artificial Analysis 的人工偏好 Elo 中,Kokoro 为 1056,明显低于 Eleven v3(1178)、Gemini 3.1 Flash TTS(1206)、Realtime TTS 1.5 Max(1208)等头部闭源模型,大约排在第 19/25 位。它的真实定位是”同价位里质量最好”,而不是”同质量里最便宜”——便宜是实打实的,“媲美大模型”要打折扣。
- Koala 项目库条目里”<100 小时训练、TTS Spaces Arena 排名第一”是 v0.19 时代的快照。 v1.0 实际使用”几百小时”数据;而 TTS Spaces Arena 是社区滚动投票榜,排名随时间和参赛模型流动,不存在固定的”第一”。
- 训练数据里有”闭源 TTS 合成音频”。 官方声明训练数据包含由闭源商用 TTS 模型合成的语音。这意味着 Kokoro 的音色表现间接继承了被蒸馏的商业模型输出——版权上官方选择只使用”宽松许可”数据来回避直接侵权,但这条合成数据管线的最终授权边界,官方并未给出法律意见。
- Decoder-only = 不支持开箱即用的声音克隆。 官方未发布语音编码器,只能在预置的 54 个声音里选择,不能像 ElevenLabs 那样上传一段录音就克隆任意人声。
- 24 kHz 采样率。 相比新一批 44.1 kHz/48 kHz 高保真 TTS,Kokoro 在高频细节上先天受限,不适合对音频质感要求极高的影视/音乐场景。
- 官方点名了一批”李鬼”网站。 模型卡明确警告:任何根域名含 “kokoro” 的站点(如 kokorottsai.com、kokorotts.net)都与作者无关,疑似诈骗。
六、优势与局限
优势:
- 成本极致:不到 1 美元/百万字符、245 字符/秒的生成速度,批量播客/有声书/通知类场景的单位成本接近地板;
- 完全开源可自部署:Apache-2.0 权重,82M 参数在消费级 GPU 甚至 CPU 上都能跑;
- 训练可复现:公开 GPU 小时数与总成本,透明程度在生成式模型里罕见;
- 生态完善快:发布后数月内 Hugging Face 月下载量即超过 1150 万次,社区已出现 60+ 微调、70+ 量化版本。
局限:
- 自然度处于中游,头部闭源模型在情感、韵律上仍有明显优势;
- 无声音克隆能力,只支持预置声音;
- 24 kHz 输出,高保真场景不够用;
- 多语言为工程拼装:日语、中文需要额外安装
misaki[ja]/misaki[zh],非英语音色自然度普遍弱于英语。
七、谁该用它
- 批量内容生产线:有声书、新闻播报、课程朗读——成本敏感、音色要求”清晰标准”即可;
- 需要本地化部署的团队:数据不能出内网,但又要 TTS 能力;
- 嵌入式/端侧场景:82M 参数可以跑在边缘设备上做离线朗读。
不建议追求”顶级配音质感”或需要任意声音克隆的场景——那是 ElevenLabs、gpt-tts 等闭源模型的地盘。