Jevgrep:给编程 Agent 的语义代码检索 CLI,用便宜模型先找代码
阅读时间: 大约 13 分钟
Jevgrep:给编程 Agent 的语义代码检索 CLI,用便宜模型先找代码
编程 Agent 在陌生仓库里摸索”某个功能在哪实现”时,会消耗大量主模型 token 反复读文件、试 grep。Jevgrep(命令名 jg)把这一步拆出来:用更便宜的 TypeSafe Jev 模型在目录、文件、声明三层判断相关性,自然语言提问后直接返回相关文件、阅读线索与原文片段,主模型只负责实现和测试。官方口号 “Same intelligence. ~30% lower cost”。本文基于 GitHub 仓库 README 与官方评测记录一手核对。
一、背景动机:找代码是被忽视的 token 开销
主模型(如 GPT-5.6-Sol)按 token 计费,让它在陌生仓库里逐个翻文件定位功能,是一笔纯检索成本。合理分工是:检索判断交给小而便宜的专用模型,昂贵的主模型只拿到”起点线索”直接动手。Jevgrep 就是这个前置检索层,定位为 Agent 调用的 CLI,而不是给人用的 IDE 搜索。
仓库 dzhng/jevgrep,MIT 协议,TypeScript + Bun workspaces + Turborepo;抓取时约 2.8k stars、214 forks、5 个开放 issue、273 次提交。安装 npm install -g @dzhng/jevgrep,要求 Node.js 22+,支持 macOS/Linux/Windows,使用时无需另装 Python、Bun 或 ripgrep。
二、工作机制:分层发现 + 源码优先输出
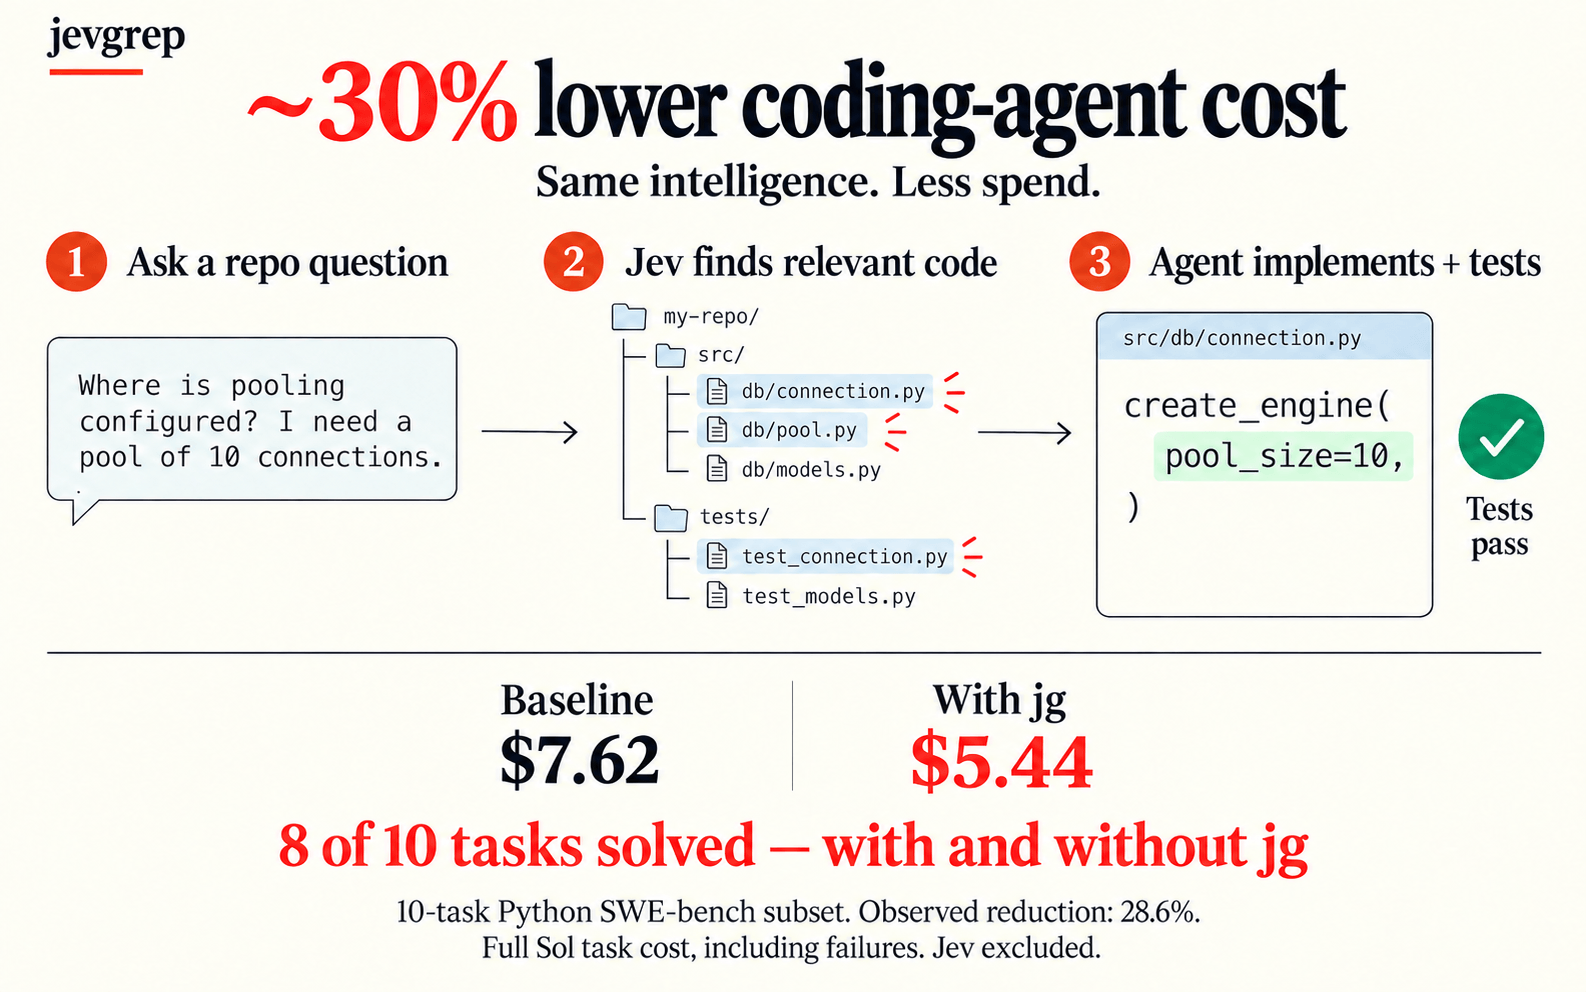
官方描述的流程(配合下图):
- Ask a repo question:Agent 用自然语言提问,如 “Where is pooling configured? I need a pool of 10 connections.”;
- Jev finds relevant code:Jevgrep 遍历仓库层级、沿合格分支深入,先用内容预览选文件,再识别有用的源码单元与周边上下文,在目录/文件/声明三层打分;
- Agent implements + tests:返回摘要、紧凑文件清单、带行号的原文片段、声明与调用位置,主模型据此实现并跑测试。
输出顺序为:摘要与文件清单在前,随后是带行引用的选中源码,最后是详细声明与调用位置。声明解析支持 Python、TypeScript/JavaScript、Go、Rust(无扩展名的 Python/Node 脚本按 shebang 识别),其他文本走兜底。官方强调”不强制固定 top-N 列表”:即使拿不准能否给出片段,也会保留合格文件位置。
关键前提:只装 CLI 不会教会 Agent 使用,必须在项目里跑 jg skill,安装器检测 Claude Code、Codex、OpenCode 等 Agent 并写入 skill;skill 只讲调用方式与返回上下文含义,不夹带调试或实现建议。认证走 jg auth,支持 Vercel AI Gateway、TypeSafe、OpenRouter、OpenCode Zen 或自定义 TypeSafe 兼容端点。
三、官方评测:8/10 持平,Sol 成本 28.6% 降幅
官方评测记录(evals/results/relevance-threshold-2026-09-27.md)给出完整 10 任务明细:主模型为 openai/gpt-5.6-sol(medium),要求其先调用 Jevgrep,再可用普通研究工具;基线为保存好的无 Jev 结果,不重跑。官方 SWE-bench grader 判定解出与否。
| 口径 | 无 Jev 基线 | 使用 jg |
|---|---|---|
| 解出任务 | 8/10 | 8/10(保留全部 8 个基线解) |
| Sol 总成本(含失败尝试) | $7.6221 | $5.4397 |
| 单任务平均 Sol 成本 | $0.7622 | $0.5440 |
| 观测降幅 | — | 28.63%(宣传约 30%) |
逐任务看,并非每个任务都更省:Requests($0.2915 vs $0.2685)、Astropy($0.4586 vs $0.4286)、SymPy($0.5613 vs $0.5480)单独成本反而略高;Django($1.2286 vs $1.5055)、pytest($0.8281 vs $2.3445)、Sphinx($0.7049 vs $1.0595)等节省明显。官方明确写”aggregate saving is not a per-task guarantee”。
后续两轮口径(README 自述):
- 0.4.3 总成本重跑(含 Jev 费用):总成本低 25.8%,仍是 8/10;
- 0.5.0 评测:原生 Jev 成本较 0.4.3 降约 59%,但 Sol+Jev 合计成本反而高 2–3%,官方接受为该版本的小权衡。
四、评测方法批判:官方自己声明的局限
这一节最重要,因为官方记录里主动写了多条不能外推的边界:
- 10 个调优过的 Python 任务,不是留出集(holdout):官方写明”These are tuned development tasks, not a holdout”,是为调参选的任务子集。
- 每任务单次样本,无统计等价性:“One sample per task does not establish a causal effect, eliminate sampling variance, or demonstrate savings across arbitrary languages, repositories or agents.” 单跑一次不能排除抽样波动。
- 基线未重跑、非配对:无 Jev 结果是历史保存值直接复用,未在同条件下重跑,也没有配对随机化。
- ~30% 是 Sol 单方成本、不含 Jev:宣传图的 $7.62→$5.44 排除 Jev 费用;该 cohort 观测到的 Jev API 元数据至少 $1.5707,完整 Jev 计费未知。含 Jev 的口径降到 25.8%。
- 两个失败任务与基线相同且非检索问题:matplotlib 失败于官方测试补丁本身,pylint 失败于 fixture 缺
IS_PYPY,两者在分母中保留,不能算作 jevgrep 的检索退步。 - 主模型可用普通工具补位:Sol 能自行填补检索遗漏(如 Django 任务中 SQLite 被漏掉但 Sol 自己找到并修复),因此无法证明解出完全归功于检索。
- 历史 7/10 结果来自旧运行时,与发布的 npm 0.3.2 包不可直接比较;最终 cohort 比更早研究 cohort 贵约 7.4%,不是观测到的最便宜 8/10。
- 官方结论措辞克制:“evidence supports adopting this artifact, not claiming it is optimal”(证据支持采用,不证明最优)。
五、安全与本地行为(官方口径)
- 搜索会把合格源码经选定提供方发给 Jev;默认过滤尊重 ignore 文件,排除隐藏、依赖/构建、二进制与明显凭证文件(
.env变体、以.env结尾的路径段); - 凭证启发式(已知 token 前缀如
npm_/glpat-、Slack webhook、高熵赋值)命中则整文件标sensitive_content排除,但官方明确这是 best-effort,不是脱敏,也不保证移除全部敏感信息,需自行选择可发送的搜索根;--include-sensitive可强制纳入; jg files [root]可在无密钥、无网络下统计可读文件数;评测答案默认本地缓存;CLI 只写 stdout,不生成报告文件;- 没有
jg upgrade命令,升级靠 npm 重装后重跑jg skill刷新。
六、适用与不适用场景
适合:
- 在陌生大型仓库里做”按行为找实现”的任务,主模型 token 成本敏感;
- 已使用 Vercel AI Gateway / TypeSafe / OpenRouter 等提供方,愿意接一层便宜检索模型;
- Python/TS/JS/Go/Rust 仓库,且 Agent 能被 skill 正确引导调用。
不适合:
- 已知精确符号或路径的场景——直接读文件或
rg更快更省; - 要求零外联、源码不出本机的隔离环境(检索须把内容发给 Jev 提供方);
- 需要在非 Python 评测集、其他主模型上拿到可保证节省的场景(官方未验证);
- 对凭证外泄零容忍且无法控制搜索根的仓库。
七、客观分析:优势与局限
优势:
- 分工思路正确:把”找代码”从昂贵主模型剥离给小模型,方向符合成本工程;
- 输出是证据而非答案:给文件、行号、声明位置,把判断权留给主模型,不伪造结论;
- 检索诚实:不强行凑 top-N,拿不准也保留文件位置;
- 官方评测记录透明:逐任务成本、失败原因、口径偏差都写进仓库,少见的克制。
局限:
- 证据强度弱:10 个调优 Python 任务、单次、基线不重跑,28.6% 不能当作普遍保证;
- Jev 成本未闭合:宣传降幅排除 Jev,含 Jev 后为 25.8%,且完整 Jev 账单未知;
- 依赖外部模型提供方:不是纯本地工具,增加一处配置与计费;
- 语言覆盖有限:仅四种语言有声明解析,其余走文本兜底;
- 生态早期:2.8k stars、无升级命令、skill 需手动刷新。
八、它意味着什么 / 谁该关注
Jevgrep 代表 Agent 工程里”检索前置、模型分层”的趋势:主模型不必什么都自己翻。它适合成本敏感、仓库较大、能接受外部检索模型的团队先在自己的任务上做小样本 A/B,用真实 token 账单验证节省,而不是直接采信 28.6% 这个单轮数字。关注其后续是否扩大评测语言、任务数并给出含 Jev 的完整成本口径。