Microsoft GraphRAG:用知识图谱让 LLM"看懂整个语料库"
阅读时间: 大约 9 分钟
Microsoft GraphRAG:用知识图谱让 LLM”看懂整个语料库”
检索增强生成(RAG)如今几乎是所有企业问答系统的标配:把文档切块、向量化,提问时按语义相似度捞几段塞进上下文。但微软研究院发现,这套”基线 RAG”在一类问题上特别笨拙——比如”这批文档里最重要的主题是什么""这家公司最近的战略方向有哪些”。这类问题不是”检索某句话”,而是要对整个语料库做综合归纳。2024 年 4 月,微软研究院开源了 GraphRAG,并用一篇论文(arXiv:2404.16130)系统回答了这个问题。本文基于其官方文档、论文摘要与 README,拆解它的机制、收益与代价。
一、问题:基线 RAG 为什么答不好”全局问题”
官方文档把基线 RAG 的失败模式讲得很清楚:
- 接不上点(can’t connect the dots):答案需要把分散在不同文档里、靠共同属性关联起来的信息串联成新洞察时,逐条向量检索无能为力;
- 缺乏全局理解:面对大规模语料库甚至单个大文档,要求”整体总结出有哪些语义概念”时表现很差。
论文摘要更直白:RAG 擅长”找相关信息”,但”这个数据集的主要主题是什么”本质上是**查询聚焦摘要(Query-Focused Summarization, QFS)**任务,不是检索任务;而传统 QFS 方法又无法扩展到 RAG 那种量级的文本。GraphRAG 就是要把两者的长处拼起来。
二、它是什么:两阶段构建的图索引
官方文档把 GraphRAG 定义为”一个结构化、分层的 RAG 方法”,区别于”用纯文本片段做语义检索”的朴素做法。整个过程分**建索引(Index)和查询(Query)**两段。
建索引阶段(一次性、离线):
- 把语料切成一系列 TextUnits(可分析的文本单元,也是输出时的细粒度引用来源);
- 从 TextUnits 里抽取所有实体、关系和关键主张;
- 用 Leiden 算法对实体图做层次化聚类,把紧密相关的实体聚成”社区”;
- 自底向上为每个社区生成摘要,形成对数据集的整体理解。
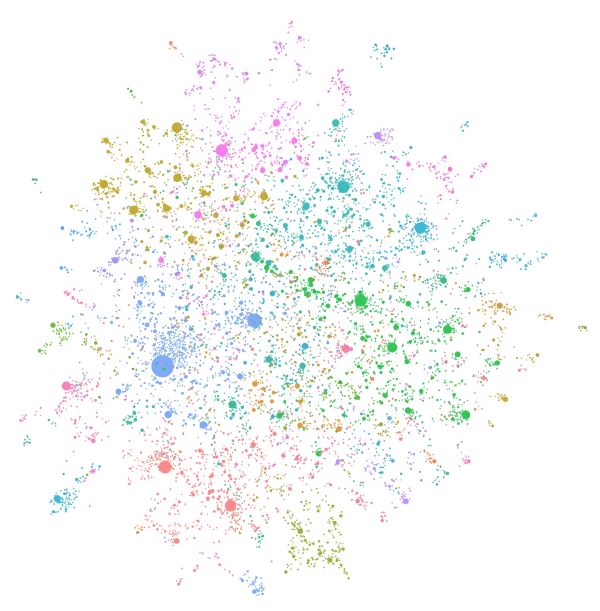
这张官方 Figure 1 就是建索引阶段跑出来的产物——一张由 LLM 从无结构文本里抽出来的实体网络图,圆点大小是实体的连接度,颜色是它被 Leiden 算法分到的社区。
查询阶段,这些预建结构被拿来喂给 LLM 的上下文窗口。官方提供四种查询模式:
| 查询模式 | 用途 | 检索方式 |
|---|---|---|
| Global Search | 对整个语料库的整体性问题 | 利用各社区摘要,汇总成答案 |
| Local Search | 针对某个具体实体的问题 | 从该实体向邻居/关联概念发散 |
| DRIFT Search | 针对具体实体,但要兼顾全局 | Local 发散 + 补充社区上下文 |
| Basic Search | 标准事实检索 | 退化为基线 RAG 的 top-k 向量检索 |
论文摘要里描述的 Global 模式很有意思:提问时,每个社区摘要先生成一份局部回答,再把所有局部回答二次汇总成最终答案——这正是它能回答”整个语料库主题”的关键机制。
三、效果与代价:论文怎么说
论文(arXiv:2404.16130,2024 年 4 月提交、2025 年 2 月修订)在摘要里给出的核心结论是:在约 100 万 token 量级私有数据集上的一类”全局意义建构”问题上,相比传统 RAG 基线,GraphRAG 在答案的全面性(comprehensiveness)和多样性(diversity)两个维度都带来了实质性提升。
需要强调:论文比较的维度是”全面性”和”多样性”,而不是传统意义上的事实正确率百分比——它衡量的是”这篇综述有没有覆盖到该覆盖的点、角度够不够丰富”,适用于开放式全局问题。
四、口径偏差:别被”实质性提升”四个字带跑
- 提升主要发生在”全局问题”这一窄场景:论文和文档自己都说,GraphRAG 是为 QFS / 全局意义建构问题设计的。如果你只是问”合同第三条写了什么”这类点对点事实检索,官方照样提供 Basic Search(就是基线 RAG),硬上图索引是杀鸡用牛刀;
- 索引成本是硬约束:两阶段索引意味着要让 LLM 对整个语料库做实体抽取 + 逐社区摘要,这是一次性但相当可观的 token 开销。论文摘要把它表述为”用预生成社区摘要换来可扩展性”,言下之意就是——你先花一大笔索引成本,查询时才便宜。语料库更新后还要部分重算索引;
- “实质性提升”是作者自测口径:全面性/多样性的评判来自论文自己的实验设置(人工/模型评分),数据集、问题集都由作者选定,不是第三方在统一基准上复测的结果;
- 开箱即用不等于开箱即优:官方文档在 Prompt Tuning 一节明确写——“直接拿 GraphRAG 套你的数据,未必能得到最好结果,强烈建议按调优指南微调抽取与摘要的 prompt”。也就是说,README 里的光鲜图背后,真实落地往往还要投入 prompt 工程;
- 依赖 LLM 质量:实体抽取和社区摘要都靠 LLM(图是 GPT-4 Turbo 生成的),底层模型抽错实体、归错社区,后面的答案就会系统性跑偏。
五、优势与局限
优势:
- 直击基线 RAG 的盲区:对”整个语料库讲了什么”这类全局/综合问题,提供了被论文验证过的结构化解法;
- 模块化、开源友好:MIT 协议,索引与查询分离,TextUnit 提供细粒度可追溯引用;
- 查询模式齐全:Global/Local/DRIFT/Basic 四档,从全局综述到单点事实都覆盖,不必一刀切;
- 微软背书 + 持续维护:PyPI 包(截图时 v2.2.1,月下载约 6.2 万),有配套 Azure Accelerator 方案。
局限:
- 索引昂贵、更新成本高:全语料 LLM 抽取 + 社区摘要,对大规模、高频更新的语料是不小负担;
- 收益面窄:只在全局综合类问题上优势明显,普通问答用不上;
- 落地要调优:默认 prompt 不等于最佳,需要按自己的数据做 Prompt Tuning;
- 误差会被图结构放大:实体抽取错误会通过聚类和社区摘要层层传播。
六、谁该关注
- 要对大量内部文档做”全局综述/洞察”的团队:比如企业知识库自动归纳主题、研究文献综述,这是它的主场;
- 已经在用基线 RAG、但答不好”整体类问题”的系统:可以叠加 GraphRAG 的 Global Search,而非推翻重来;
- 点对点事实检索为主的场景:基线 RAG 足够,不必引入图索引的复杂度与成本;
- 数据极敏感、不能把全库喂给 LLM 做抽取的机构:要先评估索引阶段的数据合规问题。