GitHub Stacked PRs:官方堆叠式合并请求
阅读时间: 大约 10 分钟
GitHub Stacked PRs:官方堆叠式合并请求
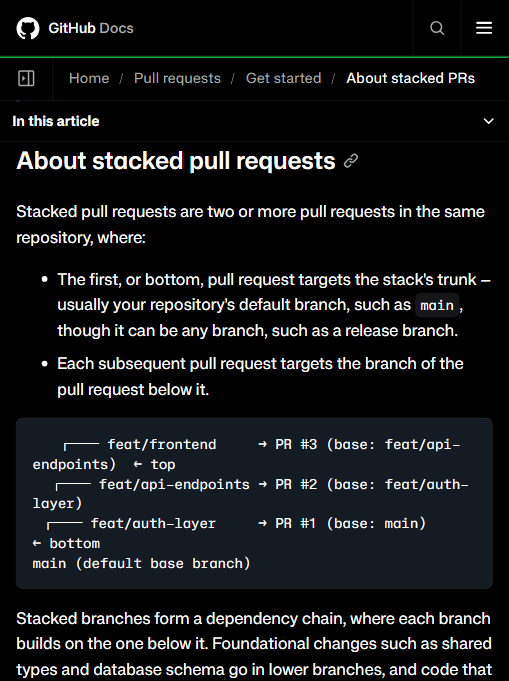
2026 年,GitHub 在 Pull Requests 文档体系中上线了 Stacked pull requests(堆叠式合并请求) 功能,当前处于 public preview(公开预览) 阶段,官方明确标注”subject to change(可能变动)“。它把业界早已存在的”堆叠 PR”实践做成了一等公民:你可以把一个大改动拆成一串互相依赖的小 PR,每个独立评审、独立合并,并由 GitHub 自动处理最棘手的 rebase。本文基于 GitHub 官方文档(docs.github.com)做一手梳理。
一、背景:评审为什么成了瓶颈
堆叠式 PR 并不是新概念。据 Koala 项目库的点评,Meta、Google 这类工程组织内部已经把”把改动切成一串依赖提交、逐段评审”的方式用了很多年;在 GitHub 上,过去只能靠 Graphite、Sprout、Pieces 等第三方工具或手工维持分支栈。
推动 GitHub 此时出手的直接背景是 AI Agent 生成代码的量级。官方文档在”Why use GitHub stacked pull requests”一节中专门写道:当你借助 AI agent 一次性生成大量代码时,“几分钟产出上千行 diff”已经不罕见。一个 agent 完成一个任务后会接着做下一个、并且后者依赖前者——这天然就是一条栈。评审由此取代编码成为新瓶颈:单个巨型 PR 容易被 reviewer 跳过、容易过时、容易堆积合并冲突。把大改动切成”每片都能独立读懂”的小块,正好对症。
二、是什么:一条自底向上的依赖链
官方定义很精确:堆叠 PR 是同一仓库内两个或更多 PR,满足——
- 最底层(bottom)PR 直接指向栈的主干(trunk),通常是
main,也可以是 release 分支; - 其上每一个 PR,都指向下一层 PR 的分支,而不是主干。
文档给出的典型分层是:共享类型、数据库 schema 这类”地基”放在低层分支;依赖它们的 API 路由、UI 组件放在高层分支。核心原则只有一条:如果一层代码依赖另一层,依赖必须落在同一层或更下层。每个 PR 只展示”本层分支相对下一层分支”的 diff,reviewer 看到的是一个聚焦的小变更,而不是一坨巨大 diff。
三、技术机制:谁来维护 rebase
手搓分支栈最痛的不是建分支,而是 rebase。官方把这件事接管了:
- 服务端级联 rebase:可以从 PR 页面直接触发;
- 本地级联 rebase:通过
gh stack扩展在本地执行; - 当你合并栈底 PR 后,剩余分支会自动 rebase,使上一个 PR 自动改指默认主干分支。
在 GitHub 网站端,属于某栈的 PR 顶部会出现一个栈图标(标注当前是第几层),合并框里会出现一张 stack map(栈地图),展示栈内每个 PR 的状态并可一键跳转。程序化层面也开放了:Webhook 的 pull_request 事件载荷里带 stack 对象,REST API 提供列出/创建/扩展/解散栈的端点,GraphQL 暴露只读栈字段;面向 agent 则提供 gh-stack skill。可用渠道覆盖 GitHub CLI、网站、Mobile,以及上述 API/Webhook。
四、合并语义与 CI:关键规则
合并规则是这套机制里最容易踩坑的地方,值得单列:
| 维度 | 官方规则 |
|---|---|
| 合并方向 | 必须自底向上(bottom-up),不能从栈顶跳着合 |
| 整栈合并 | 合并最顶层 PR,其下全部随之合并 |
| 分段合并 | 合并中层 PR,则它及以下一起合;以上保持打开并自动改指主干 |
| 合并方式 | 支持 merge commit / squash / rebase,且 merge-queue aware |
| 分支保护 | CODEOWNER 等保护规则对栈内每个 PR 都生效,包括不直连主干的中层 PR |
| CI 触发 | 面向主干 pull_request 的工作流会对栈内每个 PR 都跑一遍 |
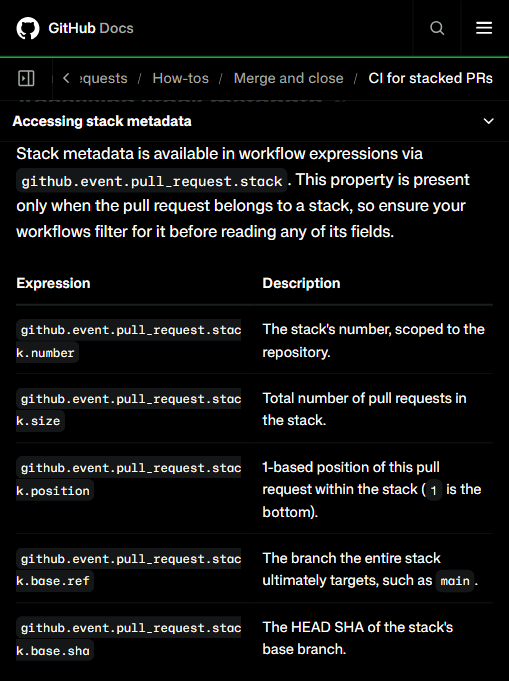
CI 这一条是双刃剑。好处是:每一层都按”好像直接对着 main”来验证,质量门槛一致;坏处是:一个工作流每个 PR 跑一次,栈越大、CI 用量成倍放大。官方因此在 github.event.pull_request.stack 命名空间下暴露了元数据供工作流裁剪:
stack.number:栈在仓库内的编号;stack.size:栈内 PR 总数;stack.position:当前 PR 的 1 基位置(1 为栈底);stack.base.ref/stack.base.sha:整个栈最终指向的主干分支及其 HEAD。
官方推荐两个裁剪条件:一是 lowest unmerged PR(stack.base.ref == pull_request.base.ref,即当前真正贴着主干的那层),二是 top PR(position == size,即包含全部累积改动的那层)。把昂贵的 job 只挂在这两个位置上,就能避免中间层反复跑重复 CI。文档同时提醒:stack 属性只在该 PR 属于某栈时才存在,工作流里必须先判空再读字段。
五、口径与局限:官方自己标注的边界
这一节是评估这类功能时最该看的 nuance,全部来自官方文档原文:
- 仍在 public preview:功能可能随时改动,文档开篇即注明;API 合并若要用栈语义,必须改用异步合并 API,同步接口不适用。
- 不支持跨 fork:栈内所有分支必须位于同一仓库,cross-fork stacks 不被支持。
- GitHub Desktop 不可用:桌面端暂不支持,主要靠 CLI 与网页端。
- CI 放大是默认行为,不是自动优化:官方并没有替你”智能跳过”中间层 CI,而是把
stack元数据交给你,由你自己写if条件去裁剪——不主动优化的团队,账单会先涨起来。 - 质量门槛统一的代价:文档坦承”每层都像对着 main 一样验证,保持了一致性,但意味着一个工作流可能为单个栈跑很多次”——这是有意设计取舍,不是 bug。
六、适用 / 不适用场景
适合: AI agent 高频产出代码、需要把一串有依赖关系的任务拆成可评审单元;大型重构分阶段落地;团队已有 branch protection 与严格 CI,希望每一层都守同一质量线。
不适合: 跨 fork 的开源贡献流(官方不支持);只想用 GitHub Desktop 的个人小项目;没有精力写 CI 裁剪逻辑、又对 Actions 用量敏感的团队——此时整栈 PR 反而更省 CI。
七、客观分析:优势与意义
优势: 把”级联 rebase”和”栈地图”这两件过去靠第三方 SaaS(Graphite 等)才能做的事收进官方第一方,消除了工具链锁定;对 Agent 工作流的适配(gh-stack skill、Webhook stack 对象)尤其及时——它默认了”代码由 agent 批量生产、人只做评审”的未来。
局限: preview 阶段行为可能变;跨 fork 缺席让开源社区贡献场景受损;CI 成本优化仍需使用者自己动手,官方给的是”钩子”而非”答案”。
总的来看,GitHub 这次不是在发明新流程,而是在把大公司内部用了多年的工程纪律,变成所有仓库都能用的默认能力——并且踩准了”Agent 写码、人来评审”这个正在成型的协作重心。