Gemma 4:Google 把 Gemini 3 研究下放给开源多模态模型
AI
开源
Google
多模态
大模型
Gemma
2026/9/29
·
阅读时间: 大约 6 分钟
Gemma 4:Google 把 Gemini 3 研究下放给开源多模态模型
Gemma 是 Google 的开源模型线,一直与闭源 Gemini 形成高低搭配。据 DeepMind 官方页面,Gemma 4 是”our most intelligent open models, built from Gemini 3 research and technology to maximize intelligence-per-parameter”——核心卖点是”每参数智能密度”,即在不堆参数的前提下尽量把 Gemini 3 的研究成果下放给可自部署的开放模型。本文基于官方页面实读数据。
一、两档定位:端侧与个人电脑
官方把模型分成两组:
- E2B & E4B:主打”最高的计算与内存效率”,面向手机、树莓派、Jetson Nano 等边缘设备,支持音视觉、可完全离线、近零延迟运行;
- 12B / 26B / 31B:主打”前所未有的每参数智能”,面向个人电脑、IDE、编码助手与 Agent 工作流,针对消费级 GPU 优化,“把工作站变成本地优先的 AI 服务器”。
也就是说,Gemma 4 同时覆盖”端侧离线”与”本地工作站”两个开源主战场。
二、官方基准(页面实读,截至 2026-04-02)
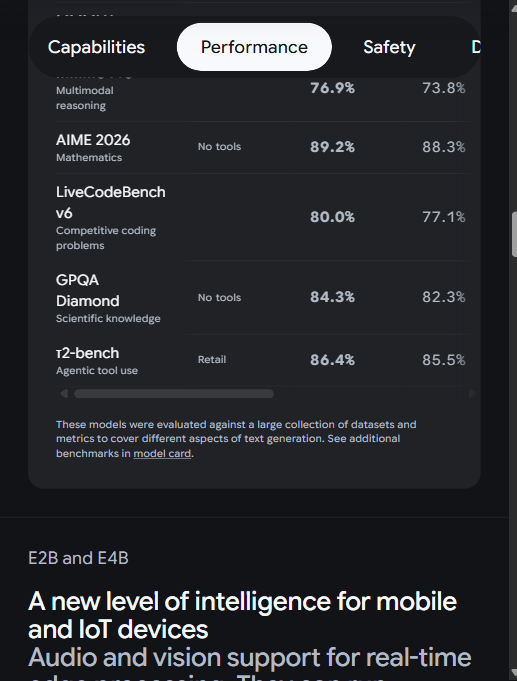
| 基准(No tools 除非标注) | 31B IT (Thinking) | 26B A4B IT | E4B IT | E2B IT | 对照 Gemma 3 27B |
|---|---|---|---|---|---|
| Arena AI(文本) | 1452 | 1441 | — | — | 1365 |
| MMMLU(多语种问答) | 85.2% | 82.6% | 69.4% | 60.0% | 67.6% |
| MMMU Pro(多模态推理) | 76.9% | 73.8% | 52.6% | 44.2% | 49.7% |
| AIME 2026(数学) | 89.2% | 88.3% | 42.5% | 37.5% | 20.8% |
| LiveCodeBench v6(竞赛编码) | 80.0% | 77.1% | 52.0% | 44.0% | 29.1% |
| GPQA Diamond(科学知识) | 84.3% | 82.3% | 58.6% | 43.4% | 42.4% |
| τ2-bench(零售 Agentic 工具调用) | 86.4% | 85.5% | 57.5% | 29.4% | 6.6% |
可以看到,31B 相对上一代 Gemma 3 27B 提升明显(AIME 从 20.8% 到 89.2%、LiveCodeBench 从 29.1% 到 80%),而最小的 E2B 在 Agentic 任务(τ2-bench 仅 29.4%)上仍与 31B 有数量级差距。
三、能力面(官方列出)
- Agentic 工作流:原生支持 function calling,可规划、操作应用、完成任务;
- 多模态推理:具备较强的音频与视觉理解;
- 140 种语言:不止翻译,强调理解文化语境;
- 可微调:可用自选框架微调;
- 高效架构:可跑在自有硬件上。
四、口径偏差与局限
- 基准是官方自测、且标注”No tools”:AIME/GPQA 等”No tools”成绩是模型裸推理;编码与 Agentic 成绩则是另一类设置。跨基准比较时注意是否带工具。
- “每参数智能”是营销叙事:1452 vs 1365 的 Arena 分差确实领先旧版,但与闭源旗舰的同场对比官方并未给出。
- E 系列能力衰减快:E2B 在 τ2-bench 仅 29.4%,端侧小模型做 Agentic 仍不现实;“能离线跑”≠“能干活”。
- 对标口径:官方只与自家 Gemma 3 27B 对比,未直接同场比较 Qwen/Mistral 同规格模型——第三方横评仍需自查。
- 配图说明:两张图均截自 DeepMind 官方 Gemma 4 页面(首屏定位与 Performance 基准表),数据以官方 model card 为准。
五、适用 / 不适用
适合:
- 要在手机/树莓派/Jetson 上离线跑多模态小模型的场景;
- 想用消费级 GPU 把工作站变成本地 AI 服务器、做编码助手的开发者;
- 需要开源权重、可微调、自部署的团队。
不适用:
- 追求闭源旗舰级推理上限的任务;
- 期待 E2B/E4B 胜任复杂 Agentic 工具调用的场景(τ2-bench 仅 ~30%)。
六、它意味着什么
Gemma 4 的看点是”下放”:把 Gemini 3 的研究做成端侧到工作站都能跑的开源模型,且 31B 在数学、编码上的官方数字相当亮眼。它是否真能在同规格开源模型里占优,还要看第三方横评;但方向明确——Google 在认真缩小开源线与 Gemini 之间的差距,并把多模态、函数调用、140 语言做成全系标配。