Gemini 3:Google 把「满配」旗舰押在推理与 Agent 上
阅读时间: 大约 11 分钟
Gemini 3:Google 把「满配」旗舰押在推理与 Agent 上
2025 年 11 月 18 日,Google CEO Sundar Pichai 与 DeepMind 的 Demis Hassabis、Koray Kavukcuoglu 共同署名,发布了 Gemini 3——官方口径里「我们有史以来最智能的模型」。它以 Gemini 3 Pro 预览版 的形态当天进入 Gemini App、AI Studio、Vertex AI 与新发布的 Agent 开发平台 Antigravity,同时推出强化推理的 Deep Think 模式。本文不重复公关稿,而是基于其官方自评基准表,看清楚这代模型到底强在哪、哪些数字有前提、以及宣传语与表格之间的落差。
一、背景:Google 的「全栈」叙事
Pichai 在开篇给了一组大盘数字:AI Overviews 月活 20 亿、Gemini App 月活 6.5 亿、70% 的 Cloud 客户在用其 AI、1300 万开发者基于其生成式模型开发。这组数字的潜台词是——Google 卖的不是单个模型,而是「自研芯片基础设施 → 模型 → 开发者工具 → 搜索/Workspace 十亿级产品」的闭环。Gemini 3 的发布因此不只是模型升级,而是这套全栈第一次在搜索首日就随新版模型一起上线(AI Mode in Search)。
二、Pro 版基准:一张表看清强弱分布
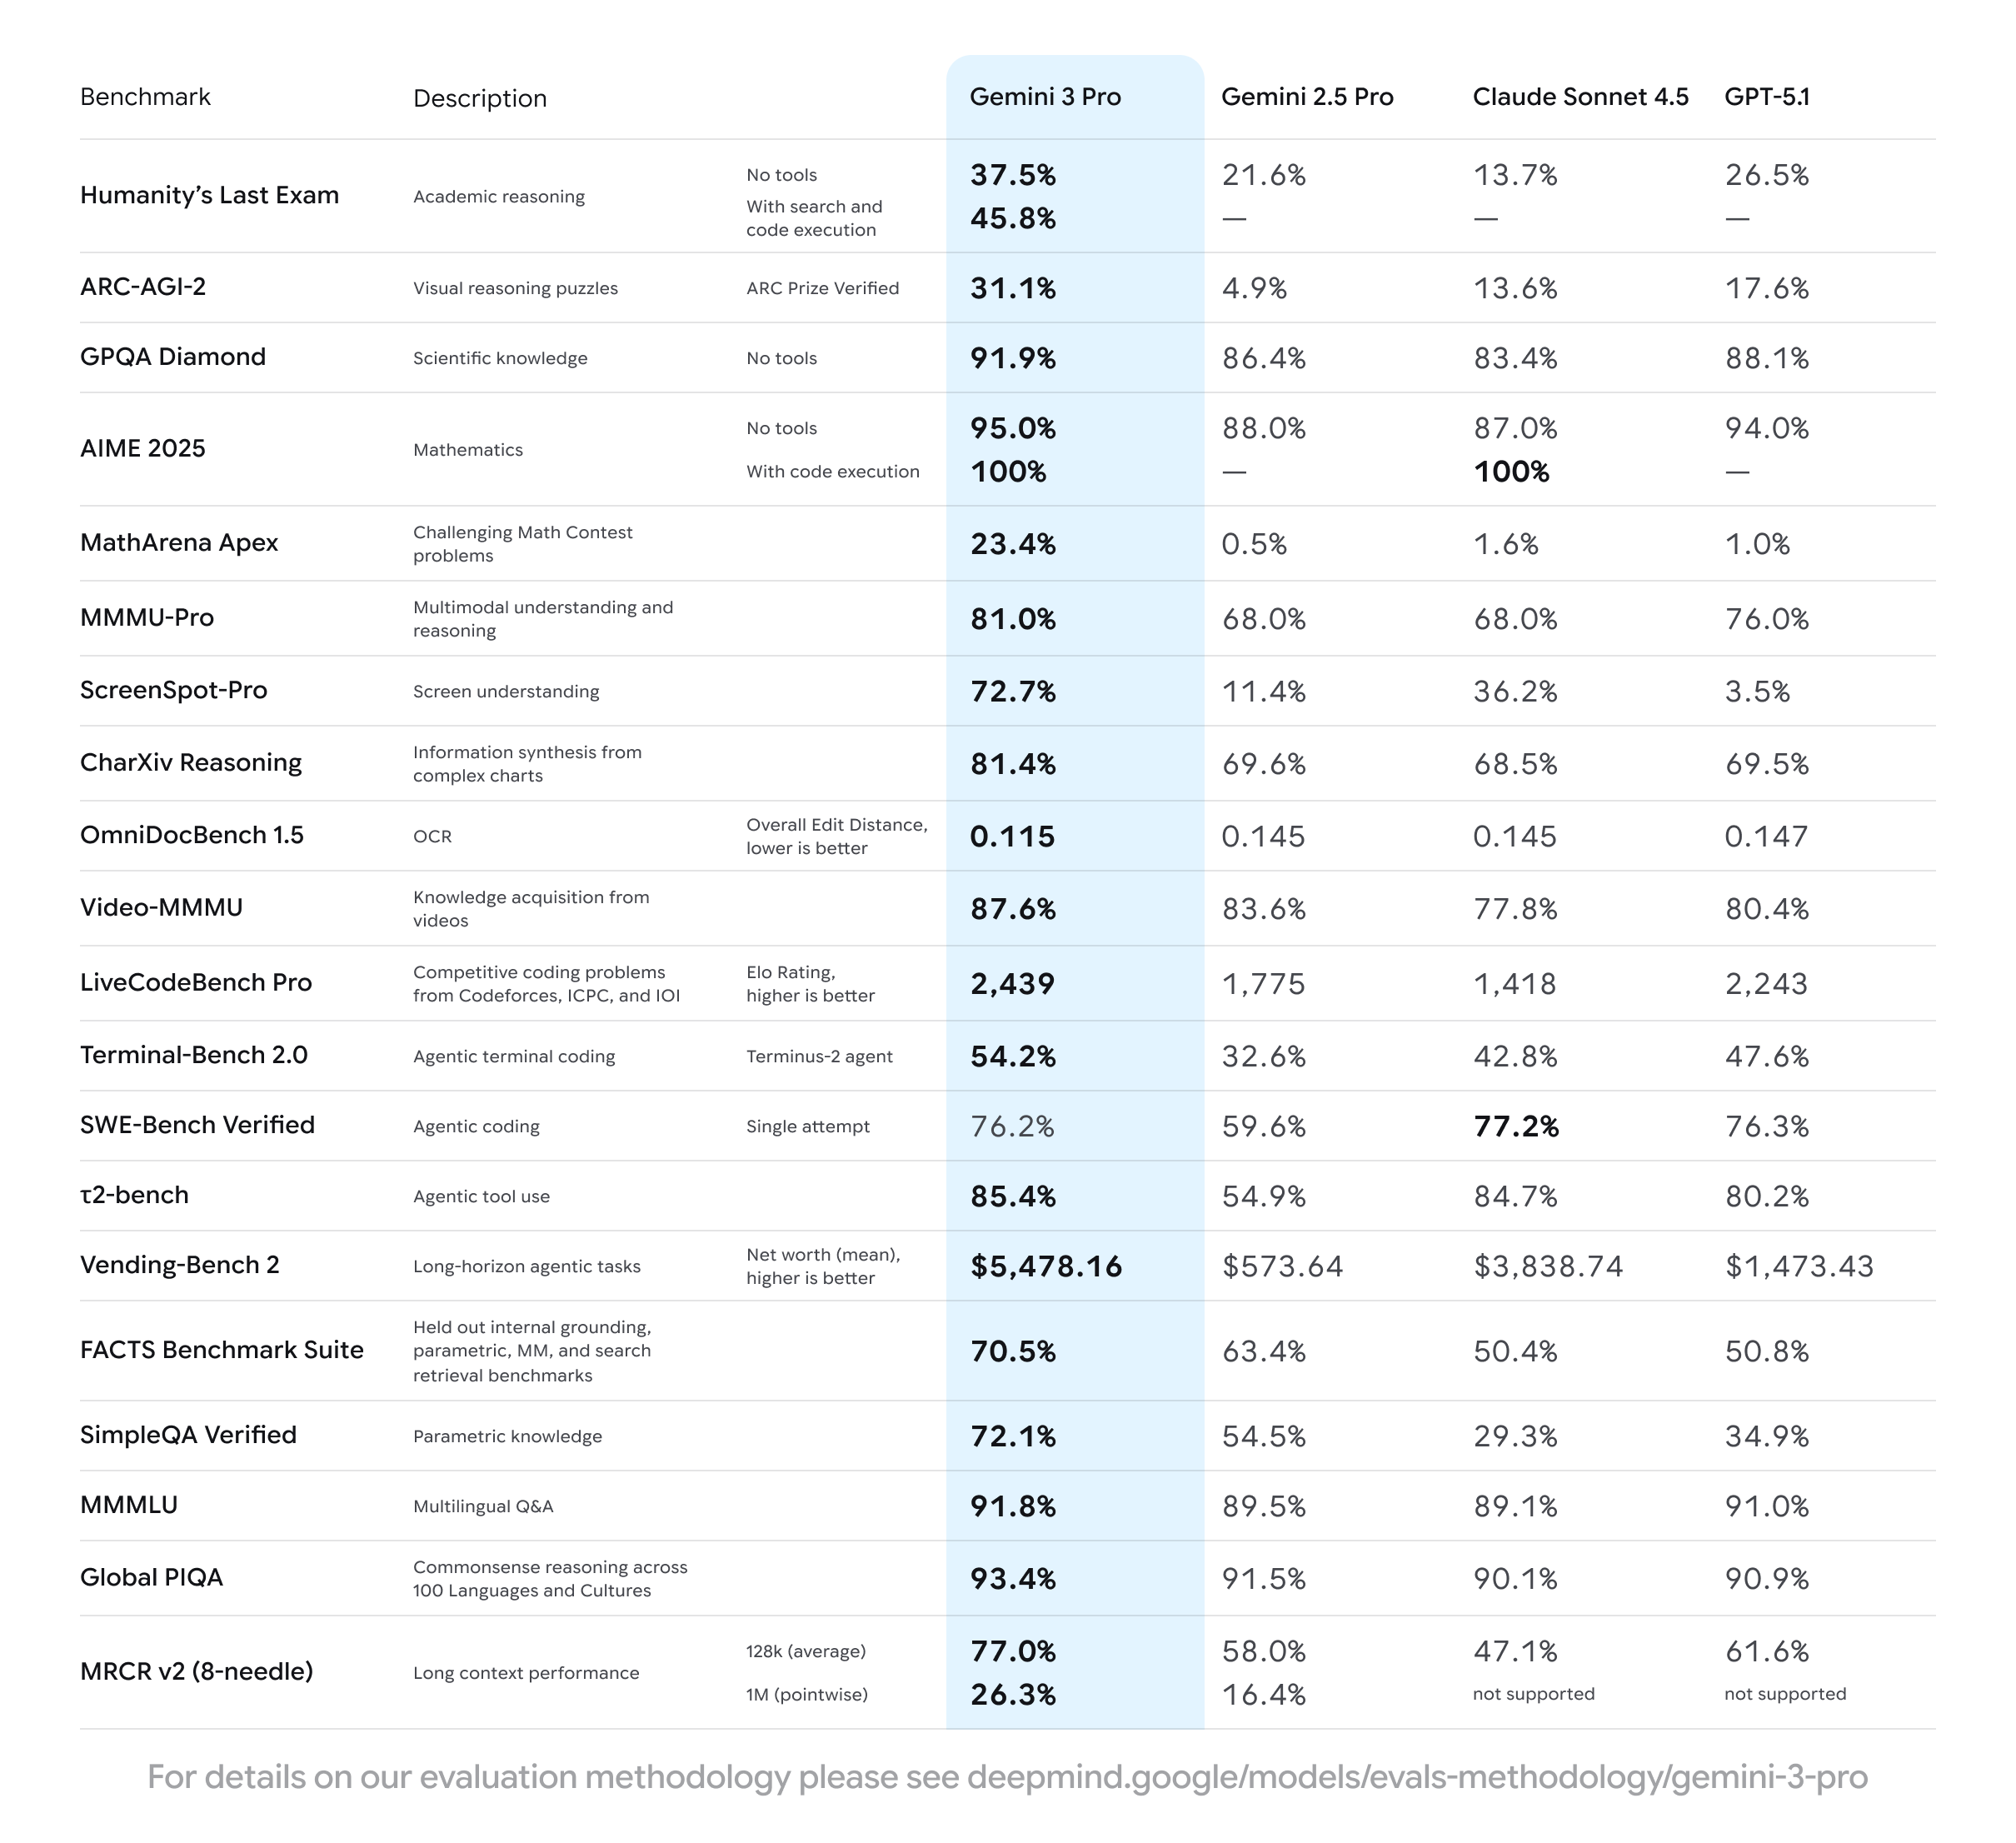
官方公布的 Gemini 3 Pro(无工具)成绩里,最常被引用的几个:LMArena 1501 Elo(登顶)、GPQA Diamond 91.9%、Humanity’s Last Exam 37.5%、MathArena Apex 23.4%、多模态 MMMU-Pro 81%、Video-MMMU 87.6%、事实性 SimpleQA Verified 72.1%。
但把整张官方表读完,强弱分布其实很不均匀:
| 基准(条件) | Gemini 3 Pro | Gemini 2.5 Pro | Claude Sonnet 4.5 | GPT-5.1 |
|---|---|---|---|---|
| HLE(无工具) | 37.5% | 21.6% | 13.7% | 26.5% |
| GPQA Diamond(无工具) | 91.9% | 86.4% | 83.4% | 88.1% |
| MathArena Apex | 23.4% | 0.5% | 1.6% | 1.0% |
| LiveCodeBench Pro(Elo) | 2,439 | 1,775 | 1,418 | 2,243 |
| Terminal-Bench 2.0 | 54.2% | 32.6% | 42.8% | 47.6% |
| SWE-Bench Verified(单次) | 76.2% | 59.6% | 77.2% | 76.3% |
| ScreenSpot-Pro | 72.7% | 11.4% | 36.2% | 3.5% |
| Vending-Bench 2(净资产均值) | $5,478 | $574 | $3,839 | $1,473 |
| MRCR v2(1M pointwise) | 26.3% | 16.4% | 不支持 | 不支持 |
三、Deep Think:用更多思考换更难的题
Deep Think 是一个「想得更久」的推理模式,不在首日开放,而是先给安全测试者、之后再向 Google AI Ultra 订阅者推送。官方给出的对比是:
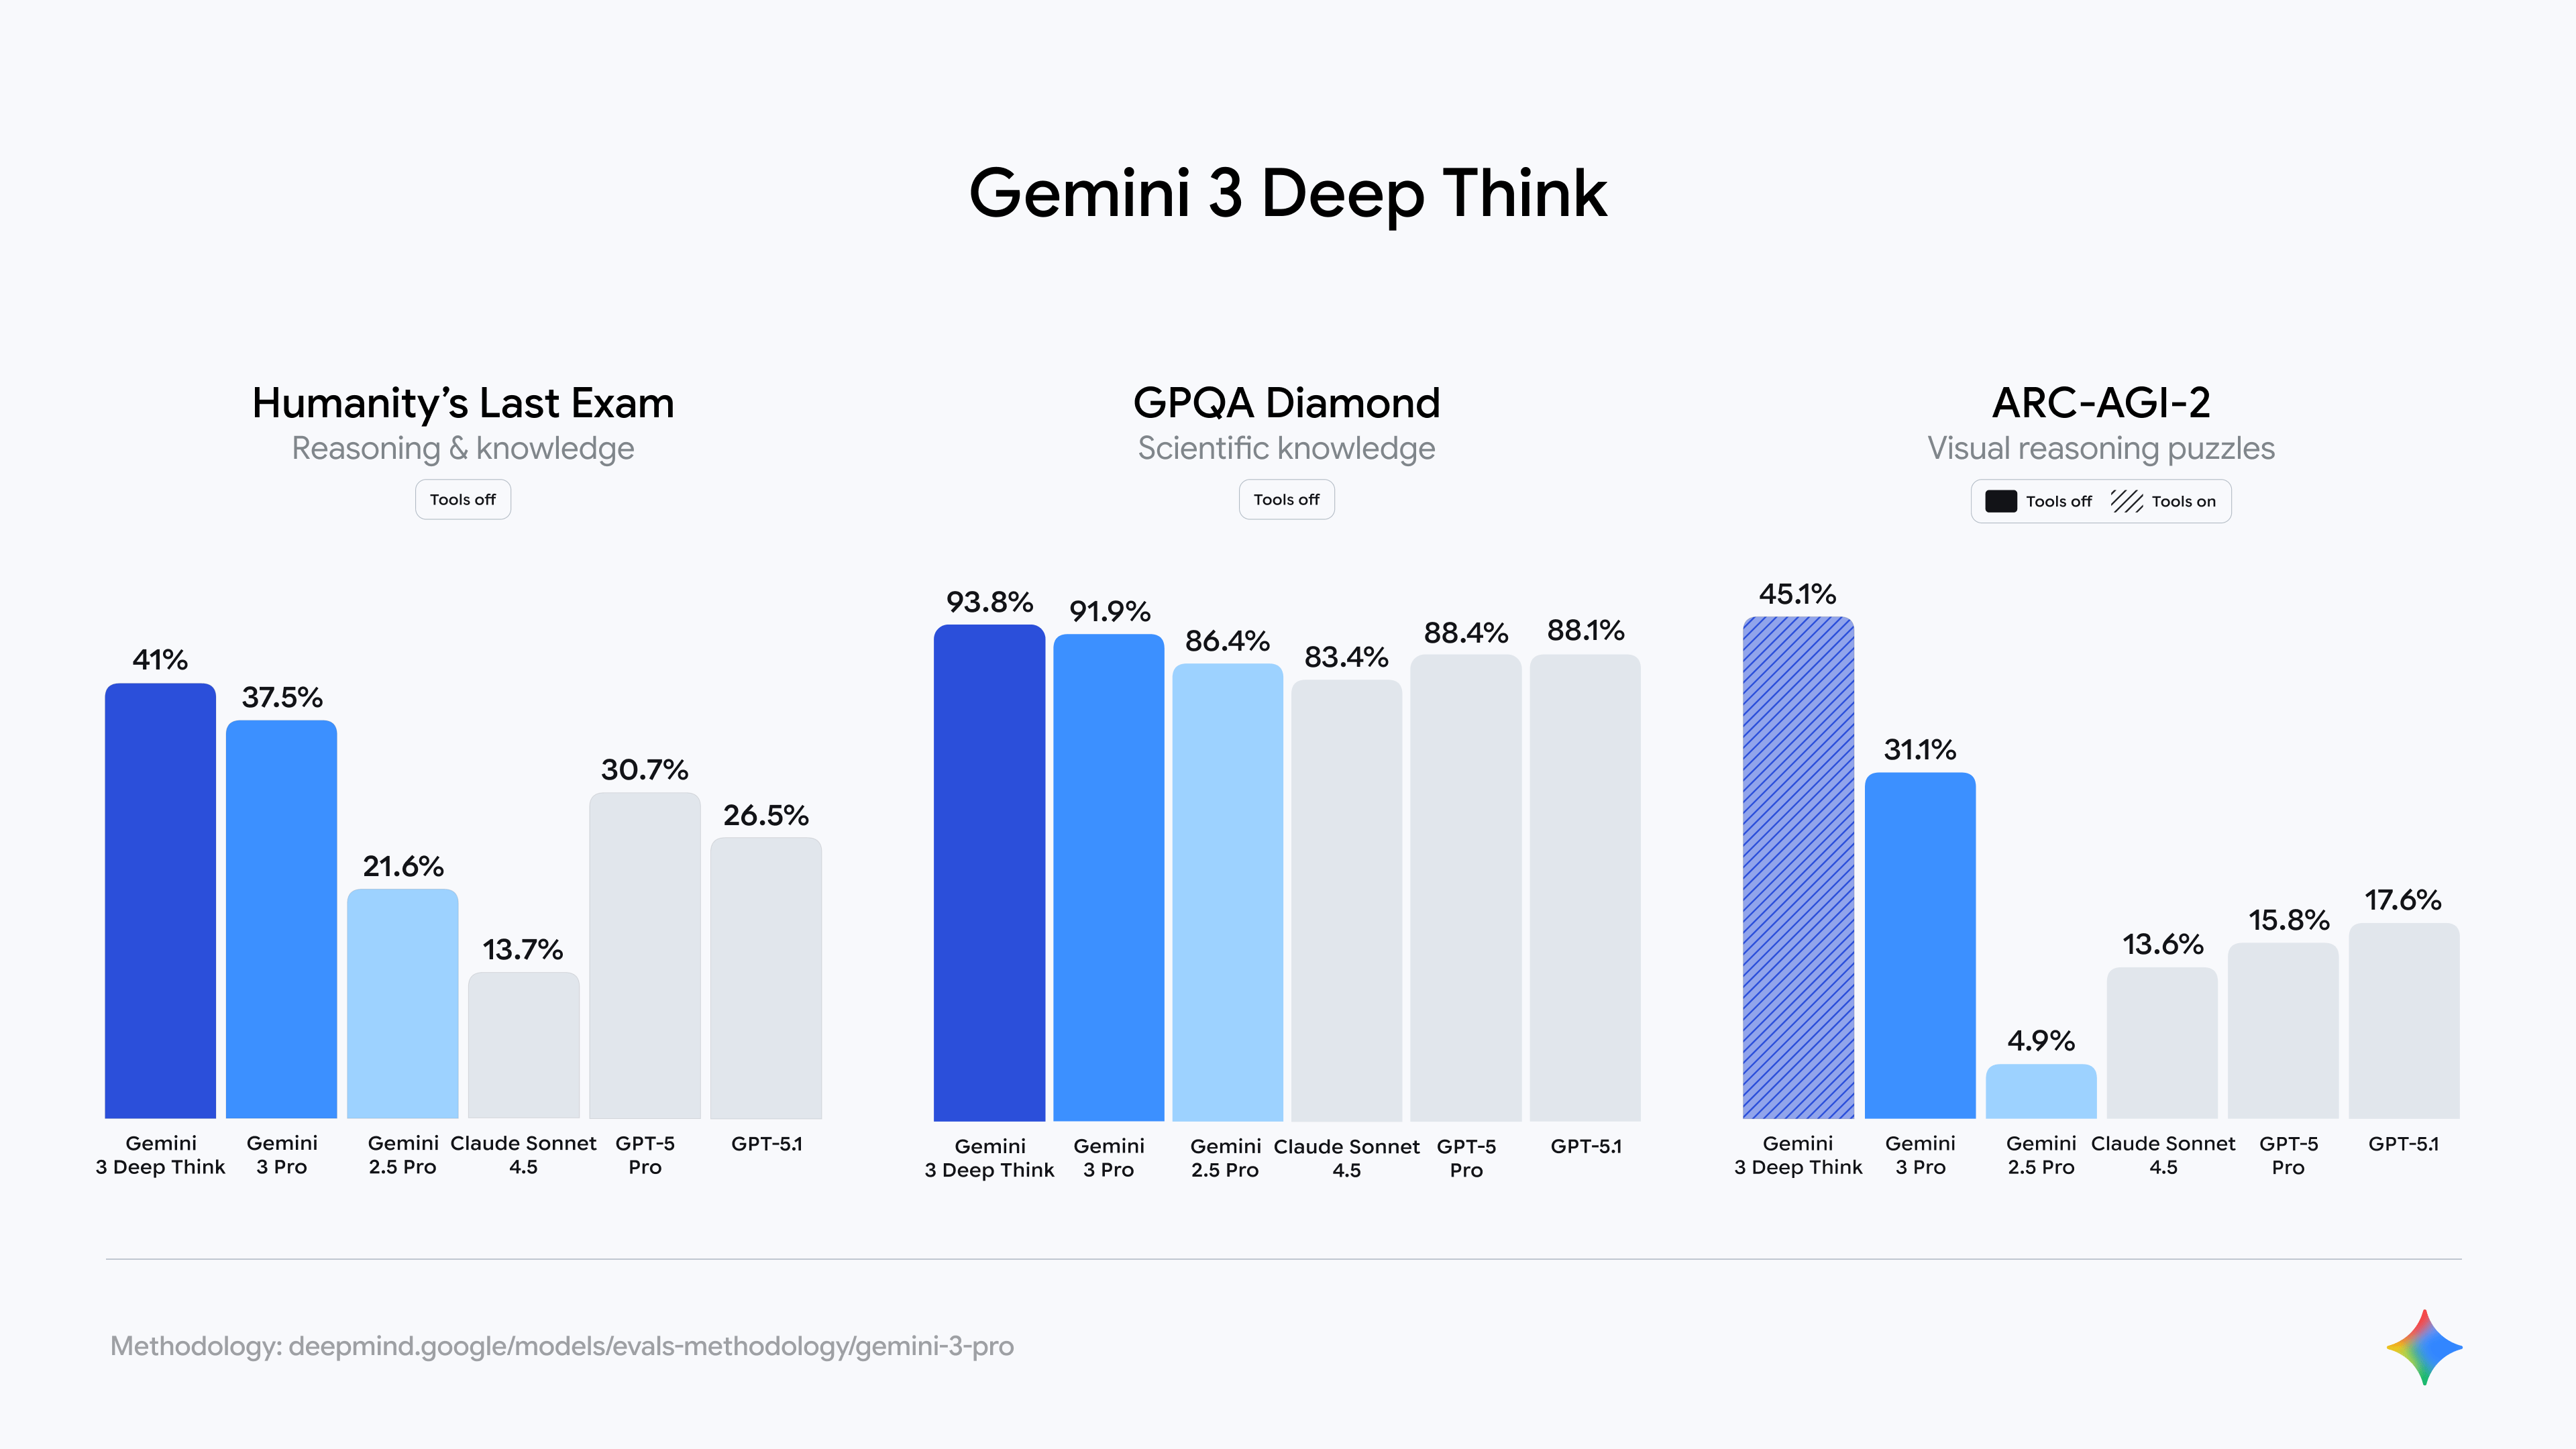
- HLE:Deep Think 41.0%,Pro 为 37.5%;
- GPQA Diamond:Deep Think 93.8%,Pro 为 91.9%;
- ARC-AGI-2:Deep Think 45.1%(带代码执行,ARC Prize Verified),Pro 为 31.1%。
注意这张图里 ARC-AGI-2 的 Deep Think 柱子是**斜纹(tools on)**填充,而 HLE、GPQA 标注的是 Tools off——三组数字并不在同一「工具使用」口径下,横向比时必须连同条件一起读。
四、Agentic 是这代的真正卖点
比起单点跑分,Google 这次更想卖的是「端到端干活」的能力。三块拼图:
- WebDev Arena 1487 Elo 登顶、Terminal-Bench 2.0 54.2%、τ2-bench 85.4%,主打 vibe coding 与终端工具调用;
- Google Antigravity:一个新的 Agent-first 开发平台,把 Agent 从 IDE 侧边栏提升到「独立面板」,可直接操作编辑器、终端、浏览器,并自己验证自己写的代码——它还同时捆绑了 Gemini 2.5 Computer Use(浏览器控制)和 Nano Banana(Gemini 2.5 Image 图像编辑);
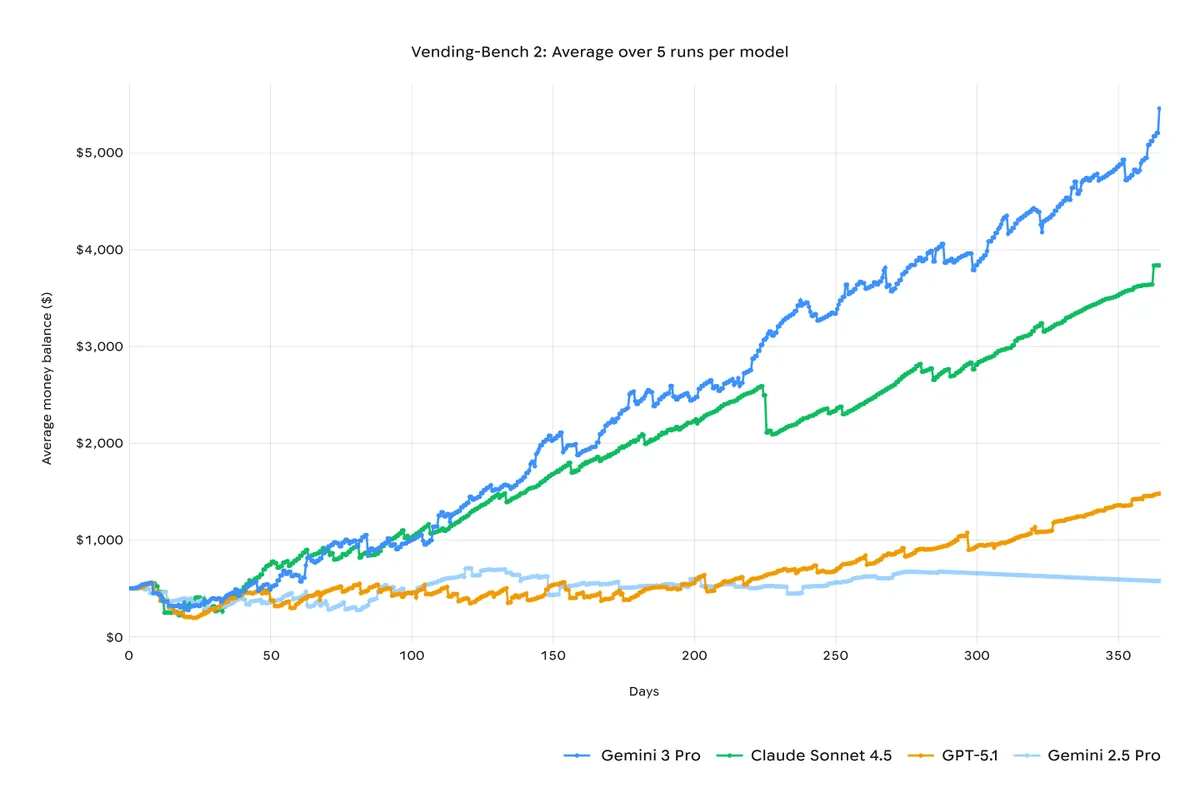
- Vending-Bench 2 长程规划:模拟经营一台自动售货机整整一年,Gemini 3 Pro 净资产均值 $5,478,远超 2.5 Pro 的 $574。
四点五、发布即全量铺开:不止是模型
值得单独一说的是这次的分发节奏。Gemini 3 Pro 上线当天就同时抵达五个入口:面向普通用户的 Gemini App、面向开发者的 AI Studio 与 Vertex AI、面向企业的 Gemini Enterprise,以及新平台 Antigravity;第三方侧还接进了 Cursor、GitHub、JetBrains、Manus、Replit。更关键的是,这是 Google 第一次让新模型在搜索(AI Mode)上线首日就随版本一起发布——等于把模型能力直接灌进了它月活 20 亿的 AI Overviews。这种「模型—工具—产品—搜索」同一天打通的节奏,正是 Pichai 在开篇强调的全栈打法:benchmark 的故事最终要落到「你明天打开搜索就能用到」。
五、评测方法批判:宣传语没说出口的部分
这是本文最想强调的一节。官方说「Gemini 3 Pro 在每一个主要基准上都显著超过 2.5 Pro」——这句话成立,但它没有说「全面超越所有竞品」,而表格里至少有三处落差:
- SWE-Bench Verified 上它并没有赢:Gemini 3 Pro 76.2%,反而略低于 Claude Sonnet 4.5 的 77.2%、也基本追平 GPT-5.1 的 76.3%。考虑到官方称其为「我们做过最好的编码 Agent 模型」,这个单项需要读者自己打个折;
- 条件不统一:HLE/GPQA 是「无工具」,ARC-AGI-2 Deep Think 是「带代码执行」,AIME 2025 拆开「无工具 95.0% / 带代码执行 100%」。脱离这些条件谈「91.9%」「45.1%」都是不严谨的;
- 对比模型由 Google 自己跑:表里 Claude Sonnet 4.5、GPT-5.1 等成绩是 Google 按自家方法论(deepmind.google/models/evals-methodology/gemini-3-pro)测得的,不是各厂商官方数字,存在测试集污染与路由选择的天然偏向;
- 1M 长上下文其实仍弱:MRCR v2 的 1M pointwise 只有 26.3%(128k 平均还有 77.0%)——「100 万 token 上下文」听着唬人,但在最长刻度上的实际检索准确率仍不到三成;
- Deep Think 尚未 GA:发稿时它只在安全测试者手里,Ultra 订阅者要「未来几周」才用上,现在评价其体感为时尚早。
六、优势与局限
优势:
- 无工具推理(HLE、GPQA、MathArena Apex)确实拉开身位,尤其数学竞赛类断层领先;
- 屏幕理解 ScreenSpot-Pro 72.7%、视频理解 Video-MMMU 87.6%,多模态与「看懂屏幕」能力是真护城河;
- 全栈一体化:模型即日进搜索、Antigravity 把 Agent 变成主动执行者,落地链路最短。
局限:
- 编码 Agent 的旗舰口碑单项(SWE-Bench)并未胜出,宣传与表格有温差;
- Deep Think 延迟与成本代价官方未披露,且尚未正式开放;
- 1M 上下文的极长检索准确率低,长文档别盲目堆 token;
- 全部数字为厂商自评,第三方独立复测尚未充分展开。
七、谁该关注
- 重度使用 Google 生态、需要多模态 + 长上下文 + Agent 自动干活的开发者,Antigravity 值得第一时间试;
- 做数学/科学推理、屏幕与视频理解产品的团队,这代是当前第一梯队;
- 但如果你的核心场景就是写生产级代码、过 SWE-Bench 类验证,建议同时跑一遍 Claude Sonnet 4.5 再下结论——表格已经替它说了话。