Fuse.js:8KB 的 Bitap 模糊搜索,为什么文档站到今天还离不开它
阅读时间: 大约 7 分钟
Fuse.js:8KB 的 Bitap 模糊搜索,为什么文档站到今天还离不开它
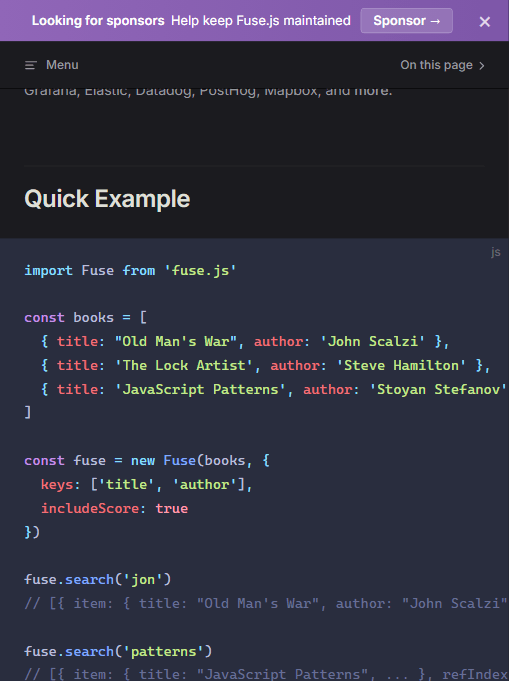
在大模型问答、语义搜索(embedding + 向量库)大行其道的 2026 年,一个看起来”上古”的工具还在被广泛使用:Fuse.js。它是一个零依赖的 JavaScript 模糊搜索库,核心是经典的 Bitap 算法,gzip 后完整版约 8.6KB、基础版约 6.8KB(Koala 周报口径”完整版 8KB”与官方一致)。官方信任名单相当豪华:Google、Microsoft、Anthropic、Atlassian、Spotify、MongoDB、Vercel、Adobe、Signal、Datadog、PostHog、Mapbox 等。为什么在 AI 搜索时代它没被淘汰?本文基于 fusejs.io 官方文档实读分析。
一、它是干什么的:打错字也能搜到
Fuse.js 解决的是一个非常具体的问题:用户打错字、记得不准时,本地客户端如何毫秒级返回相关结果。比如搜 jon 能命中作者 John Scalzi(score 0.25),搜 patterns 精确命中 JavaScript Patterns(score 0.0,0 分表示完全匹配)——这就是 Bitap 的容错匹配能力。
官方特性清单(首页实读):
- 模糊搜索:Bitap 驱动的容错匹配;
- Token 搜索:多词查询拆成词项分别 Bitap 匹配,再用 IDF 加权排序;
- 扩展搜索:支持
^term(前缀)、term$(后缀)、!term(排除)等操作符; - 逻辑搜索:
$and/$or组合; - 加权字段:title 权重高于 description;
- 嵌套字段:点号/数组路径取值;
- 双构建:full ~8.6KB gzip / basic ~6.8KB gzip。
二、性能数字:官方自己把账算明白了
Fuse.js 性能页难得地给出了一张完整的实测表(官方在 v7.4.0 中宣布索引创建提速:对象集合约 +30%、字符串列表约 +60%):
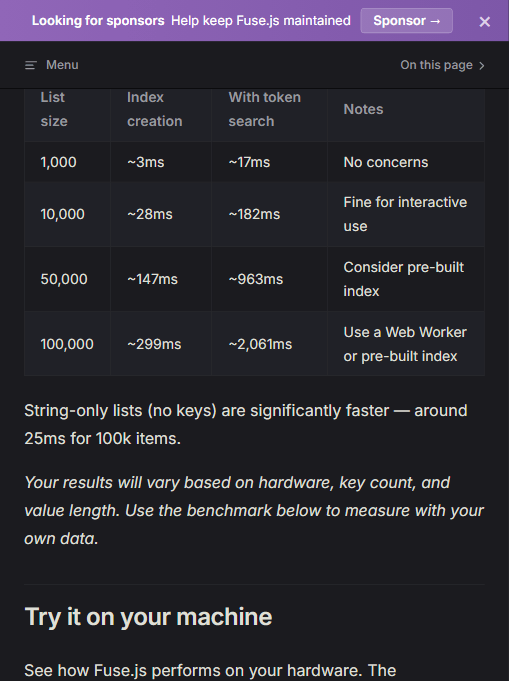
按官方口径,这是”现代机器、3 个可搜索字段(title/body/tags)“下的测量:
| 数据量 | 索引创建 | 带 Token 搜索 | 官方建议 |
|---|---|---|---|
| 1,000 条 | ~3 ms | ~17 ms | 无需关心 |
| 10,000 条 | ~28 ms | ~182 ms | 交互场景可用 |
| 50,000 条 | ~147 ms | ~963 ms | 考虑预建索引 |
| 100,000 条 | ~299 ms | ~2,061 ms | 用 Web Worker 或预建索引 |
纯字符串列表(不建字段索引)10 万条约 25ms,快得多。算法复杂度上,Bitap 单次匹配是 O(n×m)(n 文本长度、m 模式长度),官方把模式串默认限制在 32 字符来约束最坏情况;内存方面官方称 10 万条以内通常只占几 MB。
三、口径与方法批判
这张表需要带着方法学眼光看:
- “现代机器”没有具体型号。 官方同时注明”你的结果会因硬件、字段数、文本长度而异”,并在页面上放了一个可在本机跑的 benchmark(Web Worker 里跑 50 次取平均)——这是负责任的做法,但表中数字不能直接当成你项目里的承诺。
- Token 搜索代价是线性叠加的。 官方自己说明:
useTokenSearch会对每个查询词跑一遍 Bitap,所以多词查询耗时随词数增长。10 万条 2 秒的数正是带 token search 的结果,裸模糊搜索会快一个量级。 - 它不做语义。 Fuse 匹配的是字符串编辑距离,不是”意思相近”。官方专门写了一篇 vs Semantic Search文章讨论边界——它替代不了向量搜索,只在”知道大致关键词、可能打错字”的场景最优。
- 线性扫描的天花板。 搜索复杂度随数据量线性增长,10 万条以上就建议 Worker 化;它从来不是为十万级以上数据集设计的,那个量级该上 Elasticsearch/Algolia。
四、新动向:Fuse Cloud 与 Swift 移植
首页挂着两个值得注意的新动作:
- Fuse Cloud:托管搜索 API——“上传 JSON,拿一个 endpoint”,官方标注 Coming Soon。说明作者在探索”免费库 + 托管服务”的可持续维护模式(页面顶部一直在求赞助);
- fuse-swift:官方 Swift 移植版,声称与 JS 版”字节级结果一致”,支持 Apple 全家平台,目前 RC 阶段。
五、客观评价
优势:
- 零依赖、体积极小、API 极简,集成成本几乎为零;
- Bitap 容错 + IDF token 排序,在”文档站即时搜索”这个具体场景体验成熟;
- 性能文档诚实,给出了可自测的 benchmark;
- 生态位稳固,大量文档站(VitePress 类)至今在用。
局限:
- 纯字符串匹配,不懂语义,同义词/概念关联无能为力;
- 数据量过 10 万就要上 Worker/预索引,不是无限扩展的方案;
- 维护靠赞助,可持续性是个隐性风险(页面常年挂着 sponsor 横幅);
- “Fuse Cloud” 未发布,托管路线尚未验证。
六、谁该用
技术文档站、带站内搜索的小型内容站、CLI/桌面应用的本地搜索框、任何”几百到几万条结构化文本 + 用户可能打错字”的场景——这是 Fuse.js 的甜区,至今没有更优解。需要语义联想、跨语言概念检索、百万级语料的场景,请直接上向量搜索。