Fluid:Kubernetes 上的分布式数据集编排与缓存加速平台
阅读时间: 大约 13 分钟
Fluid:Kubernetes 上的分布式数据集编排与缓存加速平台
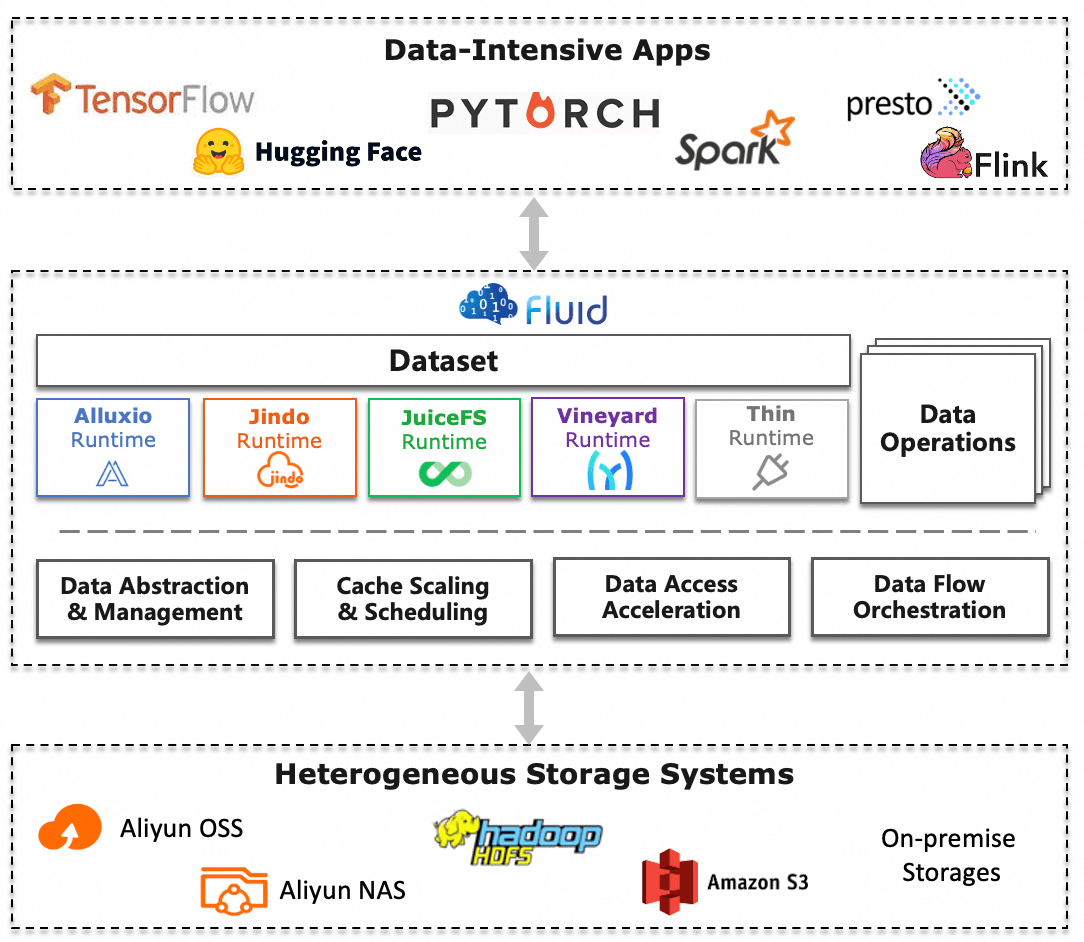
Fluid 是一个 Kubernetes-native 的分布式数据集编排与加速(Distributed Dataset Orchestrator and Accelerator)项目,面向大数据与 AI 训练这类数据密集型负载,2021 年 4 月被 CNCF 接收为 Sandbox 项目,并于 2026 年 1 月 8 日被 CNCF TOC 接纳为 Incubating(孵化)项目。仓库 fluid-cloudnative/fluid 采用 Apache-2.0 协议,主体用 Go 编写(约 95%),调研时约 2.0k star、1.3k fork、1087 位贡献者,最新发布为 v1.0.8(2025-10-31)。本文基于官方 README、核心概念与架构文档,说明 Fluid 解决什么问题、怎么工作,以及它没有承诺什么。
一、背景动机:存算分离带来的 IO 墙
官方在 Introduction 里把动机归为三点:
- 存算分离的代价:云原生弹性用得越充分,计算与数据离得越远,深度学习训练反复远程读取海量样本会显著拖慢 GPU 利用率,产生访问时延与大带宽开销;
- K8s 缺”数据管理”标准:CSI 只定义了异构存储怎么挂给容器,却没有定义应用怎么使用和管理数据——数据集版本、权限、预处理、预热加速在 K8s 里没有一等公民抽象;
- 形态碎片化:原生 K8s、边缘 K8s、Serverless K8s 对第三方 CSI 插件支持不一,很多 Serverless 集群根本不让部署 CSI。
Fluid 的回答是:不另造存储,而是把”在 K8s 上使用数据的过程”抽象成 Dataset,并把分布式缓存系统(Alluxio、JuiceFS 等)包装成可观测、可自管、可弹性伸缩、可自愈的缓存服务。
二、核心概念:Dataset 与 Runtime
- Dataset(数据集):应用视角的统一抽象,把来自 HDFS、S3、阿里云 OSS、原生 PVC 等多个数据源汇聚到统一命名空间(可挂到不同子目录),并携带可观测信息:数据集总量、当前缓存空间、缓存命中率,供用户判断缓存该不该扩缩。
- Runtime(运行时):Dataset 只是抽象,真正的数据操作由 Runtime 实现,生命周期由 Fluid 统一管理。分两类:
- CacheRuntime(缓存加速型):
AlluxioRuntime(加速 S3/HDFS)、JuiceFSRuntime(JuiceFS)、JindoRuntime/JindoCache(加速 OSS、OSS+HDFS)、GooseFSRuntime(支持 COS)、VineyardRuntime(内存对象); - ThinRuntime(薄接入型):提供统一访问接口接入 s3fs、nfs-fuse 等第三方存储,不需要额外开发。
- CacheRuntime(缓存加速型):
三、技术机制:控制面 + 数据面
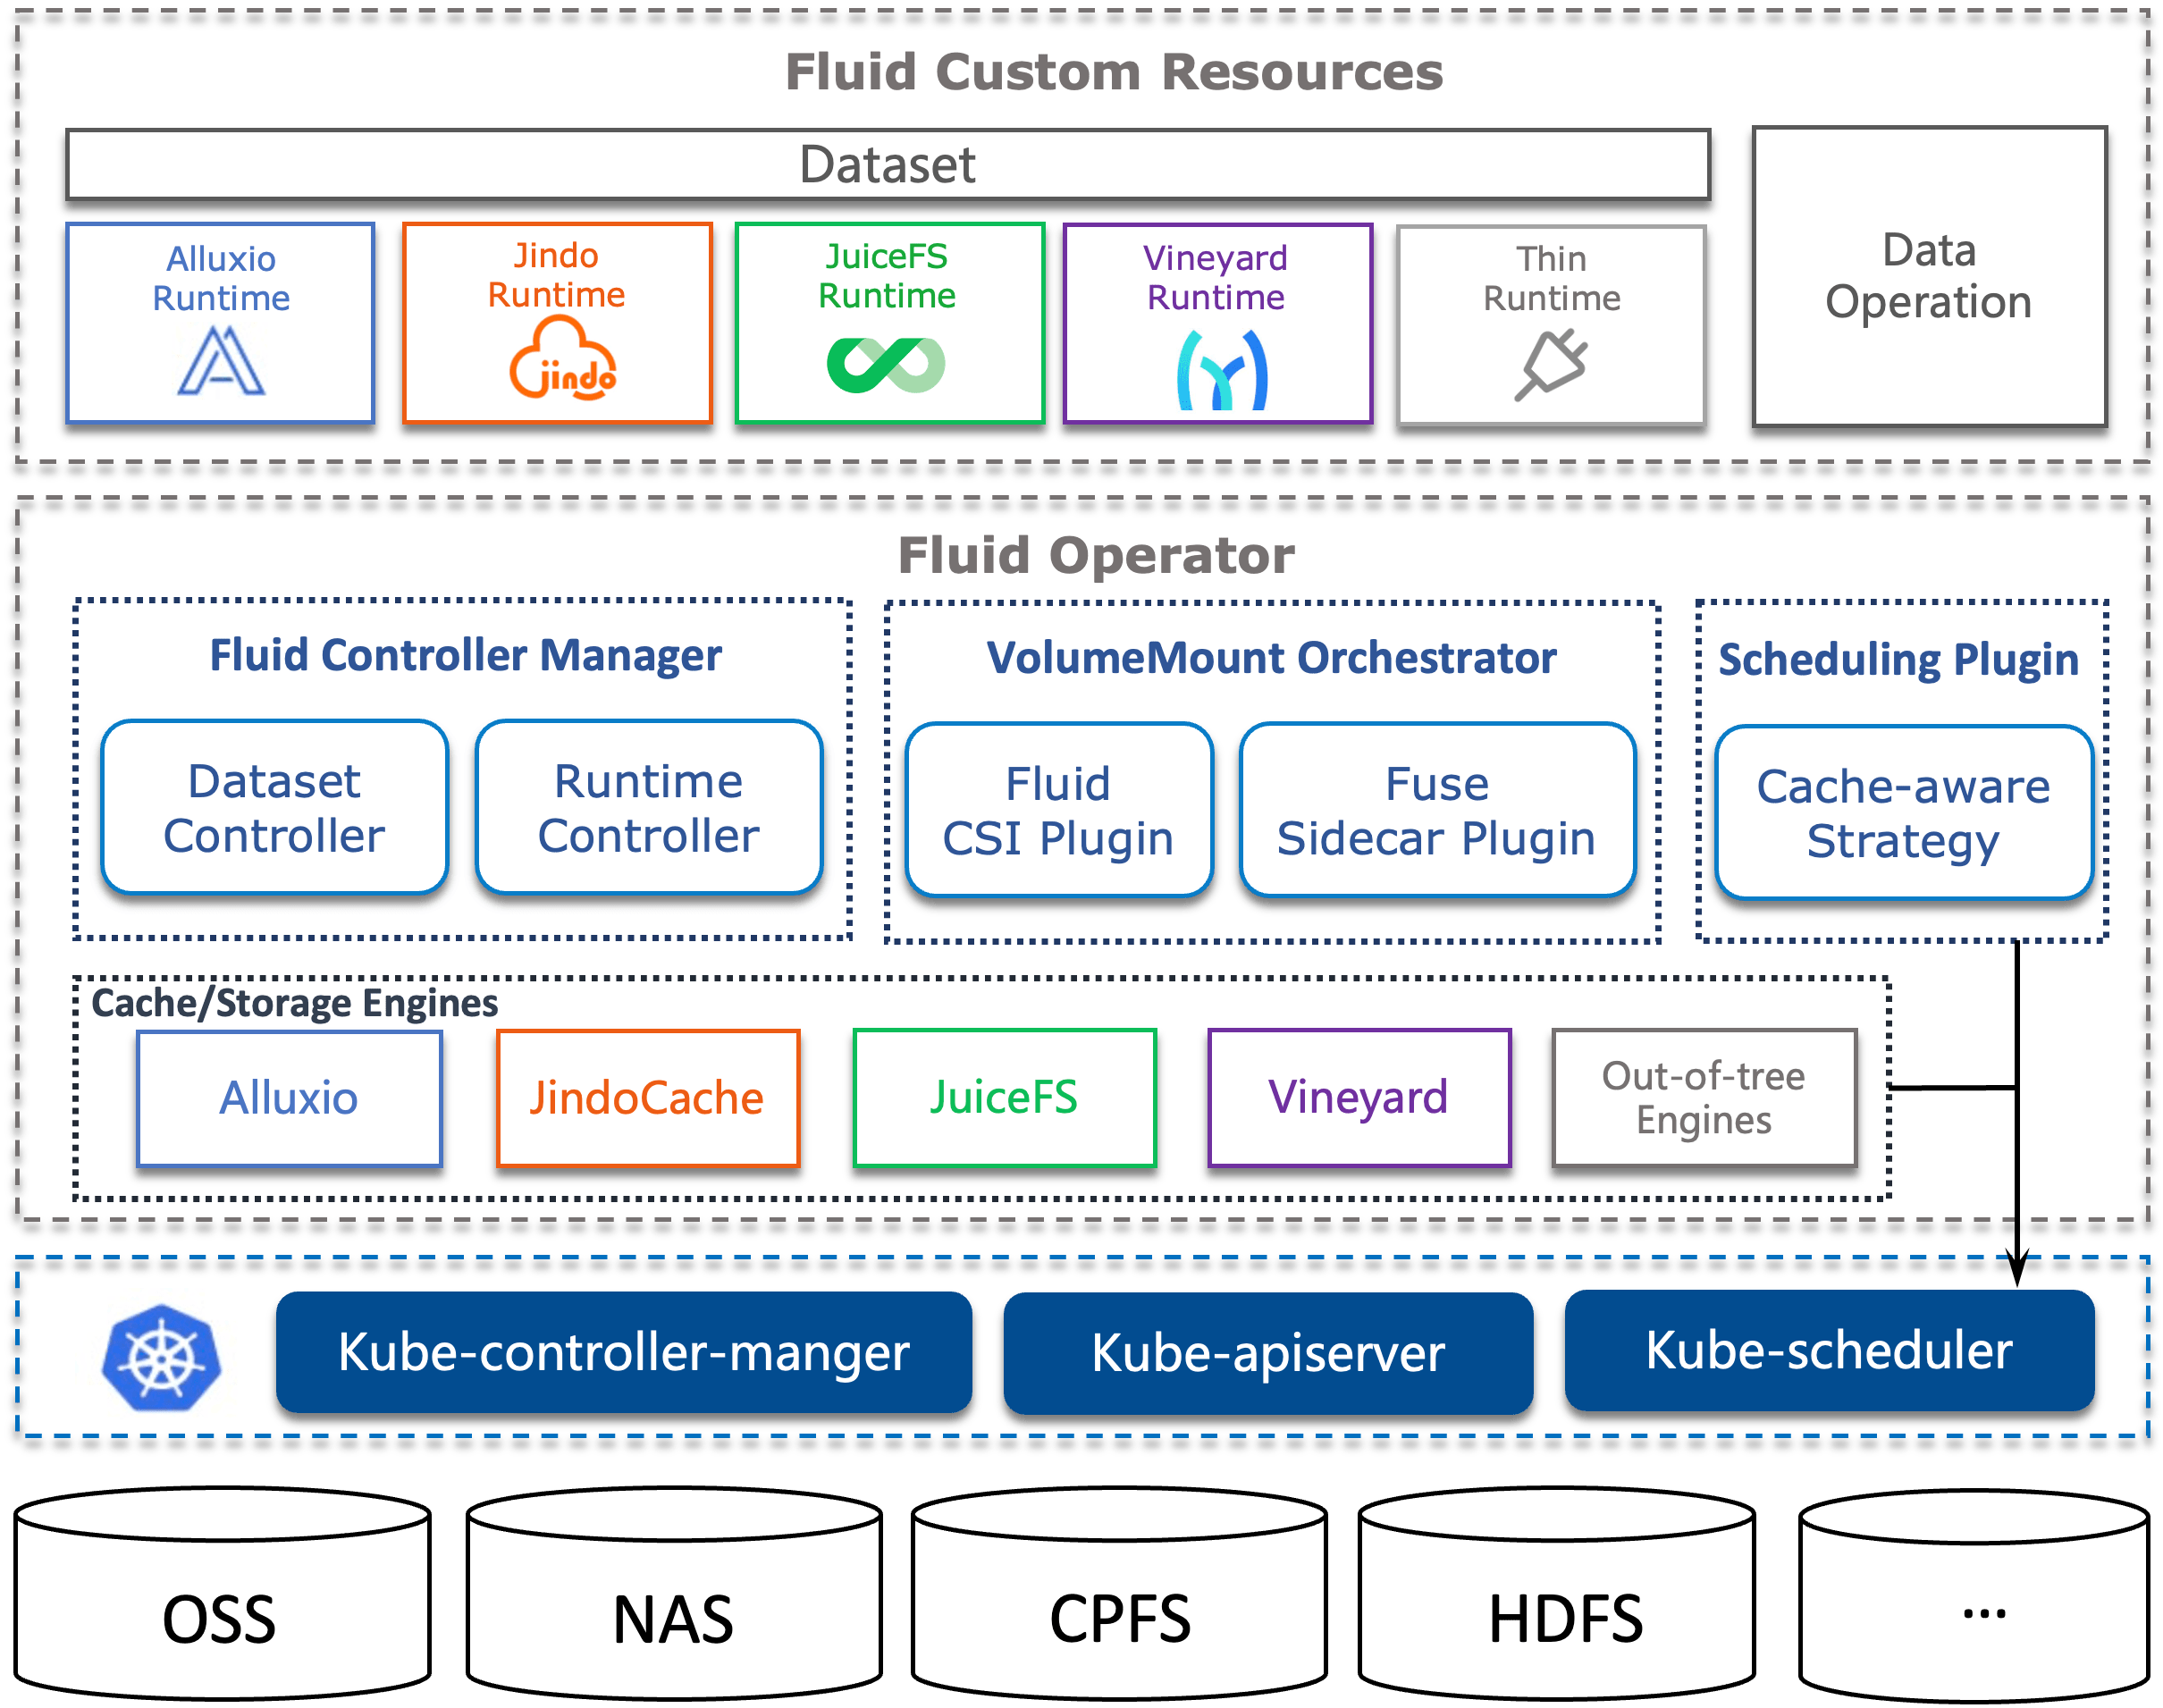
官方架构文档把 Fluid 拆成两层:
控制面
- Dataset/Runtime Manager:负责数据集及其 Runtime 的调度、迁移、弹性伸缩,以及细粒度数据预热(可指定只预热某个目录)、元数据备份恢复(针对海量小文件场景)、缓存数据 pinning(避免被淘汰导致性能抖动);
- Application Manager:含 Scheduler 与 Sidecar Webhook。Scheduler 把缓存信息纳入调度,优先把使用该数据集的 Pod 调到已有数据缓存的节点,用户无需手工指定缓存节点;Sidecar Webhook 在无法运行 csi-plugin 的环境(如部分 Serverless K8s)自动把 PVC 替换为 FUSE sidecar,并控制容器启动顺序保证 FUSE 先起。
数据面
- Runtime Plugin:高度可扩展的插件,抽象缓存介质、配额、目录等共性,背后引擎架构各异——AlluxioRuntime 用 Master-Slave,JuiceFSRuntime 用 Worker P2P,都在 Runtime CRD 里配置;
- CSI Plugin:存储客户端以容器化方式独立运行,与业务容器解耦,升级 CSI 不影响业务,同集群可并存多版本客户端,且能为客户端单独设资源配额。
自动化数据操作(Data Operations):通过 CRD 提供数据预取(DataLoad)、数据迁移(DataMigration,支持先导入再用或边用边导)、弹性扩缩、缓存清理、元数据备份恢复;触发方式支持一次性、定时、事件驱动,便于接进自动化运维体系。
四、可观测性:命中率决定要不要扩容
Dataset 状态暴露给运维的关键字段包括 UFS Total Size(底层数据总量)、Cached(已缓存量)、Cache Capacity(缓存容量)、Hit Rate(命中率)、Age 等。下面是官方文档中 kubectl get dataset 的状态示例片段:

命中率与缓存占用是 Fluid 弹性决策的依据:命中率长期偏低说明缓存小了或预热没覆盖到,缓存长期占不满则可缩容。需要强调,这些是 Fluid 采集并展示的运行指标,不附带统一的”加速倍数”承诺。
五、口径与局限:官方没有说的部分
- Fluid 自身不实现缓存引擎:它是编排层,性能上限由背后的 Alluxio/JuiceFS/Jindo 等决定。同样的 Dataset,换 Runtime 引擎得到的吞吐、一致性语义差别很大,不能把某一个引擎的跑分当成 Fluid 的跑分。
- 加速效果来自论文与场景案例,非统一基准:项目配套有 ICDE 2022 会议版与 TPDS 2023 期刊版两篇学术论文,证明云原生深度学习训练下的数据集抽象与弹性缓存有效,但论文是特定集群、特定模型/数据规模的结论,官方 README 未提供面向公众的标准化压测数据。
- Serverless 与边缘靠 sidecar 兜底:FUSE sidecar 方案绕开了 CSI 限制,但 sidecar 模式带来额外资源开销与启动顺序约束,能力不等同于原生 CSI。
- 缓存一致性与淘汰需自己治理:pinning、预热策略、淘汰策略配置不当会造成缓存抖动或数据不一致;Fluid 提供机制,策略仍要团队自己定。
- 门槛不低:前置要求 Kubernetes >1.16 且支持 CSI、Helm 3;多 Runtime、CRD、调度插件、CSI/sidecar 组合带来明显的运维复杂度,周报点评也指出”理念前瞻但实施成本高,需要相当运维能力”。
- 它不是存储替代品:Fluid 不负责数据的持久化归宿,原始数据仍在 OSS/HDFS/S3,缓存只是加速层。
六、适用与不适用场景
适合:
- 云原生 AI 训练/大数据任务反复读取同一批远程样本,GPU 因等数据空转的团队;
- 已在 K8s 上、希望用声明式 CRD 统一管理多源数据集并做预热、亲和调度的平台团队;
- 需要在原生/边缘/Serverless 多形态间复用同一套数据加速抽象的组织;
- 愿意以 Alluxio/JuiceFS 为底座、让 Fluid 做编排治理的企业内部数据平台。
不适合:
- 数据只读一次、不重复访问的流水线(预热缓存无收益);
- 没有 K8s 运维能力、追求开箱即用的小团队;
- 需要强一致事务存储或把 Fluid 当持久数据库用的场景;
- 不允许部署 CSI 且 sidecar 资源预算不足的受限 Serverless 集群。
七、客观分析:优势与局限
优势:
- Dataset 成为 K8s 一等公民:CRD 化的数据抽象补齐了 K8s 只管存储挂载、不管数据使用的缺口;
- Runtime 插件化、引擎中立:Alluxio/JuiceFS/Jindo/GooseFS/Vineyard/Thin 并存,避免绑定单一缓存产品;
- 数据亲和调度 + 可观测命中率:把”数据在哪”反馈给调度器,是区别于单纯挂缓存盘的关键能力;
- CNCF 孵化、学术背书、社区活跃(千余名贡献者、双周社区会、Apache-2.0),长期维护有保障;
- 自动化操作 CRD(预热/迁移/扩缩/备份)便于接 GitOps 与自动化运维。
局限:
- 层级多、排障面广:控制面、CSI/sidecar、底层引擎、远端存储任何一环都可能成为瓶颈;
- 性能不独立可承诺,高度依赖所选 Runtime 引擎与调参;
- 生态以中文社区与云厂商引擎(Jindo/OSS)为强关联,海外纯 S3/通用场景的文档与案例相对少;
- 无标准公开基准,容量规划需要团队自行压测;
- 对一次性、低复用的数据,缓存收益覆盖不了其运维成本。
八、它意味着什么
Fluid 的定位是”云原生数据面的编排层”,而非又一个分布式文件系统。它把大数据/AI 场景里零散的缓存、预热、亲和调度动作收敛成声明式 API,方向与 AI 训练上云、存算分离的趋势一致,并已进入 CNCF 孵化。对已有 K8s 平台和重复训练负载的团队值得引入评估;但它是一个”放大平台团队能力”的组件,不是即插即用的加速器,落地前应先确认团队能驾驭底层缓存引擎与调度链路。