F3:把 Wasm 解码器塞进每个数据文件的下一代列存格式
阅读时间: 大约 7 分钟
F3:把 Wasm 解码器塞进每个数据文件的下一代列存格式
Parquet 统治列存数据格式已超过十年,但它是为上一代硬件和负载设计的。每次规范加新编码(如新的压缩/位打包方案),旧版本引擎就读不了新文件——整个数据湖生态被格式演进拖着走。F3(Future-proof File Format)是 2025 年 9 月发表在 Proc. ACM Management of Data(SIGMOD 系)上的新格式,作者阵容里有 Arrow/pandas 之父 Wes McKinney。它的思路非常激进:把解码器本身编译成 Wasm,直接嵌进每个数据文件里。本文基于其 GitHub 仓库做分析。
一、要解决的痛点
论文摘要(DOI 10.1145/3749163)把问题讲得很清楚:Parquet/ORC 这类开源列存格式让跨平台数据共享成为可能,但它们「十多年前为当时的硬件和负载设计」。后续规范虽有更新,并非所有部署都支持这些改动,而系统想绕过格式缺陷往往只能重写。
结果就是:你不能随便加新编码——加了,老引擎读不了;不加,新硬件的红利吃不到。格式演进被兼容性锁死。
二、核心想法:解码器随数据走
F3 的解法是把「数据」和「怎么解码数据」打包在一起:
- 每个自描述的 F3 文件同时包含:数据、元数据、以及解码这些数据的 Wasm 二进制;
- 嵌入解码器的存储开销极小(几 KB);
- 任何平台只要有 Wasm 运行时,就能解码,不需要预先装对应版本的原生库;
- 通过通用 API,开发者可以自定义编码方案(User-Defined-Encoding,UDE)——想加新编码?写个 Wasm 解码器塞进去就行,不必推动格式规范升级、也不必等全生态升级引擎。
换句话说,F3 把「格式规范版本」这个中心化的兼容问题,变成了「每个文件自带解码插件」的去中心化问题。文件格式第一次有了可插拔的解码引擎。
三、作者背书与实现现状
论文作者:Xinyu Zeng、Ruijun Meng、Martin Prammer、Wes McKinney、Jignesh M. Patel、Andrew Pavlo、Huanchen Zhang。Wes McKinney 是 pandas 作者、Arrow 核心贡献者,他的参与说明这不是实验室玩具,而是数据格式圈主流玩家在认真思考后 Parquet 时代的事。
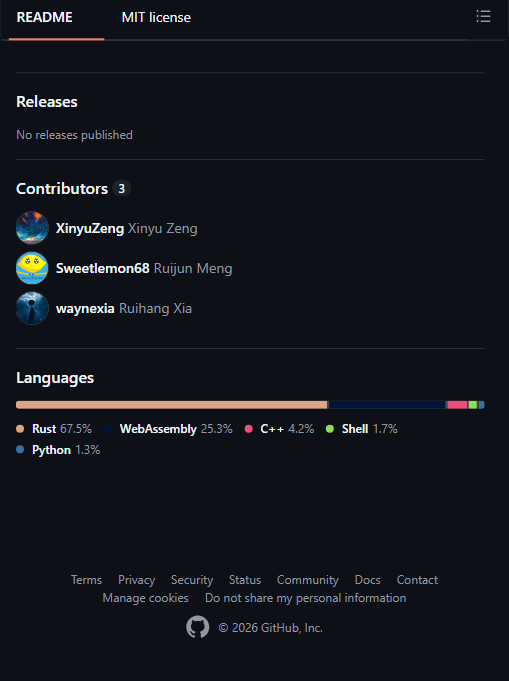
实现上,F3 用 Rust 编写(仓库语言占比 Rust 67.5%、WebAssembly 25.3%、C++ 4.2%),PoC 包为 fff-poc,格式定义用 FlatBuffers。
四、官方自己标注的边界:这是研究原型
读 F3 最重要的一句,是 README 开头那条警告:
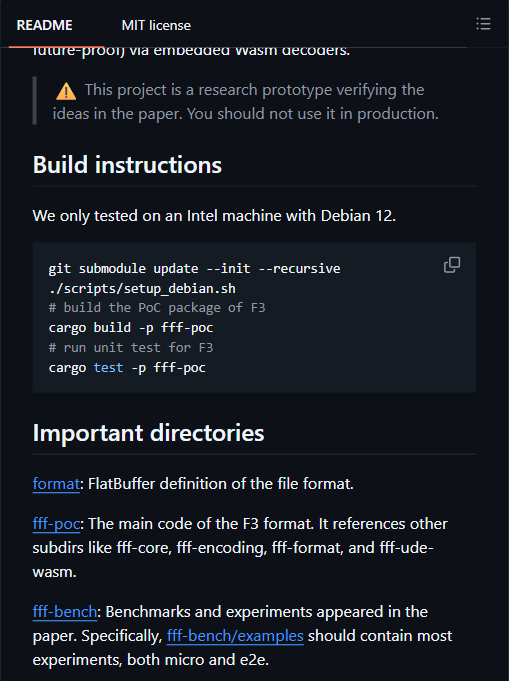
⚠️ This project is a research prototype verifying the ideas in the paper. You should not use it in production.
具体边界:
明确不要上生产。这是验证论文想法的 PoC,不是可用的存储格式。
测试环境极窄:官方「only tested on an Intel machine with Debian 12」——ARM、macOS、其他发行版都没保证。
无正式 release:仓库显示 No releases published,3 位贡献者。论文里的基准(fff-bench/examples 里的 micro 与 e2e 实验)需要按
doc/paper_reproduction.md自己复现,不是开箱即用的库。Wasm 运行时开销是已知代价。Koala 点评点到了:把解码器塞进文件意味着每个文件都要起 Wasm 实例解码,这比原生编译的解码慢——F3 论文用实验证明了这种代价在可接受范围,但那是论文环境的结论,不是生产 SLA。
五、必须区分「论文结论」与「工程现实」
- 论文层面:F3 展示了存储布局的改进与 Wasm 驱动解码的收益(与 legacy 及 SOTA 开源格式对比),思路成立、有顶会背书。
- 工程层面:没有 release、只在 Intel/Debian 验证、生态为零——今天你无法把 Parquet 数仓迁到 F3。它是一个方向宣言,不是一个可采用的格式。
六、适用与不适用场景
适合(今天): 研究列存格式、关注 Parquet 后演进方向的人;想评估「Wasm 内嵌解码」是否会成为下一代格式标配的团队;SIGMOD 论文读者与数据引擎开发者。
不适合(今天): 任何生产数据湖;想立刻替换 Parquet 的项目;需要成熟工具链(Spark/DuckDB/Arrow 读写器)的用户。
七、客观分析:优势与意义
优势: 用 Wasm 把解码逻辑随数据分发,从根上化解了「格式规范升级 vs 旧引擎兼容」的死结;自定义编码 API 让格式可演进;存储开销仅几 KB;Wes McKinney 等 Arrow 核心人物背书,方向含金量高。
局限: 纯研究原型、无 release、测试面窄;Wasm 解码有运行时开销;生态为零,离生产十万八千里。
F3 的价值不在于「现在用它」,而在于它提出了一个值得整个数据存储界认真对待的问题:当硬件和负载十年一变,一个文件格式是不是应该自己带着解码器走? 如果这个方向成立,十年后的列存文件可能都不再依赖「你装了哪个版本的 Parquet 库」。现在,它是一个写在 SIGMOD 论文里、跑在 Rust PoC 里的构想——值得长期关注,但别现在就把数据存进去。