exa-code:为编程 Agent 准备的代码搜索引擎与幻觉抑制工具
阅读时间: 大约 8 分钟
exa-code:为编程 Agent 准备的代码搜索引擎与幻觉抑制工具
2025 年 9 月 25 日,语义搜索公司 Exa 发布了 exa-code,定位为”第一个为编程 Agent 打造的 web-scale 上下文工具”。它不返回长篇文档,而是根据一条查询从全网中抽取”恰好几百个 token”的代码示例喂给编码 Agent,目标是在减少幻觉的同时把上下文占用压到最低。本文基于 Exa 官方博客与自测评测,梳理它的检索机制、评测方法与官方口径中的保留之处。
一、背景:编码 Agent 的知识瓶颈
2025 年的大模型仍然记不住数百万个库、API 与 SDK 的精确签名。当 Claude Code、Codex 这类编码 Agent 需要调用 Boto3、Slack API、某个 Nix flake 配置或一个冷门 SDK 时,靠模型记忆直接写参数,最常见的失败方式就是编造一个不存在的函数名或参数——官方称之为 code hallucination(代码幻觉)。
传统 RAG 把整页文档塞进上下文,文档动辄数千 token,既挤占窗口又稀释相关性。Exa 的判断是:给编码 Agent 的网页上下文必须”极其相关、极其稠密”,而代码示例是效率最高的载体——一段可运行的片段比一整段英文 API 描述信息密度高得多。
二、工作机制:三步检索
官方披露的流水线分为三步:
- 混合检索(hybrid search):在超过 10 亿个网页(1B+ webpages)上按查询找到最相关的页面;
- 代码示例抽取与重排:从页面中抽出代码示例,用一个集成方法(ensemble method)做相关性重排,明确以”召回率与质量最大化为目标”;
- 按需返回:代码示例足以回答查询时,返回一段通常只有几百 token 的拼接字符串;代码不够时,才回退返回完整文档页面(例如某些 API 文档用英文而非代码描述接口)。
exa-code 内置一个专门的代码示例索引,来源同时包括 GitHub 与 Exa 自身的网页索引,并配合代码专用的检索模型——这是它与通用网页搜索(如 Brave)或文档专用工具(如 Context7)最主要的差别。
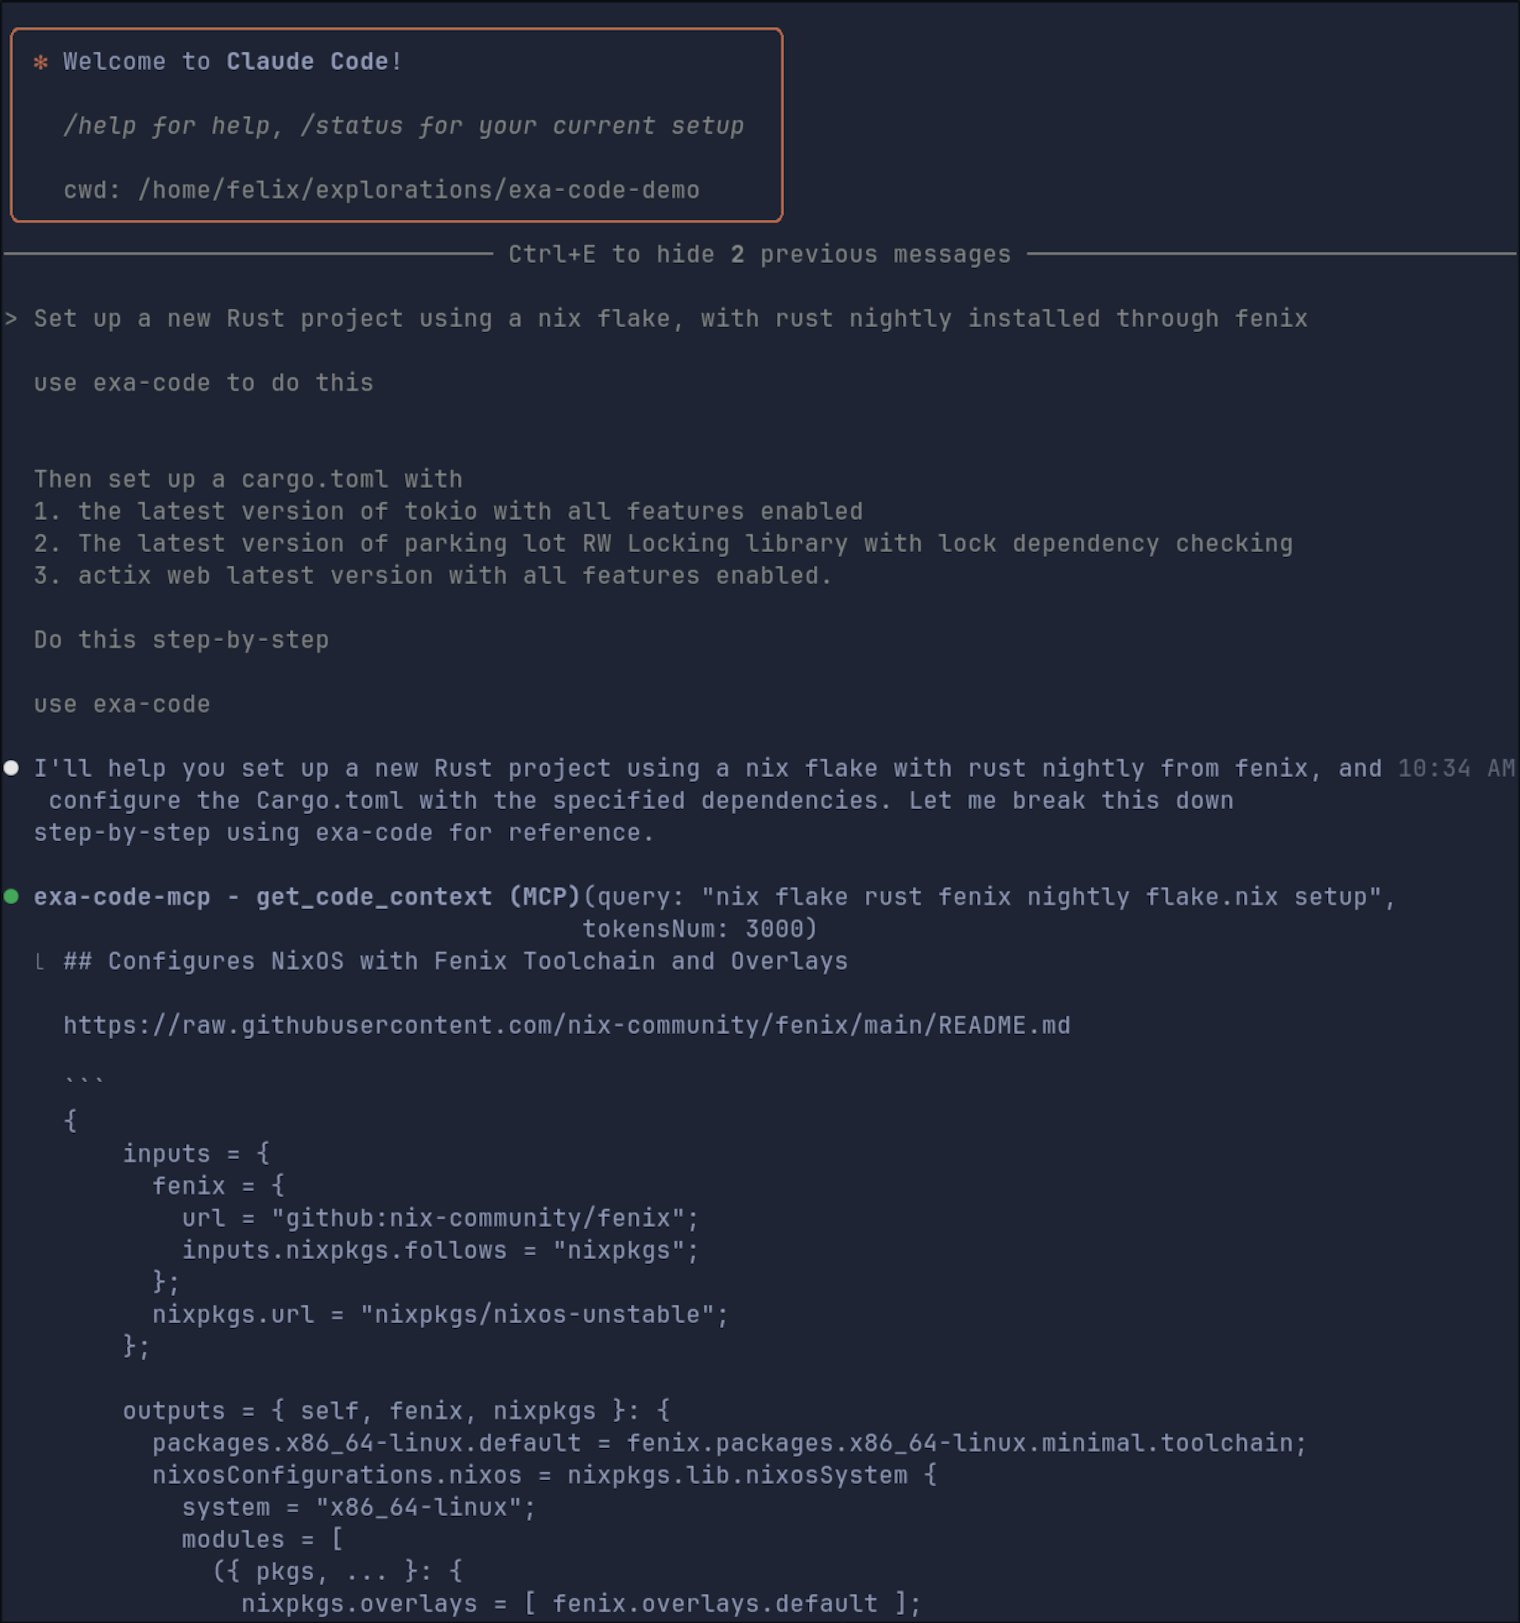
官方给出的示例是:让 Agent 用 nix flake 搭建带 fenix 的 Rust nightly 开发环境,exa-code 以不到 500 token 的篇幅返回了可用的 flake 配置。官方列出的典型使用场景包括:更新应用配置、调用 Exa/Slack 这类 API 端点、使用 Boto3(AWS)或 AI-SDK 等 SDK。工具以 MCP 形式在 Smithery 上公开提供,在 prompt 里写入”use exa-code”即可触发。
三、自测评测:代码幻觉率
Exa 自建了一套评测来证明效果。任务由文档生成:要求测试模型写出调用某个库/SDK 函数或 API 端点的代码,相关任务会附带依赖版本号;模型生成代码后,由一个 LLM 分类器对照原始文档判定是否出现幻觉(例如把 materialize(output_asset_uri) 错写成不存在的 asset_uris=[...])。“幻觉分”(Hallucination Score)就是某库测试用例被判定为幻觉的比例。
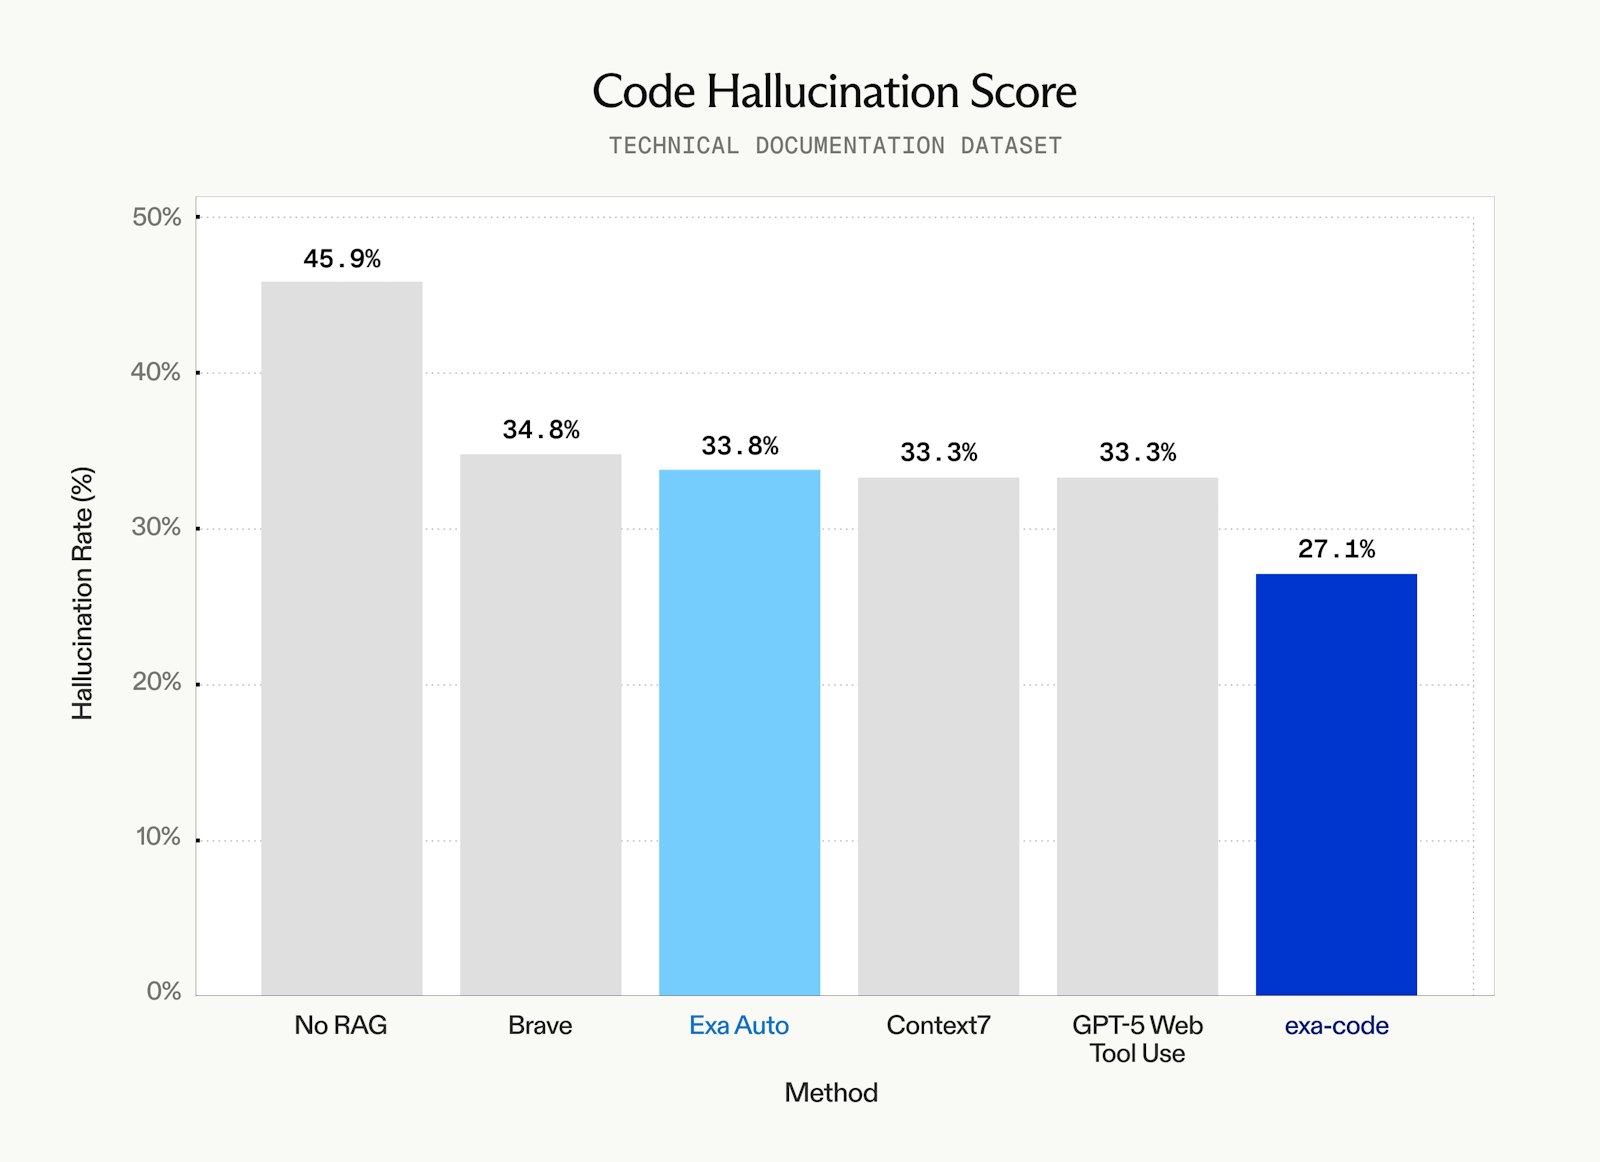
官方给出的技术文档数据集(Technical Documentation Dataset)平均幻觉率如下:
| 上下文方案 | 幻觉率(官方自测) |
|---|---|
| 无 RAG(No RAG) | 45.9% |
| Brave 搜索 | 34.8% |
| Exa Auto(通用自动检索) | 33.8% |
| Context7 | 33.3% |
| GPT-5 Web Tool Use | 33.3% |
| exa-code | 27.1% |
从无 RAG 的 45.9% 降到 27.1%,官方称 exa-code 消除的代码幻觉比列出的其他来源都多,且所需 token 更少。
四、评测方法本身的偏向
这组数字需要放在官方自测的口径下理解:
- 数据集由 Exa 自己构造:库与端点样本同时包含流行与冷门依赖,任务由文档反向生成,分类器也是 LLM 而非人工标注,存在”出题人自己阅卷”的空间;
- 对比项的配置不可完全复现:Brave、Context7、GPT-5 Web Tool Use 在评测中的调用参数、返回长度未公开,横向差值(33.8% 对 33.3%)在噪声范围内不构成显著优劣;
- 27.1% 不等于”基本不幻觉”:即使使用 exa-code,官方口径下仍有约四分之一的测试用例被判定为幻觉,它是一个降低率工具,而非消除工具;
- “几百 token”是定性描述:官方未给出返回长度的 P50/P95 分布,token 节省幅度需自行实测。
五、优势与局限
优势:
- 代码优先的检索取向:专门索引与重排代码示例,对”照抄签名”型任务命中率高;
- 上下文经济:几百 token 的返回体量对长会话 Agent 的窗口友好;
- MCP 即插即用:在 Smithery 公开,prompt 里一句话即可接入,不绑定特定编码 Agent;
- 覆盖 GitHub + 网页双索引:比只抓官方文档站的工具覆盖面广。
局限:
- 评测为官方自测:第三方独立基准缺失,27.1% 这一数字不能直接外推到生产环境;
- 只解决”查得到”,不解决”用得对”:返回正确签名后,Agent 仍可能拼错调用顺序或选错参数;
- 闭源商业服务:索引与重排模型不开放,成本与限流需以官方控制台为准;
- 对非代码知识帮助有限:概念解释、架构选型这类纯文字问题不是它的优化目标。
六、适合谁用
- 维护大量冷门 SDK、内部 API 的编码 Agent 团队;
- 长会话中上下文预算紧张、希望用最小片段 grounding 的开发者;
- 已经在用 MCP 生态、想给编码 Agent 补一个代码检索工具的用户。
需要强调的是,exa-code 更适合作为 Agent 工具链里的”签名查询层”,与代码执行、测试验证配合使用,而不是单独作为正确性保证。