Easy Dataset:把领域文档变成微调数据集的可视化流水线
阅读时间: 大约 12 分钟
Easy Dataset:把领域文档变成微调数据集的可视化流水线
做垂直领域大模型微调,最贵的环节往往不是训练,而是数据:公开语料覆盖不到公司内部文档,人工逐条写问答对成本高、一致性差,而纯脚本拼接的合成数据又常常事实漂移。开源项目 Easy Dataset(作者 ConardLi,GitHub ConardLi/easy-dataset)瞄准的正是这一段——给非算法背景的使用者一个浏览器界面,把 PDF、Markdown、DOCX、TXT、EPUB 等领域文档一路转成可直接喂给微调框架的结构化数据集。本文基于仓库 README、arXiv 预印本《Easy Dataset: A Unified and Extensible Framework for Synthesizing LLM Fine-Tuning Data from Unstructured Documents》(2507.04009,2025-07-05 提交)以及官方实验表格做一次客观拆解。
一、背景:为什么微调数据集难做
大模型通用能力已经很强,但换到一个具体领域(财税、医疗、法律咨询、企业内部规章)时,公开训练语料里要么没有、要么过时。团队通常面临三条路:买商用数据集(贵且不贴合)、人工标注(慢、贵、难规模化)、用 LLM 合成(快但质量参差、容易幻觉)。已有合成工具(论文对照的 Distilabel、Curator、Data-Juicer、GraphGen 等)要么是代码驱动、上手门槛高,要么只覆盖流水线的某一段,缺少一个”上传文档就能走完全程”的图形界面。Easy Dataset 的定位就是把这条链路 GUI 化,并在中间每一步留出人工审核位(human-in-the-loop)。
二、它是什么
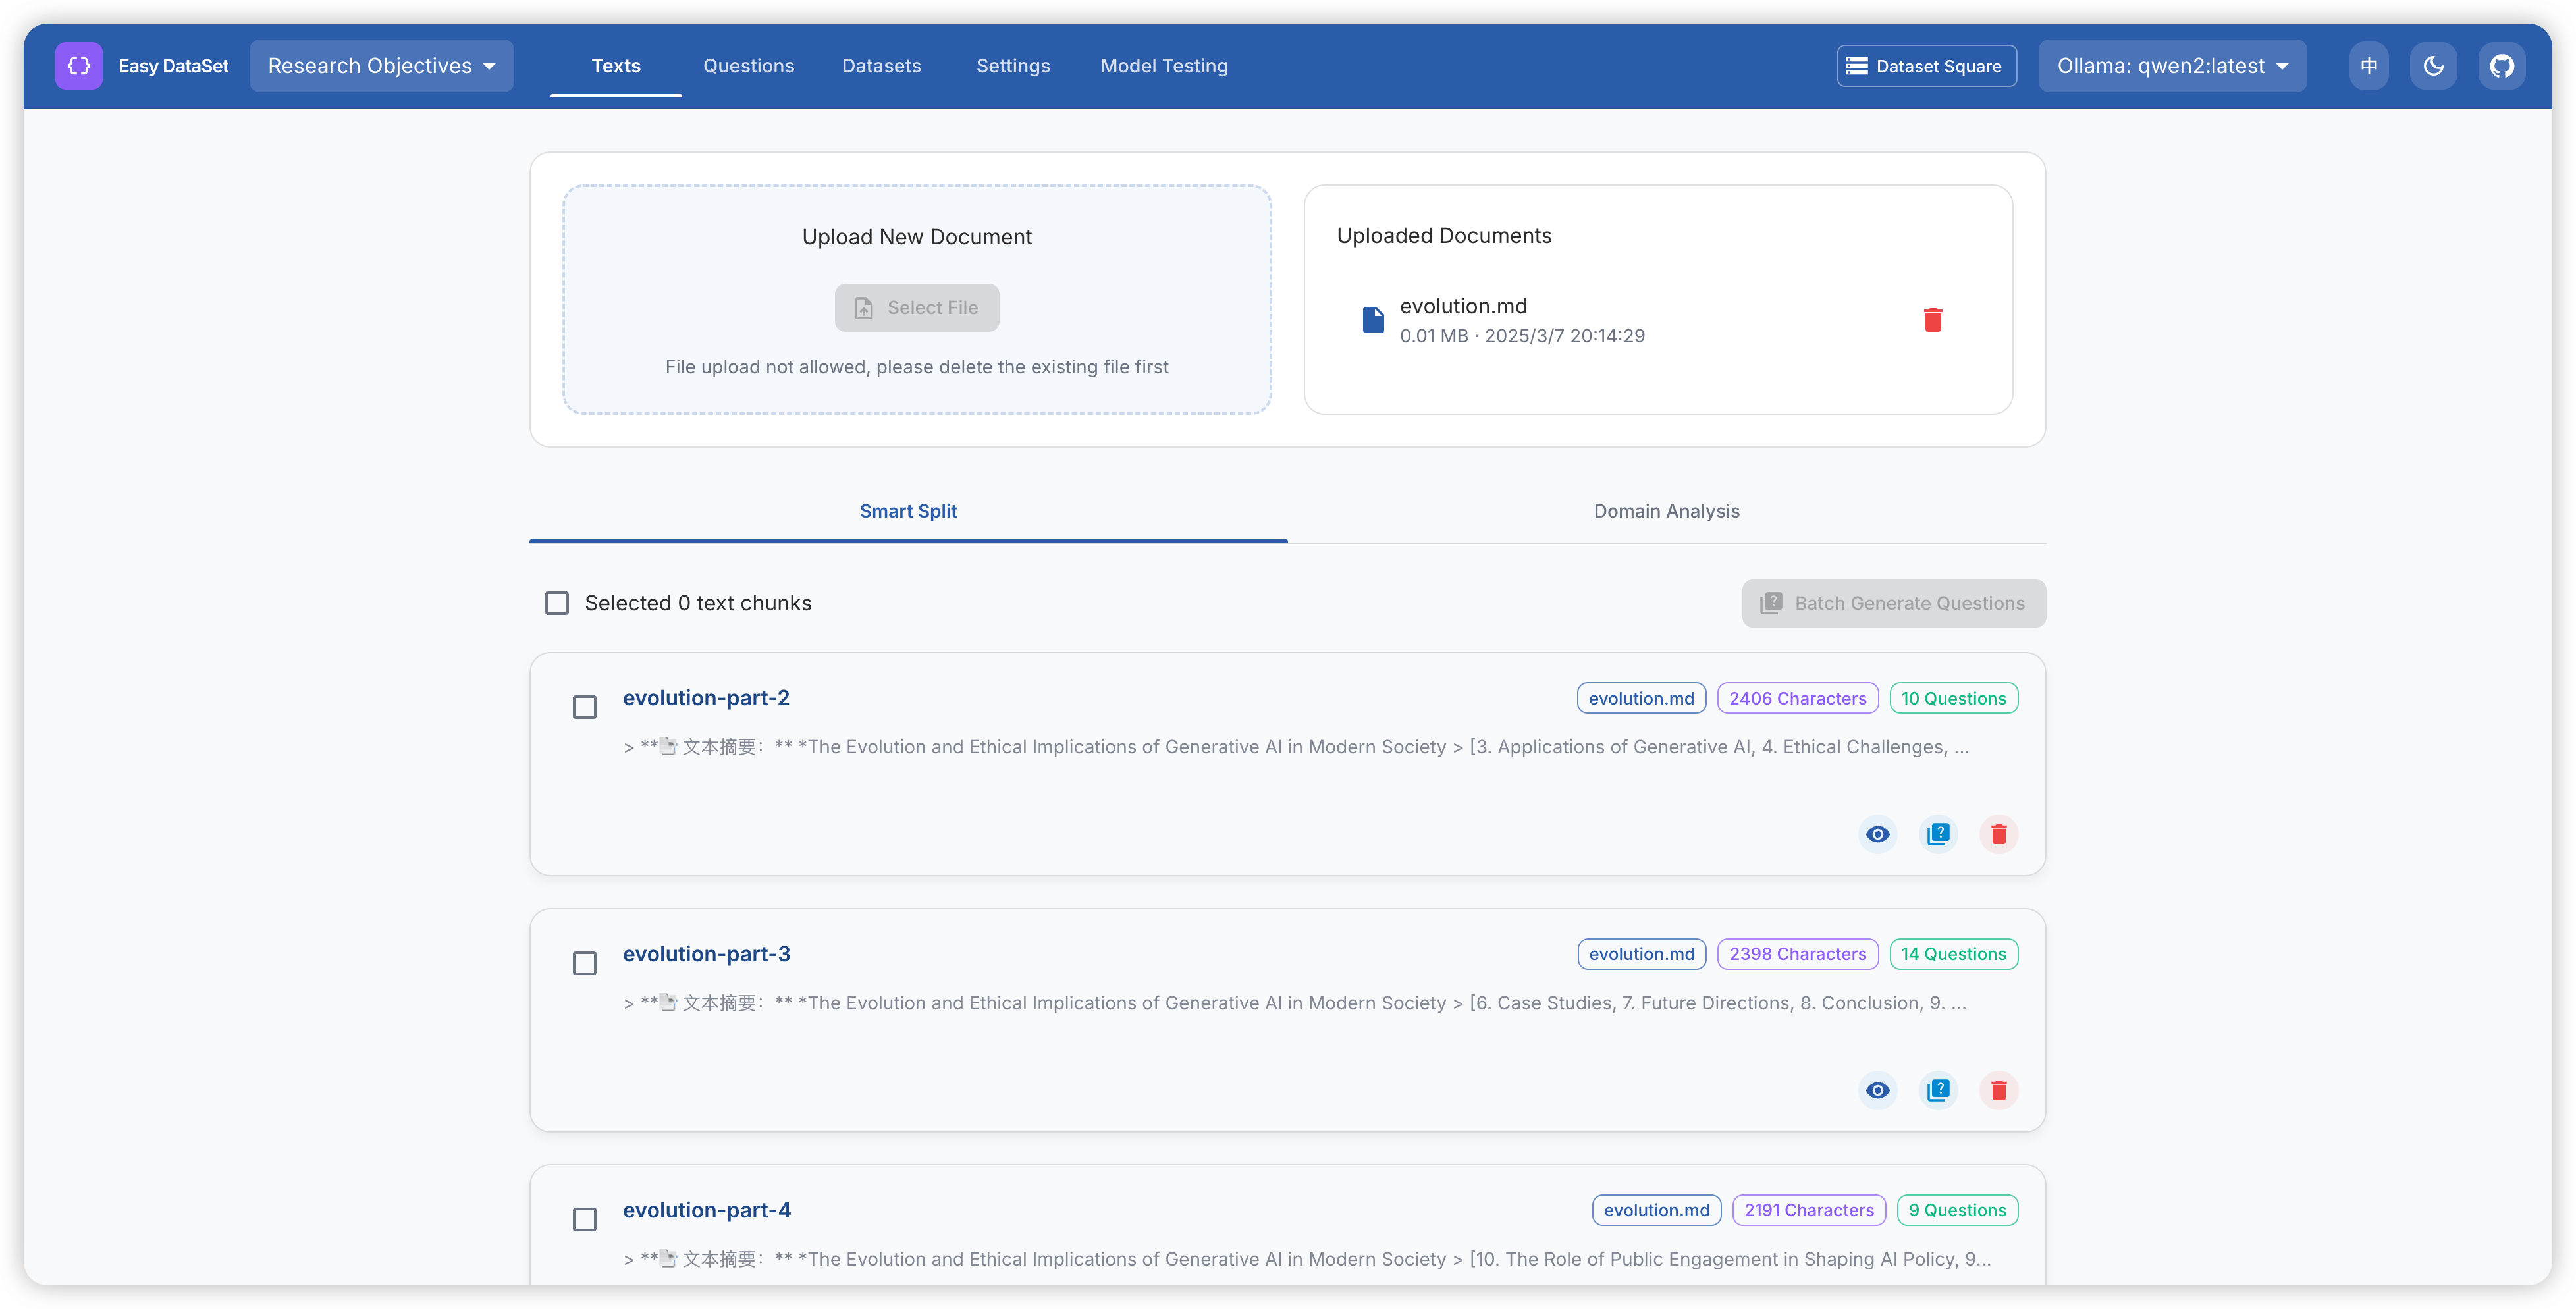
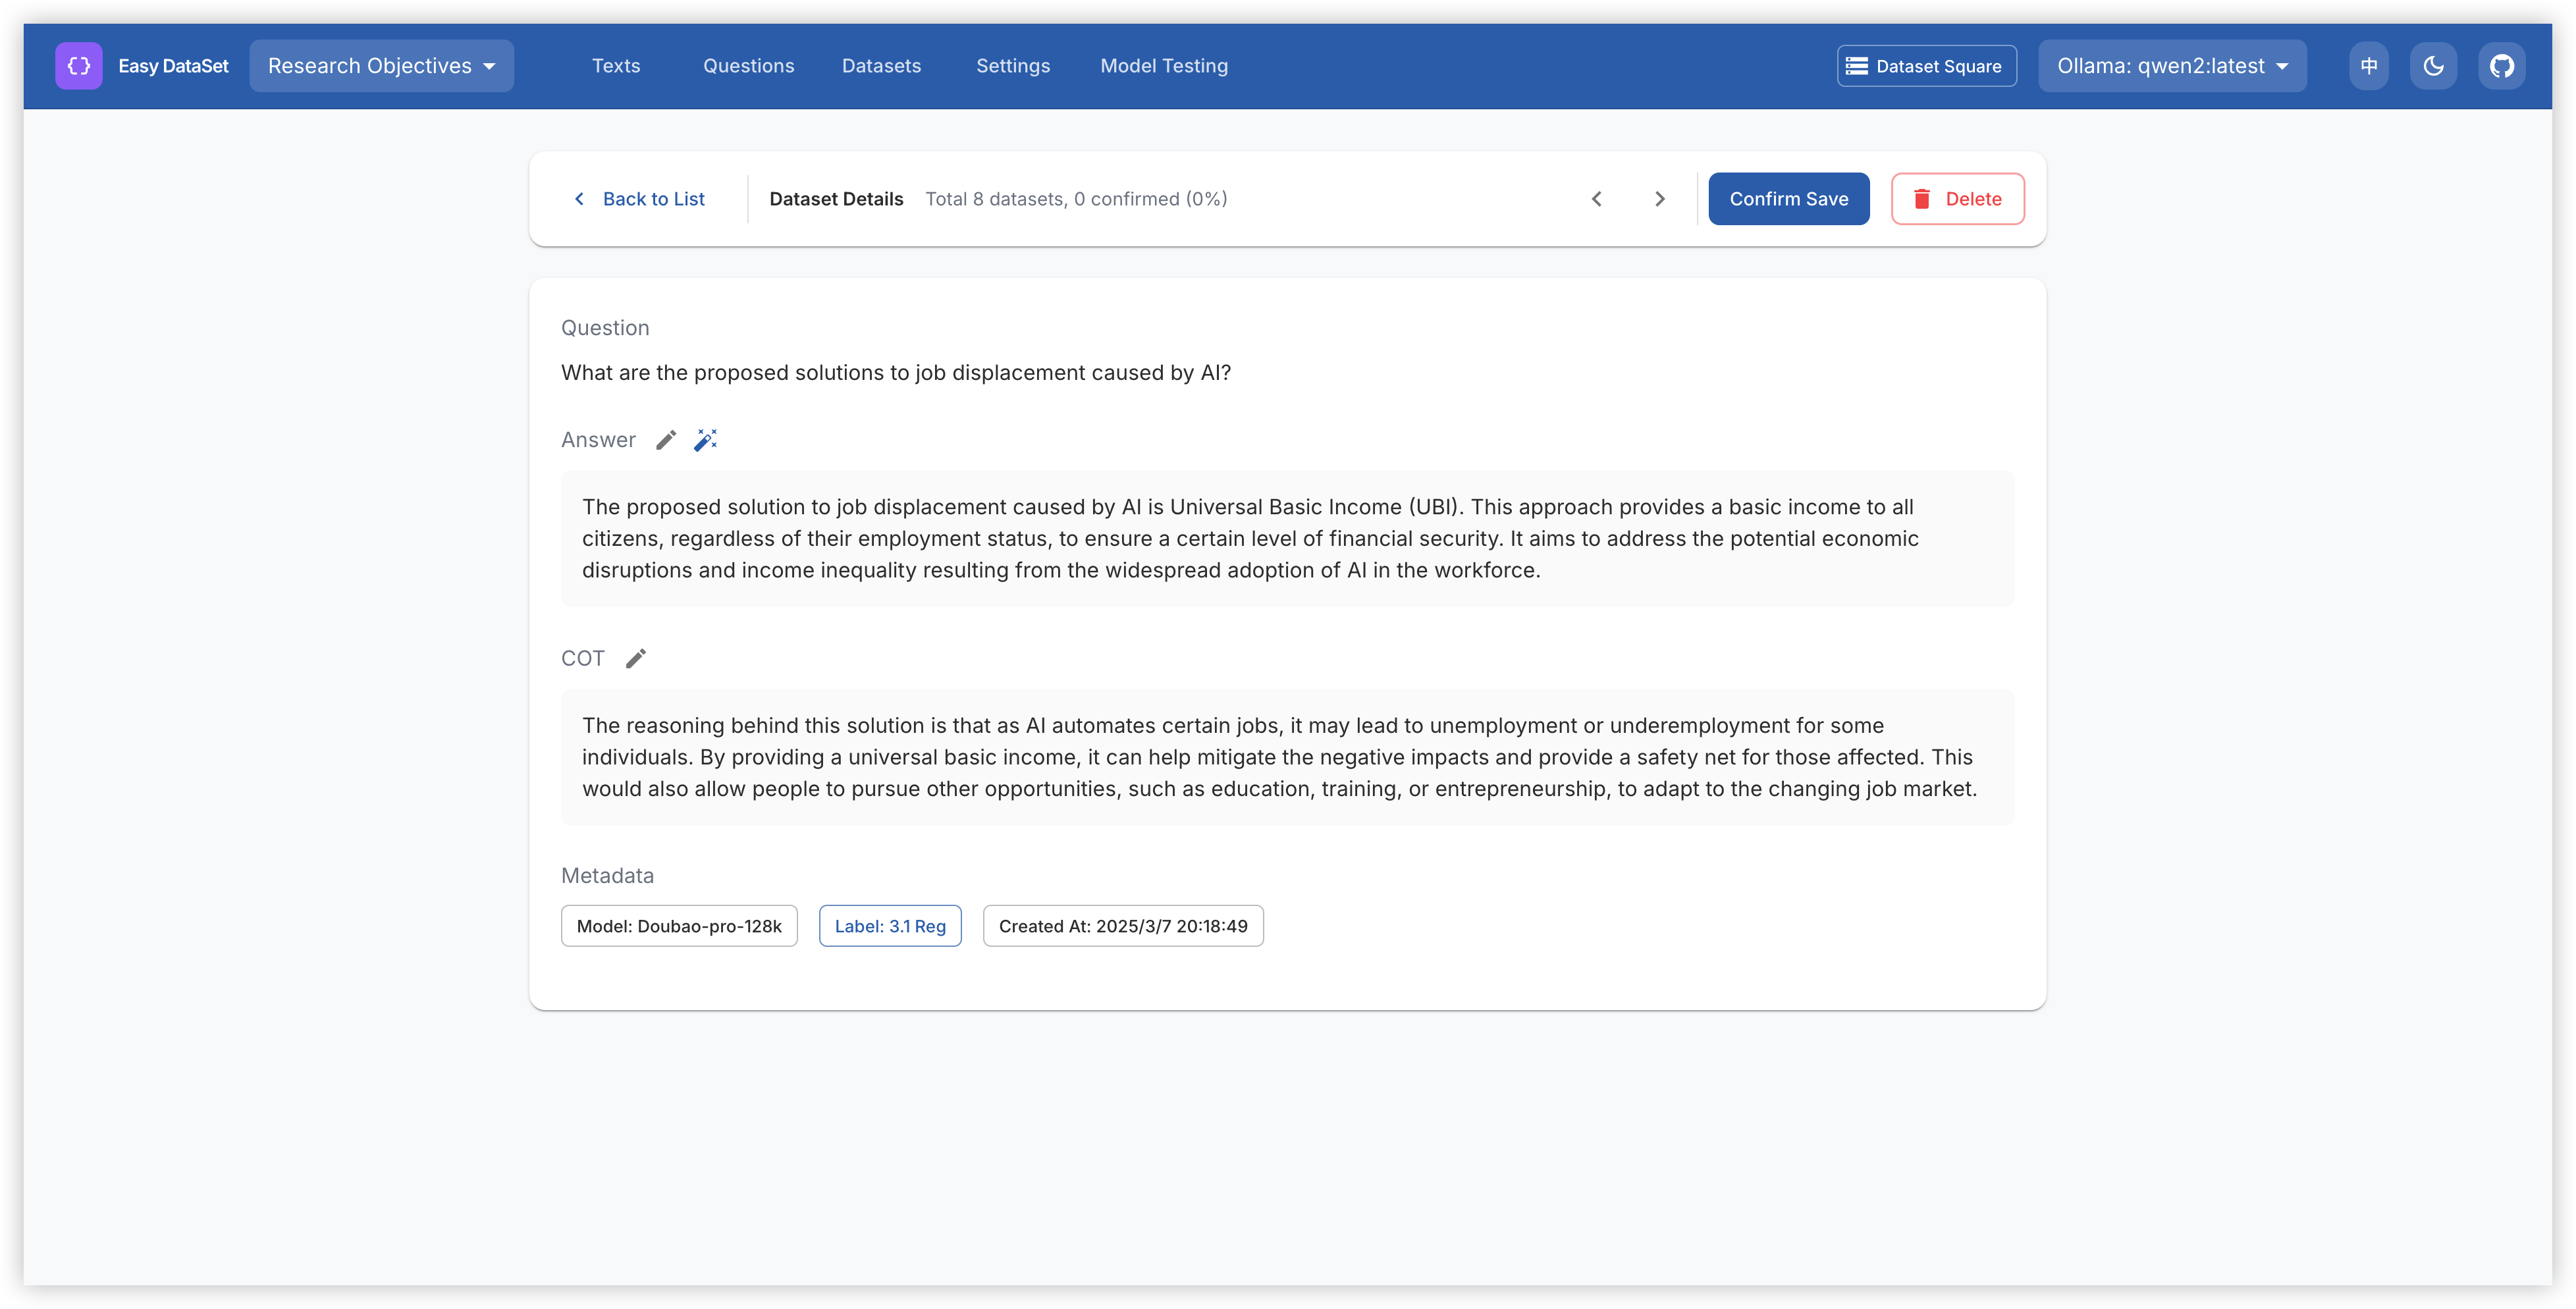
Easy Dataset 是一个自托管(或桌面端)的数据集制作应用,主流程为:上传领域文档 → 解析抽取文本 → 智能分块 → 构建领域标签树 → 生成问题 → 调用 LLM 生成答案与思维链(COT)→ 人工审核编辑 → 导出微调格式。它本身不训练模型,而是”造数据”,产出可用于 SFT 微调、RAG 知识库与模型评测三类场景。仓库创建于 2025-03-04;截至本文调研时(2026-10-17),GitHub API 显示约 15,000 stars、1,575 forks,采用 AGPL-3.0 许可。
三、技术机制:自适应解析 + 人设驱动合成
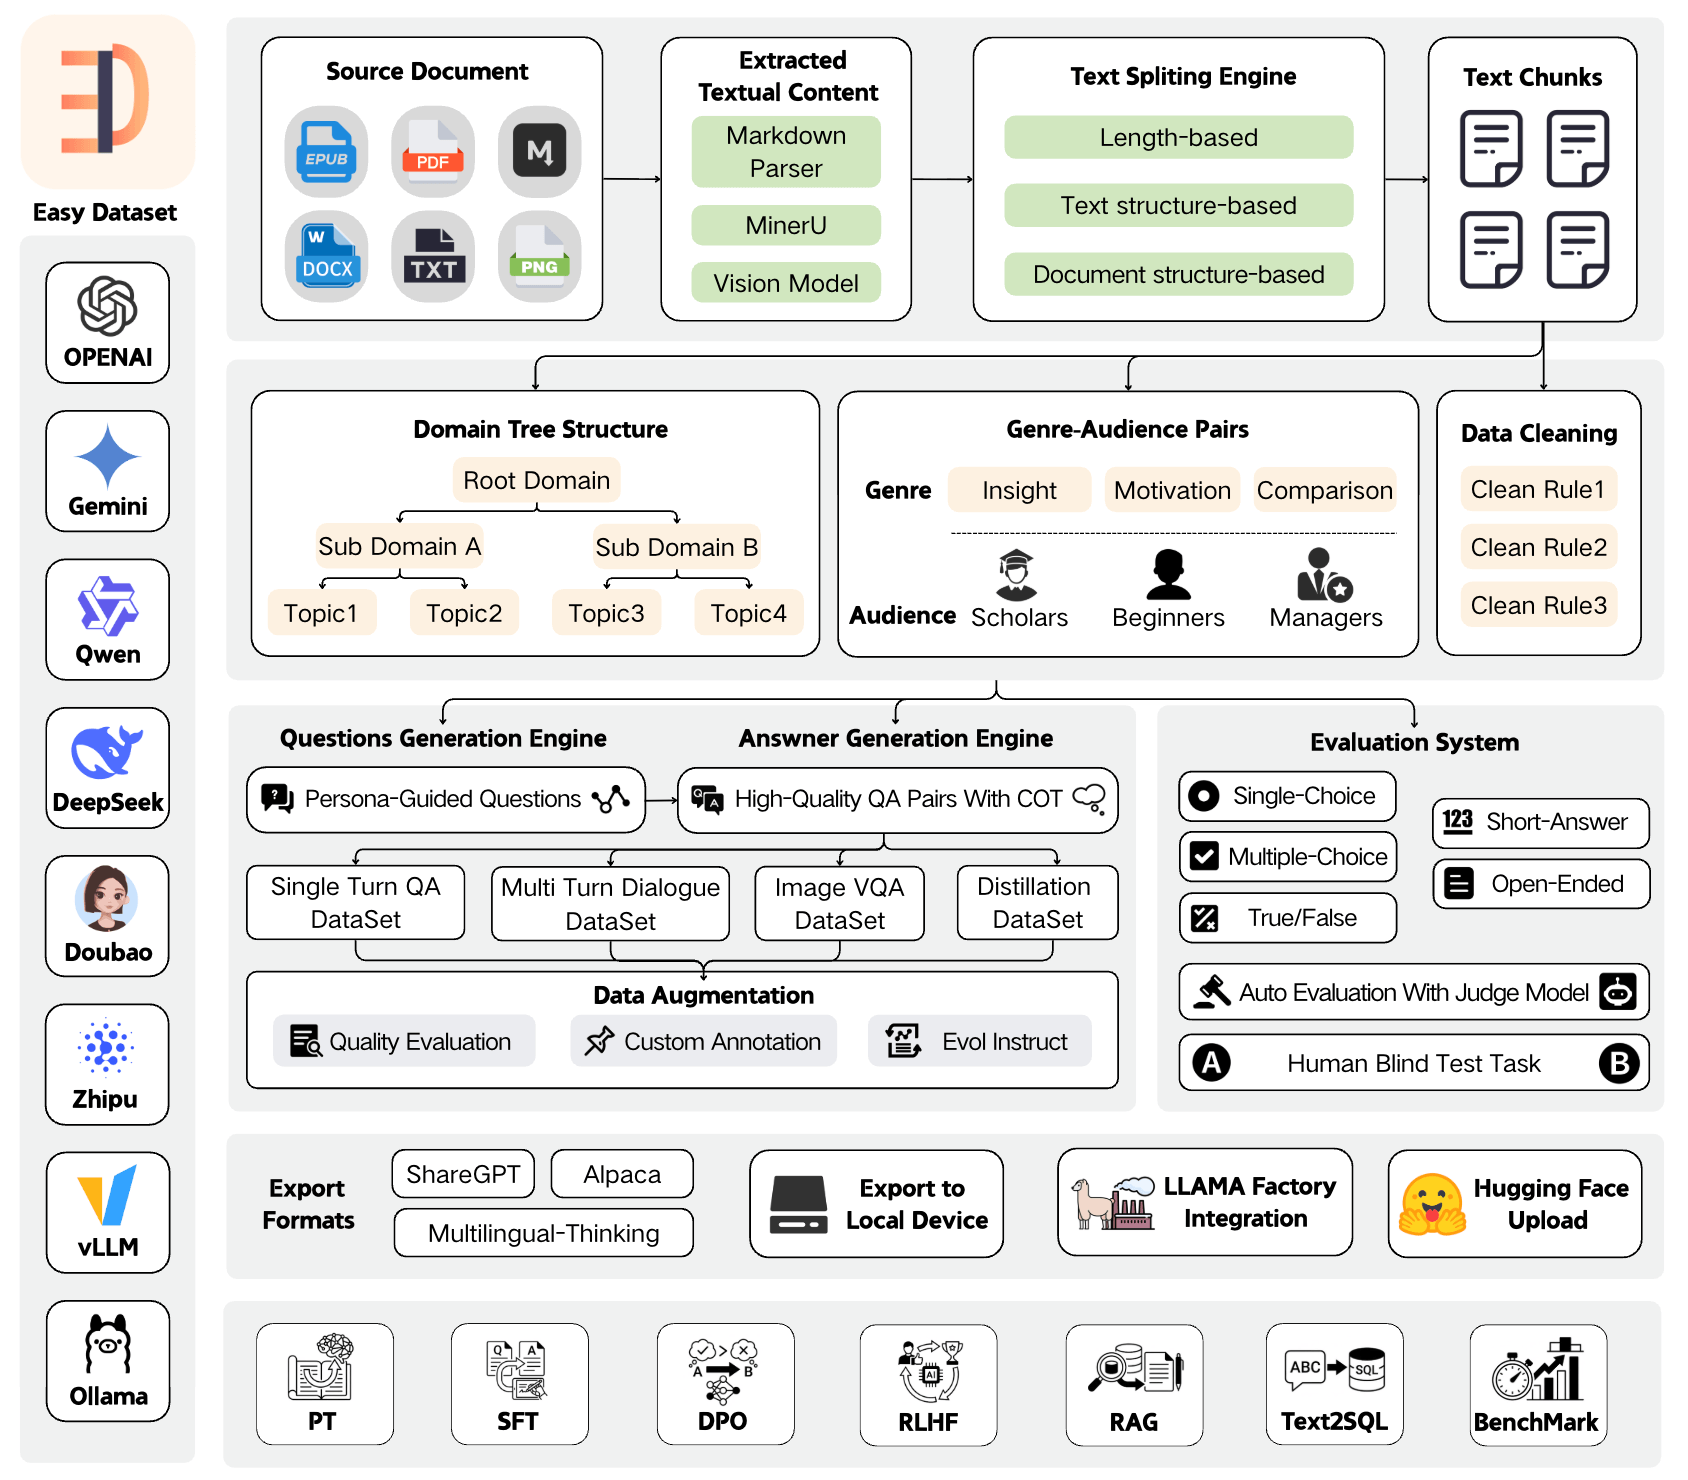
官方架构图(首图)把流水线分成几层:
- 文档解析层:源文档支持 EPUB、PDF、DOCX、TXT、PNG(图片)等,抽取通道包括 Markdown Parser、MinerU(文档解析)与视觉模型(Vision Model);
- 分块引擎:提供按长度(Length-based)、按文本结构(Text structure-based)、按文档结构(Document structure-based)三种混合分块策略,界面上可可视化勾选与调整;
- 知识组织:基于目录自动构建全局领域标签树(Domain Tree Structure),并以”文体—受众”(Genre-Audience, GA)组合驱动生成;
- 问题与答案引擎:Persona-Guided Questions 生成后,再产出带 COT 的高质量问答对,下游可落地为单轮 QA、多轮对话、图片 VQA、数据蒸馏四类数据集;
- 评估子系统(1.7.0 新增):生成判断/单选/多选/简答/开放题测试集,用 Judge Model 自动评分,另有人工双盲对比(Arena);
- 导出:支持 ShareGPT、Alpaca、Multilingual-Thinking 格式,JSON/JSONL,可一键生成 LLaMA Factory 配置、直传 Hugging Face Hub。
论文方法上最有辨识度的是 Persona-Driven(人设驱动)合成:先让 LLM 根据文档内容自动生成一组 (Genre, Audience) 配对(例如”金融新闻摘要 × 忙碌高管”、“税务政策深谈 × 税务专业人士”),再由每个”人设”从不同视角对同一文本块发问。论文还提到一个工程细节:随机丢弃问号(stochastic punctuation dropout),避免微调模型过度依赖标点 cue。答案生成采用知识增强提示,把问题与来源文本块一起喂给 LLM 以保证忠于原文;使用带 COT 的推理模型(论文示例 DeepSeek-R1)时,中间推理步骤也一并保留进 QA 对。
四、官方实验数据(论文 Table 3)
论文在金融问答域做了验证:收集 5 份晚于模型知识截止的最新财报,构建 100 题领域评测集,合成 10,000 条训练样本,用 LLaMA Factory 微调 Qwen2.5-7B-Instruct(2×A800 80GB、batch size 64、2 epochs、学习率 1e-5、cosine 调度、warmup 0.1)。领域题由 DeepSeek-V3 以 LLM-as-judge 打分:
| 方法 | MMLU | CMMLU | HellaSwag | MATH | HumanEval | 通用均分 | 领域知识 |
|---|---|---|---|---|---|---|---|
| Base 模型 | 62.0 | 77.2 | 82.9 | 74.8 | 84.8 | 76.3 | 3.2 |
| 朴素合成(Naive) | 60.2 | 78.4 | 80.8 | 72.9 | 80.5 | 74.6 | 57.0 |
| 人设驱动合成 | 63.7 | 77.7 | 80.8 | 74.1 | 81.1 | 75.5 | 59.6 |
(数字均出自论文 Table 3;通用均分为五项基准平均,领域知识分为 DeepSeek-V3 作为 judge 的百分制评分。)
可以看到:领域分从 Base 的 3.2 分别提升到 57.0(朴素)与 59.6(人设),而通用基准大体维持;人设驱动在 MMLU 上反而略高于 Base(63.7 vs 62.0)。
五、评测方法的偏向与口径
这组结果需要按口径打折理解:
- 单域单模型:实验只做了金融域一个领域、一个 7B 模型,论文是预印本(preprint),未经过同行评审;
- 领域集只有 100 题,且由 LLM-as-judge(DeepSeek-V3)打分,judge 自身的偏好会直接进入分数;
- 朴素合成的通用均分 74.6 略低于 Base 的 76.3,说明”完全不掉通用能力”并非无条件成立;
- 论文样本量 10,000 条、2 epochs 是作者自己的设定,换模型、换数据量结论可能变化。
六、适用与不适用场景
适合:需要快速把内部文档/行业资料转成 SFT 或 RAG 语料的中小团队;不想写脚本、希望可视化逐条审核的非算法人员;已有 Ollama 本地模型、希望离线合成的场景。兼容所有 OpenAI 格式 API(OpenAI、MiniMax、智谱、阿里百炼、OpenRouter 等),也支持 Gemini、Claude 做视觉解析。
不适合:要求严格合规、不能把文档外发 LLM API 的机构(除非全程接本地模型);需要高质量数学/代码指令精调的场景(合成数据仍需人工把关);商用闭源分发场景(见许可节)。
七、优势与局限
优势:
- 端到端 GUI,零代码走完”文档→数据集”,并在每个环节留人工审核口;
- 人设驱动 + GA 组合提升同一文档的覆盖视角多样性;
- 导出格式主流(Alpaca/ShareGPT),与 LLaMA Factory、Hugging Face 衔接顺滑;
- 提供本地 Docker(
ghcr.io/conardli/easy-dataset,端口 1717)与 Win/macOS/Linux 桌面端,部署轻。
局限/口径:
- AGPL-3.0 许可:这是最需要决策者注意的一点——AGPL 要求网络提供服务也必须开源衍生作品,商业闭源 SaaS 集成前必须单独评估或取得商业授权;
- 合成数据质量取决于底层调用的模型:换弱模型,生成的问题与答案质量同步下降,多样性也受模型上限约束;
- 人工审核不可省略:自动化只负责”批量生成初稿”,论文自己也强调 human-in-the-loop 用于修正幻觉与噪声;
- 实验证据单薄(单域、单模型、100 题、judge 打分),不宜把 59.6 这类数字当作普适承诺;
- 项目仍在快速迭代(README 已到 1.7.0 评估版),界面与 API 可能变动。
八、它意味着什么
Easy Dataset 代表了”垂直微调平民化”的一个方向:把过去需要算法工程师写 pipeline 的合成工作压缩成一个可点选的界面,降低了团队进入领域微调的门槛。但它没有也不可能替代数据治理本身——工具负责规模化生产初稿,事实核查、去重、难度配比仍要人来兜底。对想试水垂直 SFT 的团队,它是一个值得本地跑一遍的起点,商用前先把 AGPL 条款谈清楚。