Colibrì:用 2400 行纯 C,在笔记本上跑起 744B MoE 大模型
阅读时间: 大约 9 分钟
Colibrì:用 2400 行纯 C,在笔记本上跑起 744B MoE 大模型
当大家都在拼谁的集群更大时,JustVugg 开源的 Colibrì(蜂鸟)走了一条相反的路:用纯 C 写的推理引擎,核心只有约 2400 行代码、零运行时依赖(不依赖 BLAS、运行时不需要 Python、不需要 GPU),却声称能在一台 25GB 内存的消费级设备上跑 GLM-5.2 这个 744B 参数的 MoE 模型。本文回到它的 GitHub README,看看这个”小引擎装大模型”的赌注到底是怎么成立的,以及它自己承认哪些地方还不行。
一、背景:MoE 的稀疏性是机会也是浪费
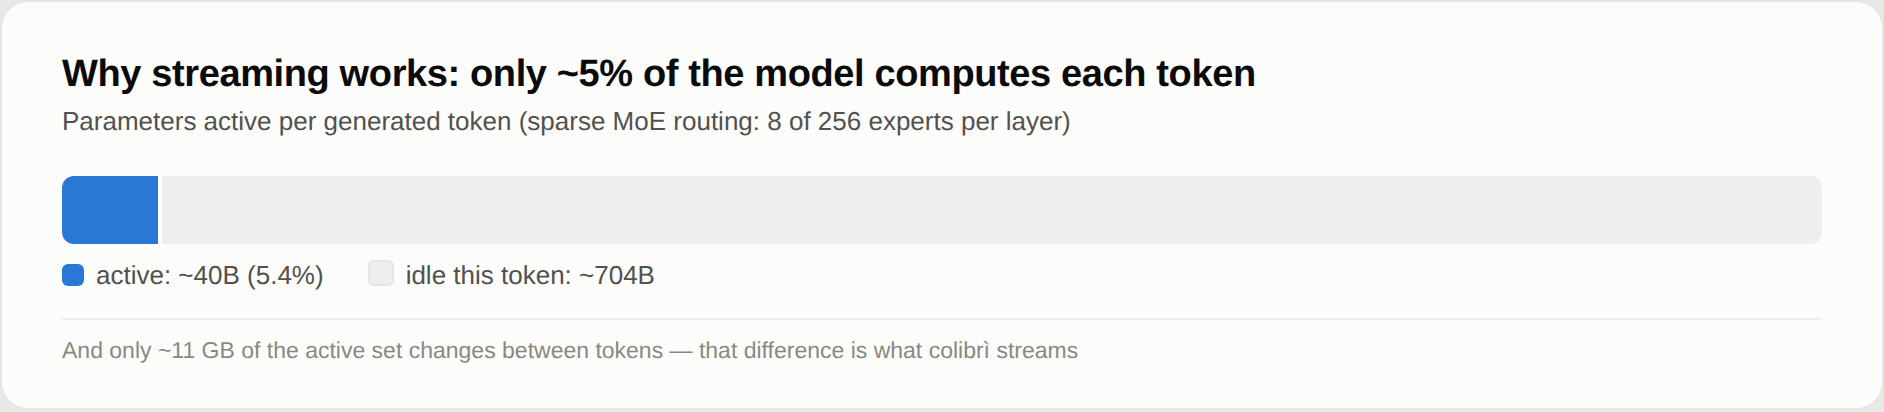
744B 听起来吓人,但 MoE(混合专家)模型的关键在于稀疏激活。官方图里写得很清楚:GLM-5.2 每个 token 只激活约 40B 参数(5.4%),即每层 256 个专家里只路由 8 个;而且相邻 token 之间,真正发生变化的激活集合只有约 11GB。
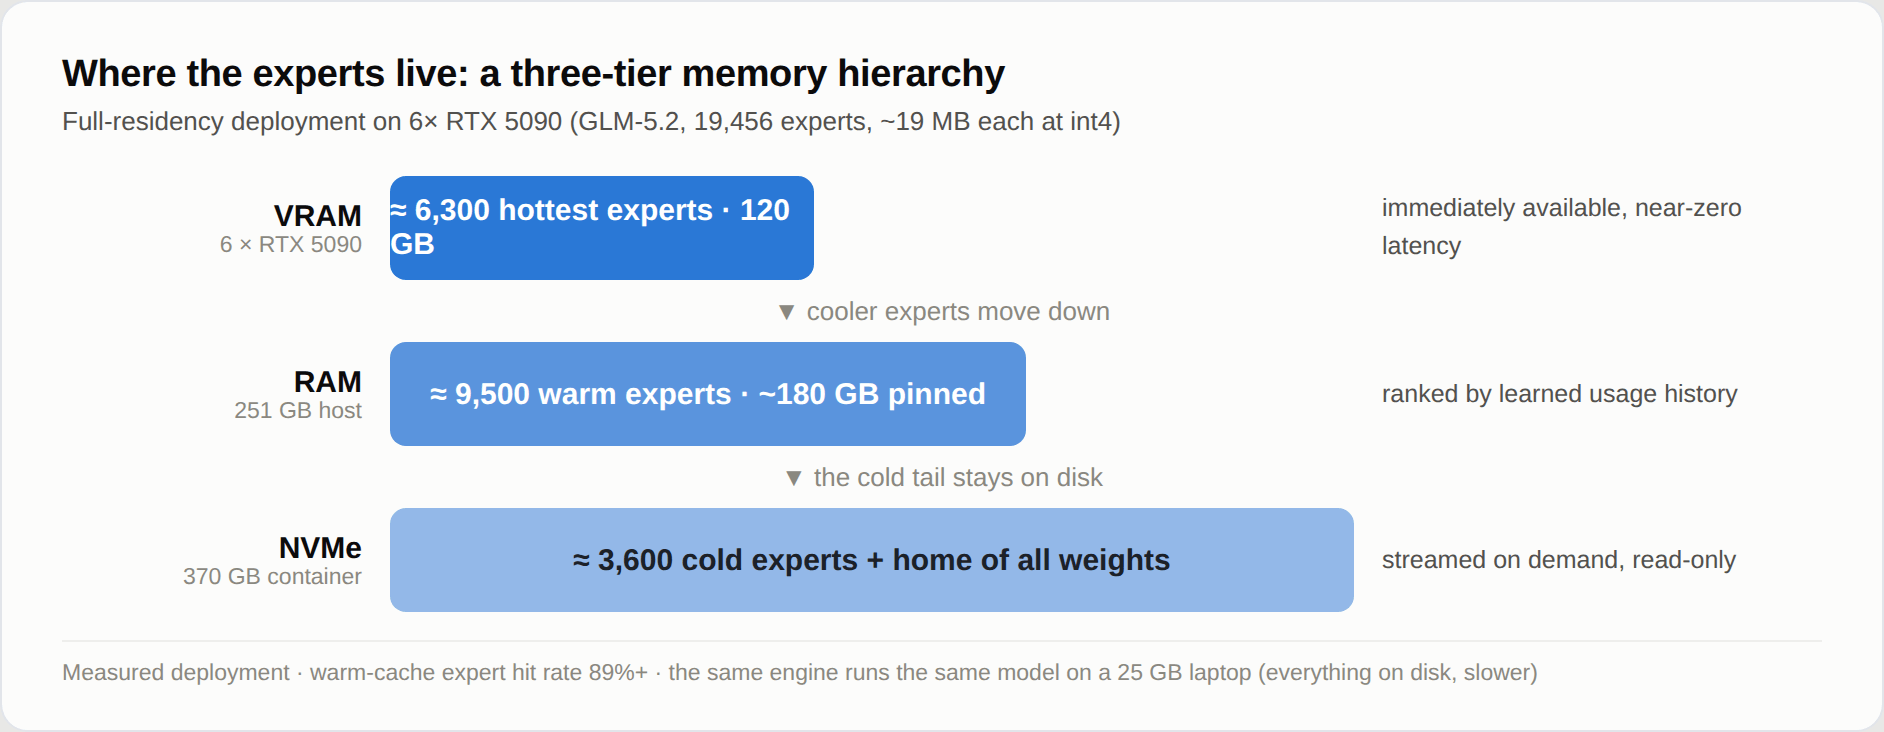
这就是 Colibrì 的立论基础:模型不需要整体塞进高速内存,它需要的是”分层摆放”。它把 VRAM、RAM、NVMe 当成同一个推理层级(官方叫 AI memory multitiering):
- 稠密部分(注意力、共享专家、embedding,约 17B 参数)以 int4 常驻内存,约占 9.9GB;
- 19,456 个路由专家(75 个 MoE 层 × 256,加 MTP 头,int4 下每个约 19MB)整体约 370GB,放在磁盘上按需流式加载。
在高配机器上,这个层级是分层填满的(见上图):6 张 RTX 5090 的 VRAM 放约 6,300 个最热专家(120GB)、主机 RAM 钉住约 9,500 个温专家(约 180GB)、NVMe 放约 3,600 个冷专家和全部权重的家。官方标注温缓存命中率 89%+。而在 25GB 笔记本上,所有专家都从磁盘流——慢,但语义不变。
二、技术机制:把权重当 JIT 来做
Colibrì 把自己比作”权重的 JIT”:编译器 JIT 从不编译整个程序,而是观察哪条路径热、即时编译它;Colibrì 对 744B 参数空间做同样的事——参数不是常驻状态,而是按路由热度在 VRAM/RAM/NVMe 间调度的数据。
具体手段(均来自 README):
- 逐层 LRU + 学习型热缓存:记录你的工作负载实际路由到哪些专家(
.coli_usage,每轮更新),自动钉住最热的——“用得越多越快”; - 路由前瞻预取:路由器提前一层运行,实测路由决策提前一层的可预测性达 71.6%,用预取掩盖磁盘加载延迟;
- I/O 是引擎的一部分:一个专家的三个矩阵相邻存放、一次
pread读完;批量位置只对每个唯一专家读一次(batch-union);异步 I/O 池边算边读; - 多 SSD 条带:两块独立 NVMe 实测解码提速 +37.5%(但官方也说这需要更广泛的社区 A/B 复现);
- O_DIRECT:绕过页缓存,在有 DRAM 缓存、带宽富余的盘上实测 +34% 解码,但官方明说这是”看盘下菜”——QLC/无 DRAM/虚拟磁盘上可能无效甚至变慢。
三、关键数据:不同硬件上到底多快
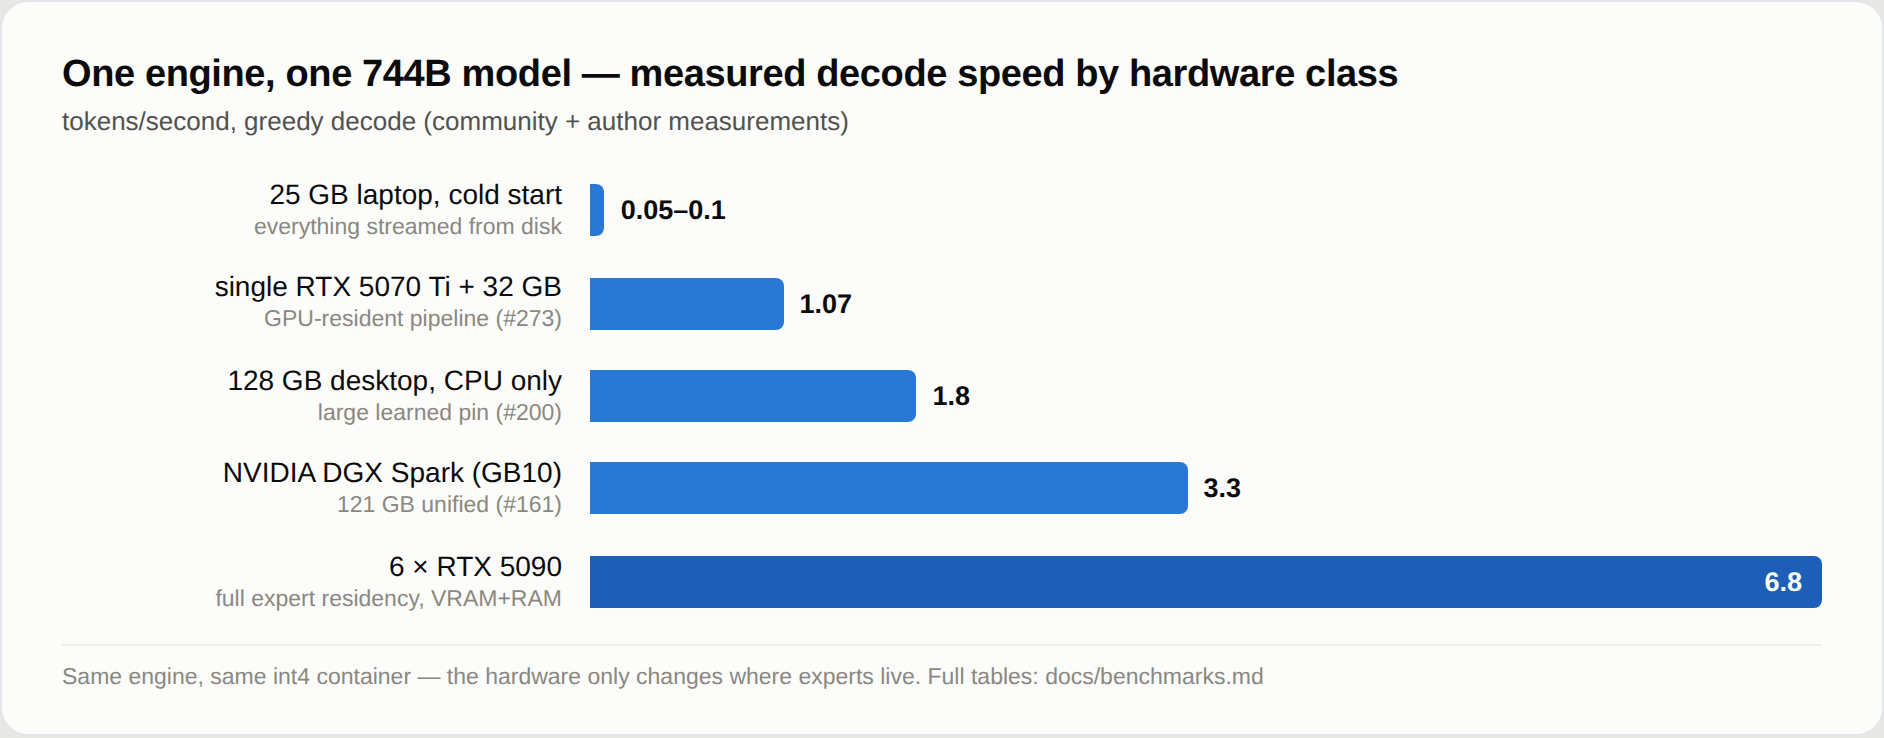
官方给出的贪心解码速度阶梯(社区 + 作者实测,tokens/s):
| 硬件配置 | 解码速度 |
|---|---|
| 25GB 笔记本,冷启动,全部从磁盘流 | 0.05–0.1 |
| 单张 RTX 5070 Ti + 32GB,GPU 常驻管线 | 1.07 |
| 128GB 台式机,纯 CPU,大学习钉扎 | 1.8 |
| NVIDIA DGX Spark(GB10,121GB 统一内存) | 3.3 |
| 6 × RTX 5090,专家全驻留,VRAM+RAM | 6.8 |
也就是说,“笔记本能跑”是真的,但速度是 0.05–0.1 token/s 量级——比打字还慢,离生产可用很远。只有堆到 6 张 5090 全驻留,才到 6.8 tok/s。周报里提到的 Apple M5 Max 约 1 token/s,与这张阶梯图里”单卡 5070 Ti 1.07”大致同档,但官方阶梯图并未单独列出 M5 Max,此数字应按社区实测看待。
四、口径偏差与官方自陈的”开放假设”
Colibrì 的 README 在诚实度上相当 unusual,它专门列了一张”开放假设”表,把每个优化当成待证伪的假说,并写明需要补的实验:
- 没有 SLA,只有语义保证:官方明确”对速度不做 SLA 承诺”,但有一条硬保证——绝不偷偷改模型精度或路由语义。快速内存不足只会变慢,不会”悄悄换一个模型”。
- 路由历史可能过拟合:学习型钉扎在重复工作负载上有效,但官方承认”历史会过拟合提示词、前瞻在某些机器上反而输”,所以这些都是可测量的策略,不是承诺。
- 投机解码会反噬:原生 MTP(多 token 预测)和语法约束草稿端到端可测,但官方实测在专家命中率约 85% 时 MTP 出现了 32% 的损失——即投机不是永远划算,要按接受率/命中率/批量联合调,不划算就关掉。
- 正确性有 oracle 背书:前向传播对照 transformers oracle 验证,teacher-forcing 通常 30–32/32 通过;MLA 注意力把 KV 压到每 token 576 个 float(原来 32,768,小 57 倍),并持久化
.coli_kv,重开对话零 re-prefill 且字节一致。 - 多盘提速未闭环:双盘 +37.5% 是在特定控制器/缓存状态下测得的,官方呼吁社区发”受控的负面结果”,而不是只报快的数字。
五、适用与不适用
适合:想在自有硬件上近距离”把玩”接近万亿参数模型的研究者/极客;观察专家路由热力图(它内置 Brain 页面把 13,260 个专家画成大脑皮层)、做推理侧系统研究的人;数据敏感、不想把权重交给 API、且能容忍极慢速度的离线场景。它已支持九个模型家族,包括 GLM-5.2/5.3(744B)、Inkling(975B)、Kimi K3(2.8T)、DeepSeek V4.1 Flash(552B,带视觉)等。
不适合:任何对吞吐/延迟有要求的生产服务(笔记本 0.05 tok/s 完全不可用);想要开箱即用、调好参的用户——它默认要你自己按机器调 --checkers 类旋钮、决定 O_DIRECT 开不开、要不要加第二块盘。
六、它意味着什么
Colibrì 不是要替代 llama.cpp 做日常推理,而是一个用极简代码(单文件 C)验证系统假说的开放研究平台。它证明了一件事:当 SSD 带宽持续逼近内存、当 MoE 的稀疏性被吃透,“把 744B 模型放在笔记本里、按需从磁盘流专家”在工程上是成立的——哪怕今天慢得像蜗牛。随着 NVMe 带宽继续上涨、专家级联缓存策略被更多人 A/B,“专家按需加载”很可能从极客玩具变成本地大模型的常规手段。它真正的价值,是把”推理还能怎么优化”这个黑盒,拆成了任何人都能测量、证伪、改进的一行行 C 代码。