OpenAI 官方 Codex 插件:在 Claude Code 里调用对手模型的双 Agent 工作流
阅读时间: 大约 11 分钟
OpenAI 官方 Codex 插件:在 Claude Code 里调用对手模型的双 Agent 工作流
2026 年,AI 编码工具的竞争格局出现了一个颇具象征意义的现象:OpenAI 官方为 Anthropic 的 Claude Code 写了一个插件,让用户不离开 Claude Code 就能调用自家的 Codex。这个仓库叫 openai/codex-plugin-cc,采用 Apache-2.0 协议。本文基于其 GitHub README,拆解它到底做了什么、怎么实现的,以及官方自己警告的风险。
一、背景:为什么 OpenAI 要”抱对手的大腿”
Koala 在周报里点出了这件事的微妙之处:Claude Code 在开发者心智中的强势地位,使得 OpenAI 宁可把 Codex 嵌入 Claude Code 的工作流,也不愿让用户流失到完全不用 Codex。这本质上是一个”用量保优先”的策略——与其争夺编辑器入口,不如先保证 Codex 模型仍在开发者的日常循环里被调用。
对开发者而言,这恰恰打开了一个实用模式:用一个模型写代码,换另一个模型做对抗性评审。两个不同厂商的模型各自有盲区,交叉审查往往能抓到单一模型漏掉的问题。
二、它是什么:一组斜杠命令
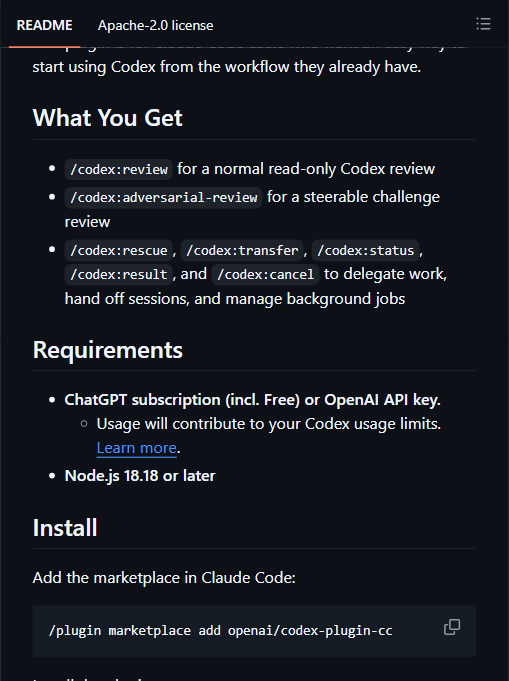
这不是一个独立应用,而是一个 Claude Code 插件,安装后注册一批 /codex:* 斜杠命令与一个子 Agent。官方给出的命令面如下:
| 命令 | 作用 | 是否只读 |
|---|---|---|
/codex:review | 常规 Codex 代码评审(等同在 Codex 里跑 /review) | 是,不改代码 |
/codex:adversarial-review | 可定向的”对抗性”评审,挑战实现方向与设计取舍 | 是,不改代码 |
/codex:rescue | 把任务委派给 Codex 子 Agent(查 bug、试修复、续跑、换小模型) | 否,可改代码 |
/codex:transfer | 把当前 Claude Code 会话导出为可在 Codex 续跑的线程 | — |
/codex:status | 查看当前仓库的后台 Codex 任务 | — |
/codex:result | 查看已完成任务的最终输出 | — |
/codex:cancel | 取消进行中的后台任务 | — |
两个评审命令都支持 --base <ref>(对比某个分支,如 main)、--wait 与 --background。区别在于:/codex:review 不可定制焦点;/codex:adversarial-review 可以在后面附加自然语言焦点,例如 /codex:adversarial-review --base main challenge whether this was the right caching and retry design,专门施压鉴权、数据丢失、回滚、竞态条件等风险区。
三、技术机制:包装本地 Codex CLI,而非另起运行时
理解它的实现边界很关键。README 的 FAQ 写得很清楚:这个插件不部署独立的 Codex 运行时,它只是包装你机器上已安装的全局 codex 二进制与 Codex app server:
- 复用你本地的 Codex 安装、登录态与仓库 checkout;
- 复用
~/.codex/config.toml的配置,可在项目根目录用.codex/config.toml覆盖(如model = "gpt-5.4-mini"、model_reasoning_effort = "high"); - 若需把 OpenAI 端点指向自建网关,在配置里设
openai_base_url即可。
委派任务通过一个名为 codex:codex-rescue 的子 Agent 完成,支持 --model、--effort 参数(如 --model gpt-5.4-mini --effort medium)。README 提到一个有趣的映射:说 spark 会被映射到 gpt-5.3-codex-spark 这个更小更快的模型。
会话迁移(/codex:transfer)走的是 Codex 的 external-agent session importer,把 ~/.claude/projects 下的会话记录转成 Codex 可见的对话轮次,可直接在 Codex App/TUI 里 codex resume <session-id> 续跑。官方明确要求来源必须在 ~/.claude/projects 之下,且旧版 Codex 不支持会话导入时需先升级。
四、关键数据与前提
- 许可证:Apache-2.0(已核实)。
- 前置条件:Node.js 18.18+;需要 ChatGPT 订阅(含免费档)或 OpenAI API key;“Usage will contribute to your Codex usage limits”——调用会消耗你自己的 Codex 额度。
- 安装:
/plugin marketplace add openai/codex-plugin-cc→/plugin install codex@openai-codex→/reload-plugins→/codex:setup。 - 版本活跃度:发布 7 个 release(最新 v1.0.6),但仓库开放 Issue 高达 272 个、PR 240 个——一方面说明关注度极高,另一方面也说明它仍处在快速变动、问题密集的阶段。
五、官方自己承认的局限与口径偏差
这一节是本文重点,因为 README 里有一处明确的警告:
- Review Gate 可能”烧穿”额度:
/codex:setup --enable-review-gate会启用一个 Stop hook——每当 Claude 准备结束回答时,插件自动跑一次 Codex 定向评审;若发现问题就阻止停止,逼 Claude 先修复。README 用大写 Warning 写道:“The review gate can create a long-running Claude/Codex loop and may drain usage limits quickly. Only enable it when you plan to actively monitor the session.” 也就是说,这个”自动双模型互审”听起来很美,但一旦两个模型来回拉扯,调用量会失控飙升,官方明确建议只在有人盯着会话时才开。 - 评审命令耗时:官方提示多文件改动的评审”might take a while”,建议一律后台跑——这不是秒级反馈工具。
- 免费 ChatGPT 账号也能用,但受 Codex 额度约束:所谓”免费可用”是指不需要额外付费订阅,不代表调用无成本,额度耗尽即停。
- 会话迁移有版本与路径约束:依赖 Codex 新版的 session import,且来源路径受限,并非任意对话都能无损搬过去。
六、适用 / 不适用场景
适合:
- 已经在用 Claude Code、同时也有 ChatGPT/OpenAI 账号的开发者;
- 想在合并前让另一个模型做一轮对抗性设计评审(鉴权、并发、回滚这类高风险区);
- 想把一个卡住的调试任务随手甩给 Codex 试修,再回来对比结论;
- 团队想试点”双模型交叉审查”而不想引入重型 CI 流程。
不适合:
- 只订阅了 Anthropic、完全没有 OpenAI 账号/额度的人(用不起来);
- 指望它自动、无人值守地兜住所有质量问题的团队——review gate 的额度风险摆在那里;
- 对延迟敏感、希望秒级评审反馈的场景(多文件评审需要后台等待);
- 想在 CI 里大规模、无人值守批量跑的人(用量与循环风险需自行压测)。
七、客观分析:优势与局限
优势:
- 零切换成本:复用本地 Codex 安装与登录态,不增加新的账号体系;
- 双模型交叉评审确实能捕捉单一模型盲区,这是 Koala 也认可的实际收益;
- 命令设计克制,
review只读、rescue可写,权限边界清晰; - Apache-2.0 协议友好,企业内审改风险低。
局限:
- 本质是 thin wrapper:价值完全取决于底层 Codex CLI 的能力,插件本身不提供独立智能;
- 额度联动:Claude 与 Codex 两边的额度都会被消耗,双跑成本翻倍;
- 成熟度早期:272 issue / 240 PR 说明体验仍在打磨,文档与命令行为可能快速变动;
- 仅支持 Claude Code 这一个宿主, Cursor/Windsurf 用户用不上。
八、它意味着什么
这件事的长期看点不在插件本身,而在它标志的趋势:头部编码 Agent 之间正在从”封闭竞争”走向”可互操作、可互相委派”。OpenAI 官方给 Claude Code 写插件,等于承认了 Claude Code 作为入口的现实地位;而”一个模型写、另一个模型审”的工作流,很可能成为 2026 年后半段的常规实践。当然,这种巨头互操作能维持多久是个问号——Koala 也持保留态度。但至少在当下,能让用户在自己最顺手的工具里自由切换模型,开发者是净受益方。