CocoIndex:为 AI Agent 做增量数据管道,只重算变化的那一部分
阅读时间: 大约 9 分钟
CocoIndex:为 AI Agent 做增量数据管道,只重算变化的那一部分
做 RAG / Agent 应用时,最容易被忽略的成本不是 embedding 本身,而是全量重算:源数据(代码库、文档、Slack、PDF)一改,传统管道就把整个语料重新切片、重新 embedding、重新写库——大模型 API 费用就这样白白烧掉。「Koala 聊开源」介绍的 CocoIndex 正是冲着这个痛点来的:一个面向 AI 场景的增量数据框架,核心引擎重写以支撑增量处理,源数据变更时只重算受影响的部分,还内置 CocoInsight 让非数据工程师也能可视化理解 pipeline。本文基于其官网与 GitHub 仓库做一次拆解。
一、背景:传统 ETL 接不上 AI 工作负载
传统数据管道(Airflow 等)擅长定时全量/批量同步,但 AI 应用的数据处理有两个新特征:一是中间步骤要调大模型(切片、embedding、摘要、抽取实体),每一步都真金白银花钱;二是源数据高频变化(每次 commit、每条新消息)。如果每次都从头跑全量,成本和延迟都不可接受。CocoIndex 的判断是:Agent 会因为「数据过期/不准」而犯错,所以数据必须持续新鲜(continuously fresh),但又不能为此付出全量重算的代价。
二、是什么
官方定位:「面向长程(long-horizon)Agent 的增量引擎」。它把代码库、会议纪要、收件箱、Slack、PDF、视频等,变成给 AI Agent / LLM 应用持续提供、可推理的实时上下文,且只做最小增量处理。其卖点关键词是:
- Incremental(只算 delta):只重算变化的部分;
- Any scale, parallel by default:任意规模、默认并行;
- Declarative, Python, 5 min:声明式,Python 接入五分钟上手。
安装就是 pip install -U cocoindex,写一段 flow 声明目标状态即可。
三、技术机制:memo 缓存 + 声明式目标状态
其核心机制可以从两段官方信息看出来:
- 基于哈希的 memo 缓存。核心 API 是一个装饰器:
@coco.fn(memo=True)   # ← 按 hash(input) + hash(code) 缓存
async def index_file(file, table):
...也就是说,每个处理函数的结果按输入内容哈希 + 代码哈希缓存。源文件没变、处理代码也没变,就直接复用上次结果;只有输入或代码变了的那部分才重新执行(包括重新调 embedding / LLM)。官方语:「Run once to backfill. Re-run anytime — only the changed files re-embed.」 2. 声明目标状态,引擎自动对账。你不需要写调度逻辑,只要声明「目标存储里应该有什么」,框架就会监听源、计算 delta、并行地把目标与最新源数据和代码对齐;即使下游已经连着线上 Agent,也只有变化的代码会被重跑,schema 自动演进。
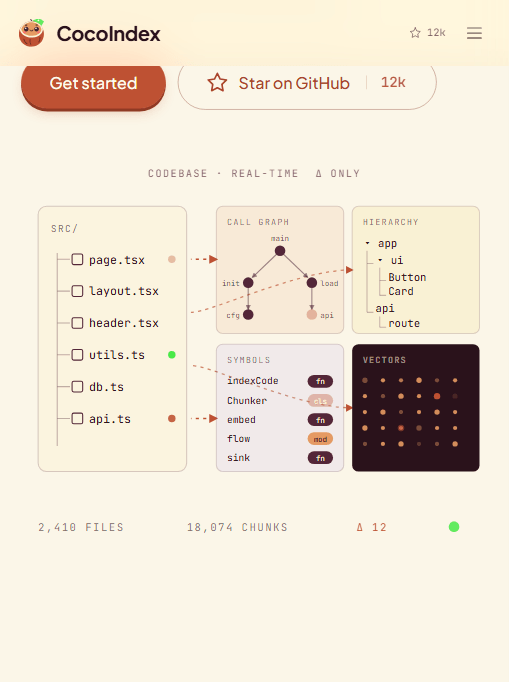
从首页那张图能直观看到这套模型:左侧源文件树里,绿色/红色标记出变动的文件(utils.ts、api.ts),经过调用图、层次结构、符号表,最终落到向量库;底部一行「2,410 FILES / 18,074 CHUNKS / Δ 12」——两千多文件、近两万个 chunk,本次只需要重算 12 个。这就是「只算 delta」的可视化。官方称在任意仓库规模下都能做到亚秒级新鲜度。
四、关键事实(官方口径)
| 维度 | 内容 |
|---|---|
| 定位 | 面向长程 AI Agent 的增量数据/上下文引擎 |
| 数据源 | 代码库、会议纪要、收件箱、Slack、PDF、视频等 |
| 核心机制 | 声明目标状态 + 按 hash(input)+hash(code) 的 memo 缓存,只重算 delta |
| 性能 | 官方称亚秒级新鲜度、任意规模、默认并行 |
| 接入 | Python 声明式,pip install cocoindex,连接器含 localfs、postgres |
| 可视化 | 内置 CocoInsight,非数据工程师也能看懂 pipeline |
| Stars/状态 | 约 12K GitHub Stars,官网标「Production Ready」 |
| 成本逻辑 | 只有变更 chunk 重新 embedding/调 LLM,省 API 费用 |
五、评测方法与口径批判
CocoIndex 官网与 README 给了方向性描述,但缺少严谨的独立基准:
- 「亚秒级新鲜度」「任意规模」是官方说法,未给出仓库规模、硬件、并行度与重算命中率的测试条件;增量收益高度依赖变更命中率——如果每次改动都牵动大量下游,delta 优势会缩水;
- 「只重算 delta」成立的前提是函数可被正确哈希:输入哈希覆盖不到的隐式依赖(全局配置、网络状态、时间)可能导致缓存结果过期却不被重算,这是增量框架的经典陷阱;
- 「Production Ready」是官方自评,作为较新框架,其与各主流向量数据库/向量库的集成深度、边缘 case 处理仍需生产时间检验(这也是 Koala 点评的判断);
- 省 LLM 费用的前提是真的只对变更重跑,首次 backfill 的全量成本与一次性 embedding 开销依然存在。
六、适用与不适用场景
适合:
- 高频更新的代码库/文档/Slack 驱动的 RAG、代码 Agent、知识助手;
- 已经在为「每次全量重新 embedding」付大模型账单的团队;
- 想用声明式 Python、不想搭一套调度系统就能做增量管道的工程师;
- 需要把结构信息(调用图、符号表、层次)喂给编码/审查 Agent 的场景。
不适合:
- 低频、一次性的离线数据处理(增量框架的收益用不上);
- 对缓存正确性要求极端严苛、无法接受隐式依赖导致陈旧缓存的场景;
- 需要深度定制调度、复杂依赖 DAG 编排的传统数仓工程。
七、客观分析:优势与局限
优势:
- 直击成本痛点:只对变更重算,显著减少 embedding/LLM 调用费用;
- 声明式 + Python 低门槛:五分钟接入,无需手写调度;
- 并行与规模化:默认并行、任意规模,面向代码库这类大上下文;
- 可观测:CocoInsight 让 pipeline 对非数据工程师可见可解释。
局限:
- 增量正确性边界:哈希缓存对隐式依赖不敏感,可能出现陈旧结果;
- 缺独立基准:亚秒/任意规模无公开测试条件;
- 生态年轻:与各向量库、数据源的集成深度仍在完善;
- 首次全量成本:backfill 仍需一次性完整 embedding。
八、它意味着什么
CocoIndex 代表了 AI 数据管道从「批量 ETL」走向「增量、持续新鲜」的趋势:当数据管道里塞满了按 token 计费的 LLM 调用,「只算变化的那部分」就从性能优化变成了直接的成本优化。对正在构建 RAG 与长程 Agent 的团队,它值得一试——但落地时要重点验证缓存哈希是否覆盖了真实依赖,并以自己的语料变更频率实测节省比例,而不是默认「delta 一定等于省钱」。