Cloudflare Clef:不生成文字、只做结构化决策的开源模型
阅读时间: 大约 10 分钟
Cloudflare Clef:不生成文字、只做结构化决策的开源模型
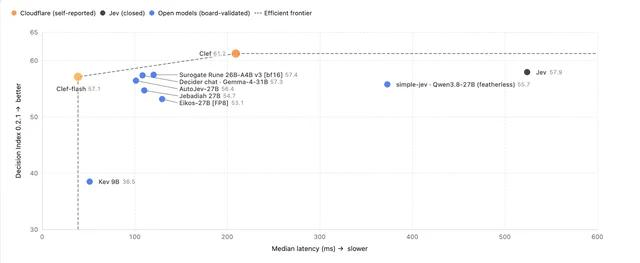
2026 年 10 月 1 日,Michelle Chen、Alex Reneau 与 Kevin Flansburg 代表 Cloudflare 发布并开源了两个决策模型:Clef 与 Clef-flash,二者已上线 Workers AI,并以 Apache 2.0 协议在 Hugging Face 开放权重。这类模型不做开放式文本生成,而是在你预设的 schema 选项里直接给出带概率的结构化答案。官方称 Clef 目前在 Jev Decision Index 上排名第一。
一、什么是决策模型:为什么不用通用大模型
过去几周,Typesafe AI 的 Jev 带火了”决策模型”这个概念。它要解决的问题很具体:Agent 工作流里有大量环节其实是分类与路由——一张工单该转给哪个团队、是否紧急、一个域名是不是钓鱼网站。用通用 LLM 做这类决策,既慢(要逐 token 自回归生成)又不稳定(输出格式不固定)。
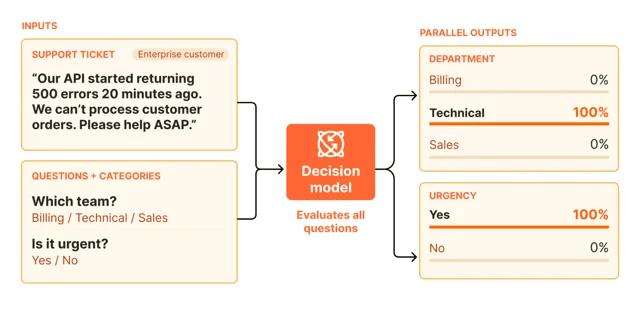
决策模型的做法是:你给它输入(如一条客服工单)和一组”问题 + 类别”(如”哪个团队?Billing/Technical/Sales""紧急吗?Yes/No”),它并行地对所有候选类别打分,返回严格类型化的概率,你的代码据此路由、升级或转人工。
Cloudflare 自己的落地例子是威胁情报:给 Clef 一个域名(配合 Browser Run 抓取渲染),它分类出”95% 时尚网站、85% 电商、<1% 钓鱼”。官方称这套抓取+渲染+分类耗时 2.2 秒,而同一个工作流里最快的通用 LLM gpt-oss-120b 要 4.7 秒,且只返回两个分类——约 2 倍延迟节省。
名字本身是个音乐梗:clef(谱号)放在谱表开头,规定后面每个线间对应什么音高;决策模型则规定输入的”取值域”以及后续动作。后缀 CF 双关 Cloudflare。
二、技术机制:冻结大骨干,只训”打分头”
Clef 的关键不在缩小参数量,而在改变解码方式:
- 骨干:以 Qwen 为基座。Clef 冻结 Qwen3.8-27B,Clef-flash 冻结 Qwen3.5-9B;
- 只训练路由头 + 低秩适配器:联合优化路由 head 与 rank-256 的 LoRA,主体权重冻结;
- 非自回归解码:推理时 Qwen 只做一次 prefill,然后对 schema 里所有合法选项并行打分,不逐 token 生成中间文本;
- 两段式注意力路由:每个合法选项先抽取与 prompt 相关的上下文,各字段参数之间、字段与原始 payload 之间联合交叉注意力后再打分,并借助”词法先验”保持跨选项语义一致。
后训练用标签平滑交叉熵(约束在合法 schema 输出上)加 Brier loss(校准概率),数据是内部合成集(打乱字段顺序、prompt 与 schema 结构)。此外还自研了 **RLCD(Reinforcement Learning for Calibrated Decisions)**作为第二优化目标:对相邻序数选项给部分分、对完全精确的记录输出给满分、并加参考分布惩罚防止漂移。
这套做法带来三个官方声称的结果:分类更准、输出被严格约束为概率而非自由文本、且比 Jev 和基座 Qwen 更快。
三、关键数据:延迟与基准
官方在 Jev Decision Index 口径下的延迟数据(中位数 / p95):
| 指标 | Clef | Clef-flash | Jev | DiffusionGemma Jev | Kev 9B | Laya |
|---|---|---|---|---|---|---|
| 中位延迟(ms) | 209.3 | 38.8 | 524.1 | 84.4 | 51.4 | 5.8 |
| p95 延迟(ms) | 238.6 | 122.4 | 536.0 | 211.2 | 187.9 | 222.5 |
质量基准(节选,越高越好):
| 基准 | Clef | Clef-flash | Jev | Kev 9B | Laya |
|---|---|---|---|---|---|
| BFCL · case exact | 98.47 | 98.76 | 95.75 | 94.51 | 38.13 |
| API-Bank · accuracy | 91.93 | 93.11 | 88.19 | 56.30 | 11.41 |
| BANKING77 · macro-F1 | 94.20 | 90.93 | 79.74 | 84.83 | 14.29 |
| CLINC150+OOS · macro-F1 | 97.43 | 66.77 | 89.27 | 79.03 | 3.19 |
| When2Call · accuracy | 72.37 | 65.58 | 80.97 | 49.62 | 11.94 |
官方还称在 Typesafe 自家评测套件的 4 个工作流中赢下 3 个(发票处理、客服、安全事件领先,Agent trace 可观测性落后 Jev);并强调 Clef 具备 视觉编码器(可吃图像,Jev 目前只做文本)与 64K 上下文(Jev 为 32K)。模型完全兼容 Jev API,可即插替换。
四、评测方法批判:这些数字该怎么读
- 散点图是”自报”口径。官方散点图图例明确标注:Cloudflare 自己的点(橙色)为 self-reported,Jev 为 closed,开放模型为 open-validated。也就是说”Clef 排名第一”是在第三方 Jev Decision Index 框架下、由 Cloudflare 自己跑出的成绩,并非独立第三方复测。
- “赢 Jev”是 4 项工作流里赢 3 项,不是全胜;When2Call、BRIGHT、Agent trace 可观测性等单项上 Jev 仍然领先。
- Laya 是反面参照:它中位延迟只要 5.8ms,远快于 Clef-flash 的 38.8ms,但质量基准几乎全线崩盘(BANKING77 仅 14.29)。官方自己承认 Laya”很快但牺牲质量”——这说明 Clef-flash 的快是靠架构而非盲目砍参数换来的,但”最快”这个桂冠并不在它头上。
- 2.2s vs 4.7s 是端到端工作流数字(含 Browser Run 抓取渲染),不是纯模型推理延迟,不能和上面的 38.8ms 混为一谈。
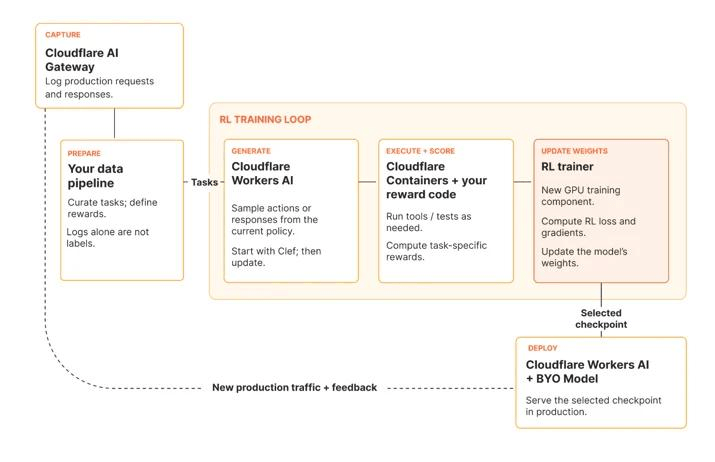
- 微调会牺牲通用性:官方明确说微调换领域精度时”可能放弃一些通用能力”;RL 服务目前先是 FDE 手把手合作,自助平台尚未开放。
五、优势与局限
优势:
- 非自回归并行打分,绕开了逐 token 生成,flash 中位 ~39ms 足以放进 Agent 热路径;
- 冻结大骨干 + 小 LoRA:不盲目缩小模型,靠解码方式提速,保留了 27B 级别的语义理解;
- 多模态 + 长上下文:支持图像输入、64K 上下文,且 Jev API 兼容、Apache 2.0 可自托管;
- 边缘部署:跑在 Workers AI 的边缘 GPU 上,网络延迟也低。
局限:
- 只做”决策”不做”生成”:输出被约束在 schema 概率里,开放式推理、写代码、写长文仍要回到通用 LLM;
- 领先幅度与评测口径绑定:自报基准、单项互有胜负,真实效果仍需用自己的分类集复测;
- RL 微调尚未自助化:现阶段要接入得先和 Cloudflare 做设计伙伴;
- 概率校准依赖专门训练:Brier loss 与 RLCD 是其概率可信的前提,自改 schema 后需重新验证。
六、谁该关注
- 在 Agent 里大量做路由/分类/分诊(工单、内容审核、安全、爬虫好坏判定)的团队:用专用决策模型替代通用 LLM 做这些环节,是务实的降本提速;
- 需要可自托管、可微调的结构化分类器:Apache 2.0 权重 + Jev API 兼容,迁移成本低;
- 对延迟敏感、要把决策放进热路径的服务:Clef-flash 的 ~39ms 中位数适合此场景。
但如果你需要的是开放式推理或长文本生成,Clef 不是替代品——它的定位正是”在通用 LLM 旁边,做那个又快又稳的小决策官”。