ast-grep:用语法树而不是正则来 grep 和重构代码
阅读时间: 大约 9 分钟
ast-grep:用语法树而不是正则来 grep 和重构代码
在大型代码库里做批量修改,传统三板斧是 grep/sed、IDE 全局替换、ESLint 规则。它们的共同问题是都基于文本:正则分不清 foo.bar 里的点是属性访问还是小数点,IDE 替换可能误伤注释和字符串,写一条 ESLint 自定义规则又要先吃透它的插件体系。ast-grep(命令名 sg,作者 Herrington Darkholme,Rust 编写)把这一层拉到了抽象语法树:你写一段”代码模式”,它按语法匹配,再批量改写。
一、是什么:语法感知的 grep/sed
官方一句话定位:“a fast and polyglot tool for code structural search, lint, rewriting at large scale”。它的标志性用法是模式 + 重写:
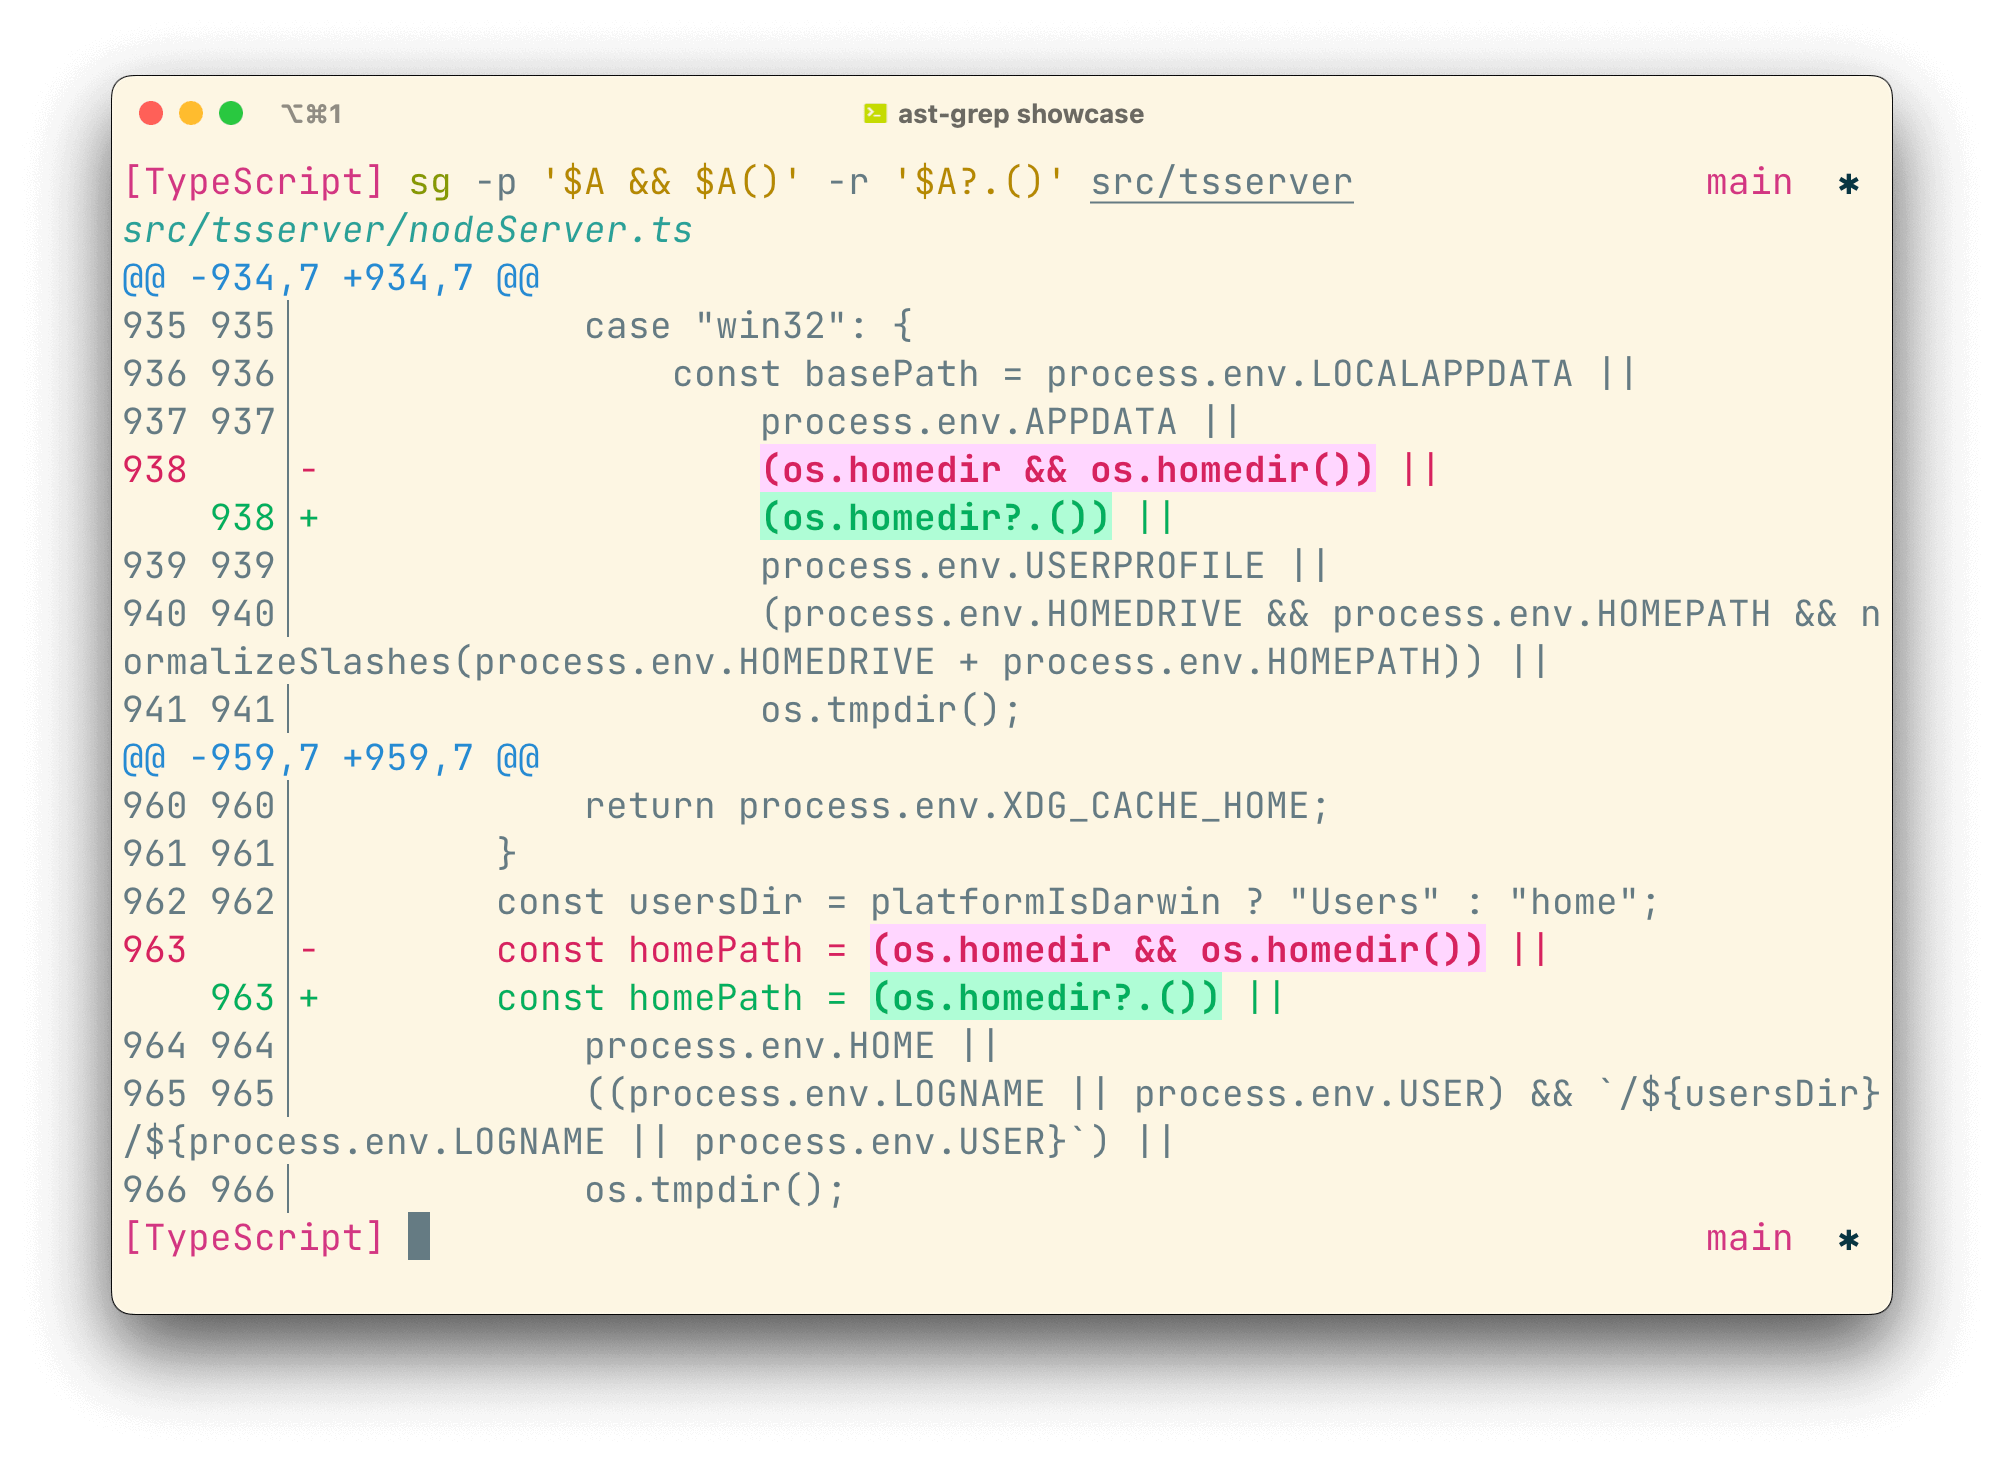
ast-grep -p '$A && $A()' -r '$A?.()'读作:找”某个表达式 $A 先做真值判断、然后立刻调用 $A()”的代码,改写成可选链 $A?.()。$A 是 AST 占位符,可以匹配任意表达式节点——这比正则 (\w+)\s*&&\s*\1\(\) 可靠得多,因为它根本不看文本,只看树结构。截图里这条命令在 src/tsserver 下一次性把 (os.homedir && os.homedir()) 改成了 (os.homedir?.()),连上下文缩进都自动对齐。
二、三种用法:从一行命令到编程式 API
官方把能力分成三层,对应不同用户:
| 用法 | 命令/接口 | 场景 |
|---|---|---|
| 搜索替换 | sg -p <pattern> -r <rewrite> | 一次性 codemod、批量重构 |
| 当 Linter | sg scan + YAML 规则 | 团队自定义静态检查,CI 里跑 |
| 编程式 | npm install @ast-grep/napi | Node.js 里像 jQuery 一样遍历 AST,有可选类型安全 |
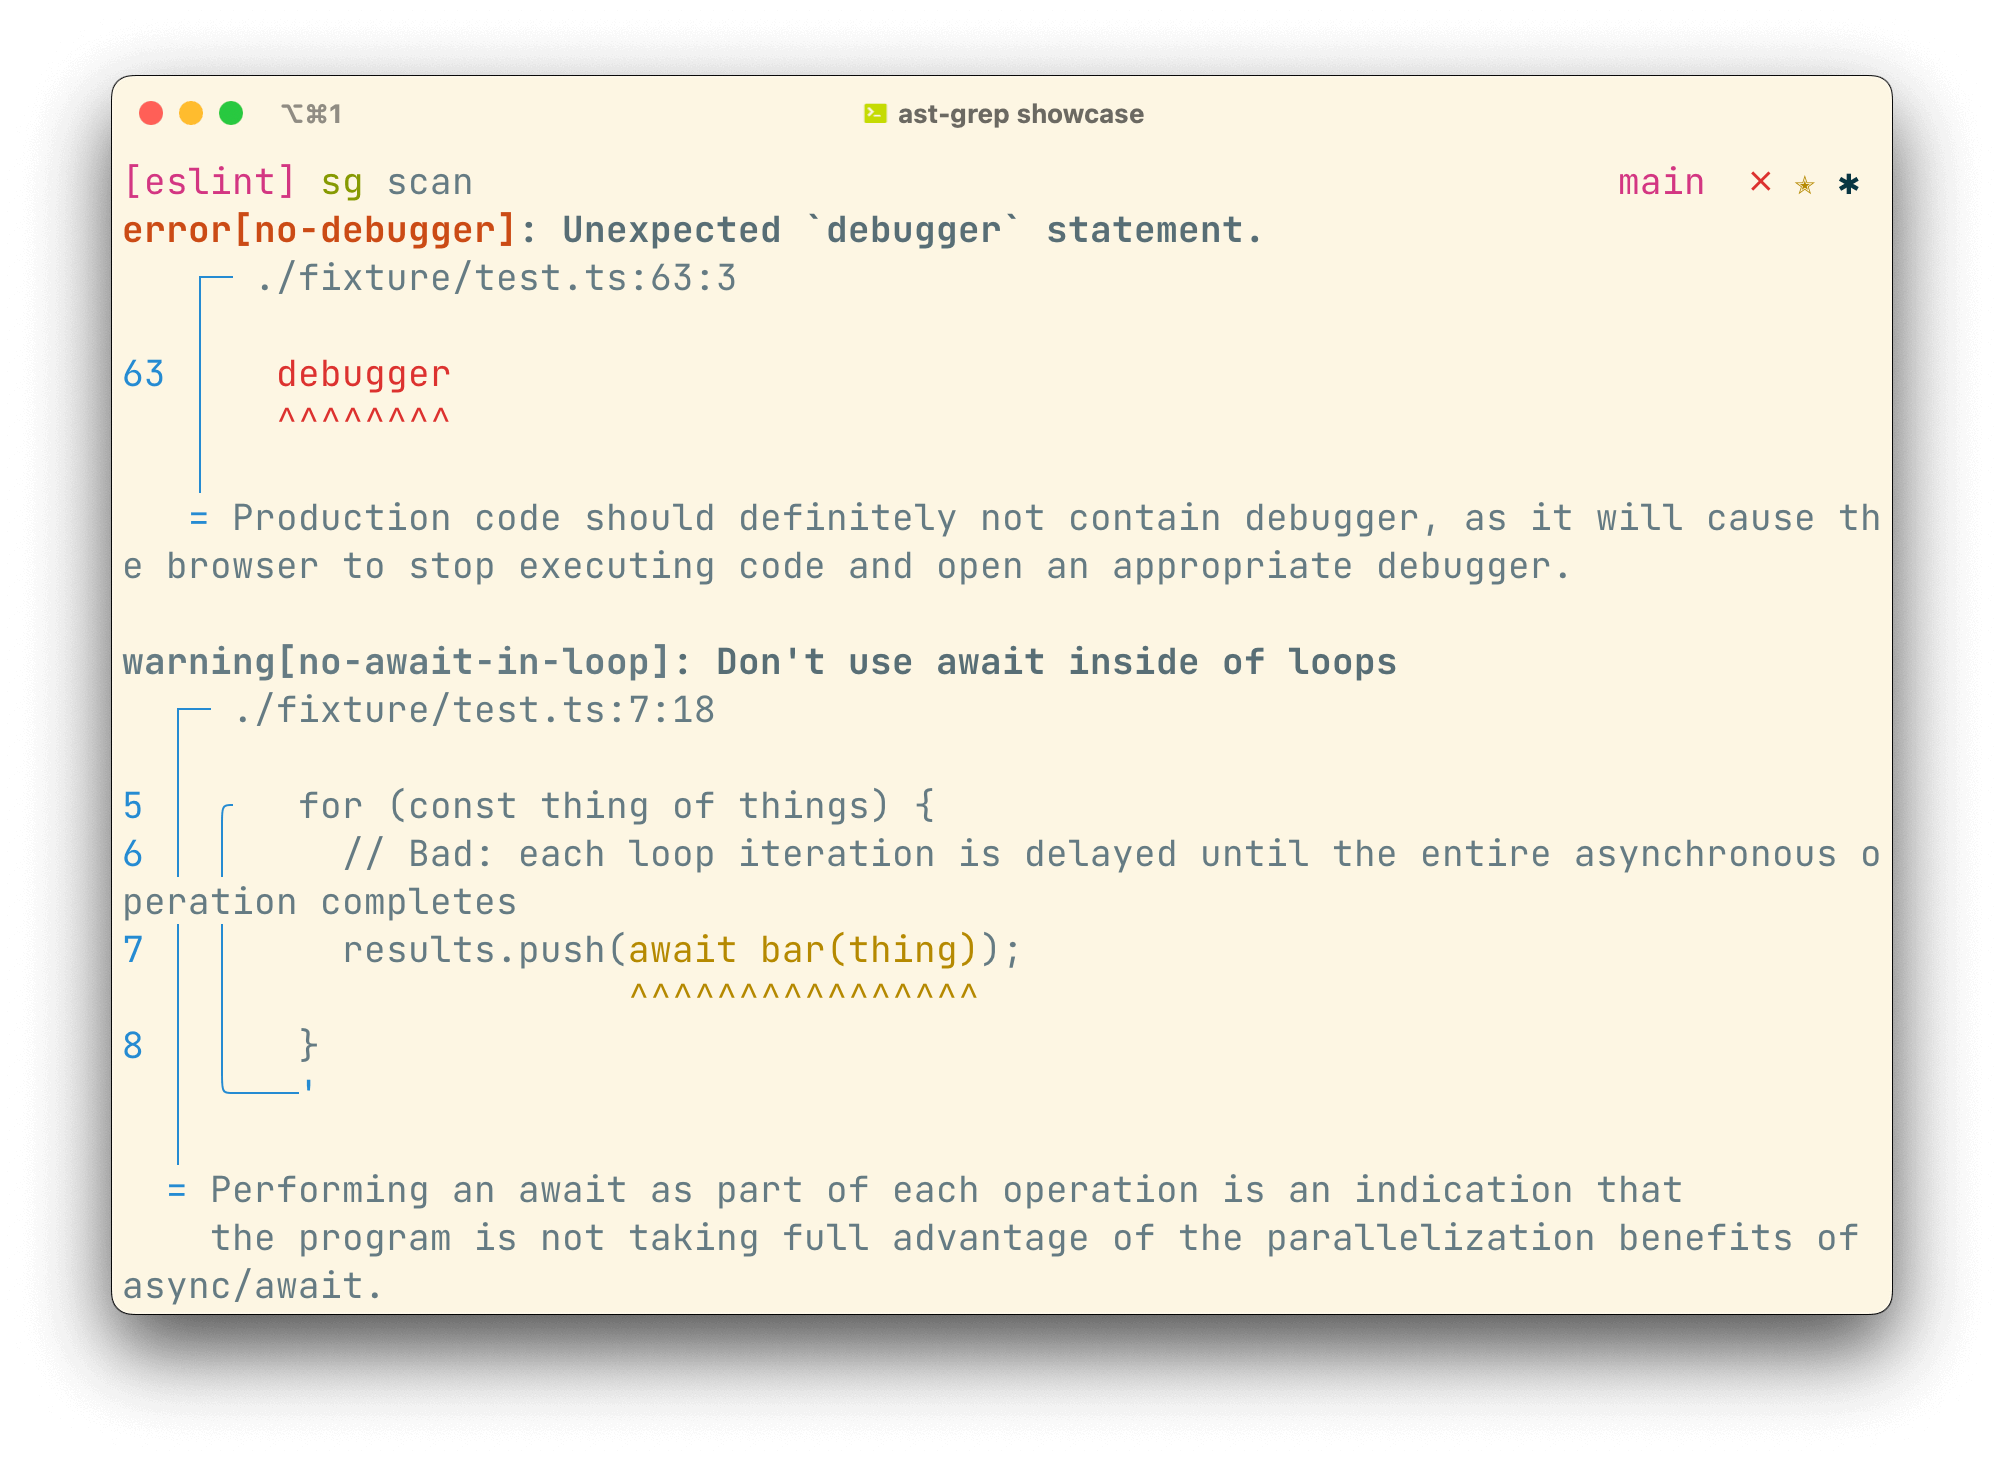
lint 模式的输出形态对标 ESLint:规则名、严重级别、文件行列号、被命中代码片段、以及一条解释。截图里 no-debugger 报 error,no-await-in-loop 报 warning——这些规则不用写 TypeScript 插件,用 YAML 描述模式即可。官方还提供交互式 codemod、Language Server(编辑器内即时反馈)和规则测试工具。
三、为什么快、为什么多语言
技术上它建立在两个开源底座上:Rust 负责并行与性能(官方称跨数千文件 blazing fast),Tree-sitter 负责把各种语言解析成统一的 AST。官方称开箱支持 20+ 语言(C/C++、C#、Go、Java、JS/TS、Python、Rust、Kotlin 等),还能动态加载自定义 Tree-sitter 解析器。
这个组合很关键:Tree-sitter 本来就是为”编辑器增量解析”设计的,容错性好、解析快;ast-grep 把它从编辑器语境搬到了 CLI/CI 场景。所谓”polyglot”不是为每种语言手写匹配器,而是复用同一套 Tree-sitter 生态——这也是它能快速覆盖 20 多种语言的原因。
值得对比一下传统做法的痛感。假设你要把代码库里所有 a && a() 改成 a?.():用 sed 写正则,得处理变量名、空格、换行、括号等无数变体,还会误改注释里的文字;用 IDE 全局替换,它不懂 AST,可能把 foo && foo() 和字符串里的 "foo && foo()" 一起动了;写 ESLint 规则,则要配置插件工程、跑完整 TS 类型服务,启动一次就要数秒。ast-grep 的中间路线——模式即代码、Rust 启动毫秒级、Tree-sitter 容错解析——恰好卡在这个缝隙里。它的 Node API 还支持”opt-in 类型安全”,意味着你可以把复杂 codemod 写成可测试的脚本,而不是一条不敢回头的 shell 命令。
四、客观分析:优势与局限
优势:
- 模式直接用代码写,学习曲线远低于写 ESLint 插件或 AST visitor;
- Rust 并行,大仓库秒级扫完,适合进 CI;
- 同一套规则既能 CLI 手动跑,也能 Node API 编程式调用,迁移成本低;
- Tree-sitter 容错,语法不完美的文件也能尽量分析,不像某些 AST 工具遇到一点语法错误就整文件放弃。
局限(口径偏差):
- “结构化”不等于”语义理解”:它匹配的是语法树形状,不做类型推导。
$A && $A()能匹配,但涉及类型约束、跨文件引用的重构它做不了——那是 ts-morph / Rust compiler 的活; - 模式写法对不同语言有细节差异(比如 JS 的
$A和 Python 的$A语义要查文档),“20+ 语言”里一等支持的仍是主流语言,小众语言的解析成熟度参差; - 重写后仍需人工 review——AST 替换能保证语法正确,但不保证语义等价,自动批量改完必须跑测试;
- 作为相对年轻的项目(2022 年至今),复杂规则(跨节点约束、元变量精确定位)的写法仍偏”专家向”,团队推广需要有人先趟一遍文档;
- 它和 ESLint/Biome 不是替代关系——风格格式化交给 Biome,ast-grep 适合补”项目专属、社区规则库没有”的那类检查。
五、谁该关注
- 维护多语言大型 monorepo、需要批量做框架升级重构(比如 React 类组件转函数式、API 改名)的工程师;
- 想给团队加几条”我们项目特有”的 lint 规则,但不想写 ESLint 插件的 tech lead;
- 做代码迁移工具/自动修复机器人的开发者——
@ast-grep/napi让你在 Node 里直接操作 AST。
如果你只在单文件里改代码,IDE 全局替换够用;ast-grep 的价值要在”跨上千文件、且必须按语法而非字面匹配”时才体现出来。它和 SCAST 这类 AST 可视化工具的分工也很清楚:SCAST 帮你”看懂”一个陌生仓库的结构,ast-grep 帮你”批量改”一个你已经理解的仓库——前者偏读,后者偏写。两者都建立在 Tree-sitter 之上,但一个把树画出来给人看,一个把树当查询索引做修改,恰好用在重构流程的两端。