ArtifactFS:Cloudflare 的懒加载 Git 文件系统,挂载大仓库不再等 clone
阅读时间: 大约 8 分钟
ArtifactFS:Cloudflare 的懒加载 Git 文件系统,挂载大仓库不再等 clone
ArtifactFS 是 Cloudflare 开源的 beta 项目(README 开篇即警告”your mileage may vary”),用 Go 写的 FUSE 文件系统守护进程。它把 Git 仓库挂载成一个正常的工作目录,却跳过完整 clone 的等待:操作系统几乎立刻看到整棵目录树,文件内容在后台按需拉取。据 Koala 项目库点评,Agent Coding 时代 git clone 次数指数级上升,大仓库的 clone 已成本不可忽视;Cloudflare 把它放进自家 Artifacts 生态,意在提升 Workers 沙箱的竞争力。本文基于官方 README 梳理。
一、它解决什么
传统 clone 要把全部 blob 拉下来才能开始干活。ArtifactFS 的做法是 blobless clone(无 blob 克隆):
- 挂载后整棵树立即可见,读某个文件时才阻塞去取它那个 blob;
- 后台 hydration 有优先级队列:优先拉 package.json、go.mod、README 这类清单文件和源码,二进制大文件靠后——因为编译器和 agent 先要看的往往是清单和源码;
- 它属于 Cloudflare Artifacts(一个”说 git 话的版本化文件系统”)生态,但也能挂任意 git 仓库。
目标场景明确:沙箱、agent、短命容器这类”等不起完整 clone”的环境。
二、架构:两段式 + SQLite 快照 + CoW 叠加层
README 给的架构分两阶段:
- 一次性 setup(add-repo):注册仓库,通常做一次快速 blobless clone;
- 长驻 daemon:通过 FUSE 挂载并服务文件操作。
内部组件分工:
- GitStore:封装 git CLI,做 clone/fetch,用
git ls-tree枚举整棵树,用常驻的git cat-file --batch池取 blob; - Snapshot(SQLite):把每个 generation 的
base_nodes批量灌入 SQLite; - Overlay(SQLite + upper/ 目录):本地写走这里,删除记为 whiteout;
- Hydrator:优先级队列 + 去重等待者,默认 4 个并行 worker(
--hydration-concurrency可调,每个 worker 维持一个cat-file --batch常驻进程,更高并发用内存换速度); - Watcher:每 500ms 轮询 HEAD/index/refs,变更后重新索引。
写路径用 copy-on-write:改一个已跟踪文件时,先 hydrate 再拷到 overlay 的 upper/,之后读都走 overlay。挂载点里放了一个合成的 .git gitfile 指向真实 gitdir,所以 git 命令能在挂载目录里正常跑。
三、支持哪些 git 操作
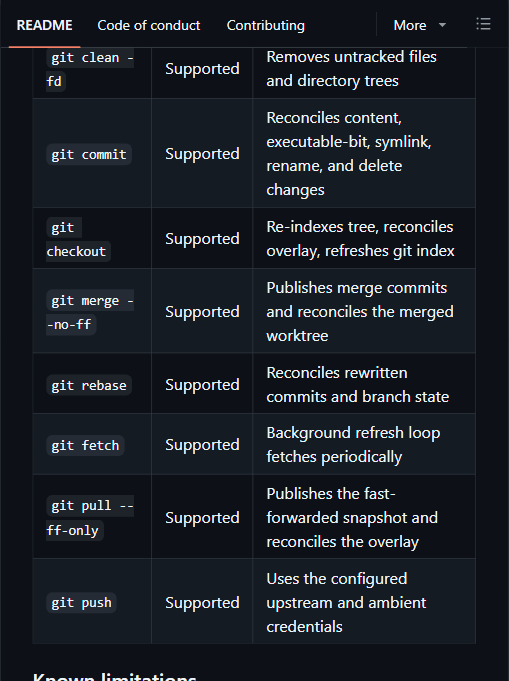
官方用 E2E 套件验证过的操作面相当全(见上图):
| 类别 | 操作 |
|---|---|
| 文件系统 | ls、cat/读、stat、mkdir、建/写文件、rename、rm、rmdir、truncate、chmod、符号链接 |
| 读类 git | log、branch、rev-parse、show、stash、diff、status、fetch |
| 写类 git | add、commit、checkout、reset —hard、clean -fd、merge —no-ff、rebase、pull —ff-only、push |
README 还提供**已验证来源(verified source)**模式做供应链加固:--require-commit <SHA> 在发布文件系统之前断言远程 ref 必须解析到这个提交,--depth 1 限制历史,--refresh never 关掉远程刷新;校验不通过则一个文件系统 generation 都不发布。
四、口径与局限:README 自己写明的边界
这一节最关键,全部来自官方”Known limitations”:
git status在大仓库上很慢:官方实测 5800+ 条目仓库里git status约 7 秒;git reset刷索引约 6.5 秒。根因是要透过 FUSE 走完整棵树。这与 Koala 点评”git status 等遍历操作开销极大”完全一致。- 子模块未初始化:gitlink 路径会显示成空目录,status 保持干净——需要子模块内容的场景别用它。
- checkout 过滤器与 EOL 转换不作用于快照读:在 Git 写入 overlay 之前,文件用的是规范 blob 字节,不做换行符转换。
- 依赖远端支持 partial-clone:远程必须支持 Git 部分克隆过滤才能按需 hydration;不支持的话 Git 会退化成 eager 下载所选版本的全部 blob(只是 depth 1 仍能省掉历史)。
- beta 质量:README 开头就声明 beta;日志里 clone/fetch 对已知瞬时错误重试最多 3 次,准备阶段有 30 分钟超时。
- 平台依赖 FUSE:需要 Go 1.26+,macOS 装 macFUSE、Linux 装 fuse3;Windows 不在支持列表——这印证了”短期更适合容器化 Agent 环境,桌面日常开发不如直接 clone”的判断。
五、客观分析:优势与适合人群
优势: 把”看到整棵树”和”下载全部内容”解耦,agent 沙箱里秒级进入仓库开工;blobless + 优先级 hydration 优先喂清单和源码,正中 LLM/CI 读取路径;CoW 叠加层让挂载点可写、又不污染原始 blob;--require-commit 的已验证来源对供应链场景是实打实的加固。
适合: 短命容器、agent 沙箱、CI 里”挂上来就跑、用完即弃”的大仓库;Linux 容器化环境。
不适合: 桌面交互式日常开发——频繁 git status 在大仓库上要等 7 秒,远不如直接 clone 一次;需要子模块、需要 EOL 转换或 checkout filter 的仓库;Windows 用户。它是为”启动速度比遍历性能更重要”的场景设计的,不是要替代本地 clone。