Anthropic《为 Agent 编写有效工具》:评估驱动的工具设计方法论
阅读时间: 大约 9 分钟
Anthropic《为 Agent 编写有效工具》:评估驱动的工具设计方法论
2025 年 9 月 11 日,Anthropic 工程团队(Ken Aizawa 主笔)发布工程文章《Writing effective tools for agents — with agents》。它不是一篇 API 文档,而是一套”给非确定性系统写软件”的方法论:先用原型跑通,再建评估集,最后让 Claude Code 反过来优化工具本身。本文基于官方原文,梳理其流程、内部数据与原则,并标注官方自己承认的口径边界。
一、为什么给 Agent 写工具是新问题
传统软件是确定性系统之间的契约:getWeather("NYC") 每次调用行为一致。而工具是确定性系统与非确定性 Agent 之间的契约——用户问”今天要带伞吗”,Agent 可能调用天气工具、可能凭常识回答、也可能先反问地点,偶尔还会幻觉或不会用工具。因此不能把给开发者写函数/API 的习惯直接搬过来,工具要”为 Agent 设计”。
二、评估驱动的迭代流程
官方推荐的闭环分三步:
- 快速原型:把工具包进本地 MCP server 或 DXT,接到 Claude Code 或 Claude Desktop 里亲手试用;
- 构建评估:用真实场景生成大量任务(例如”为 Jane 安排下周讨论 Acme 项目的会议,附上上次规划会笔记并预订会议室”),每个任务配可验证的结果;用程序化的 agentic loop(while 循环交替调用 LLM 与工具)跑评测,除准确率外还采集运行时长、工具调用次数、token 消耗、工具错误;
- 让 Agent 参与优化:把评估转录贴回 Claude Code,由它分析工具描述矛盾、schema 混乱、实现低效之处并批量重构。
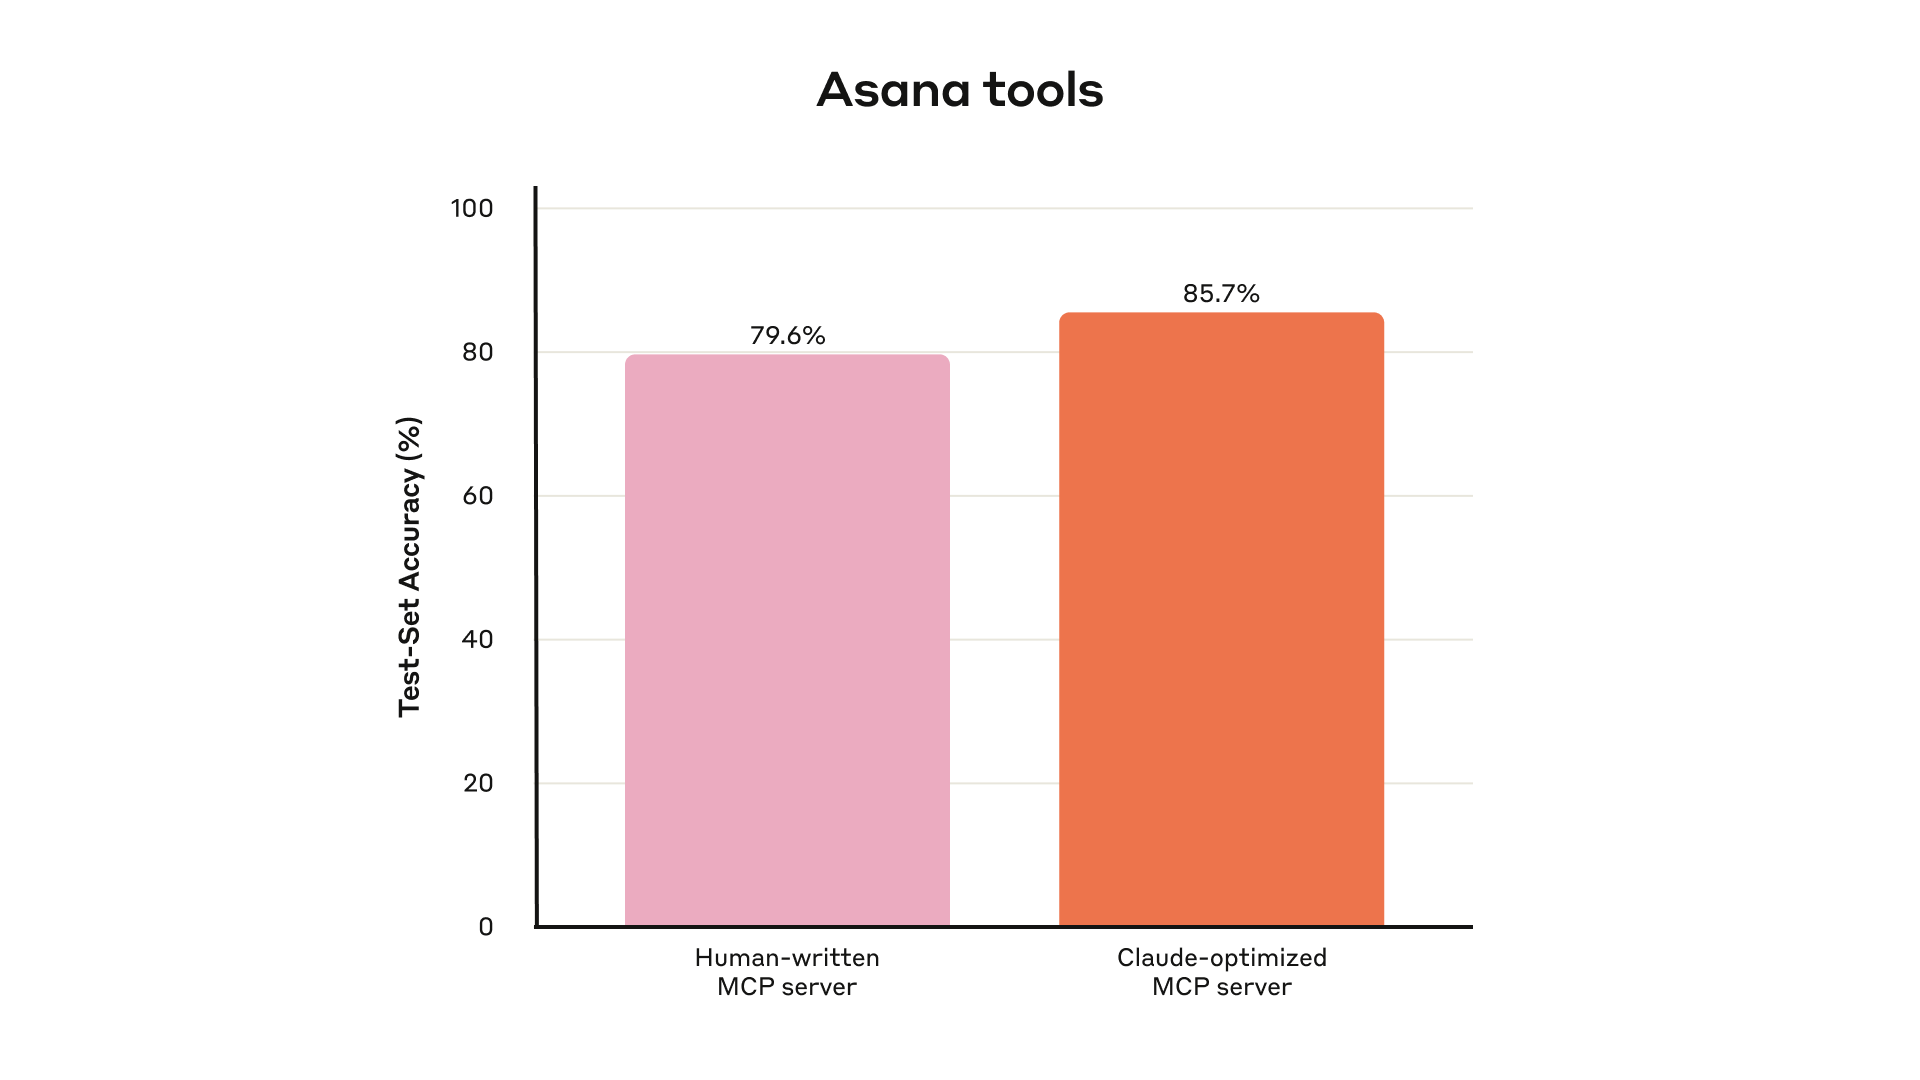
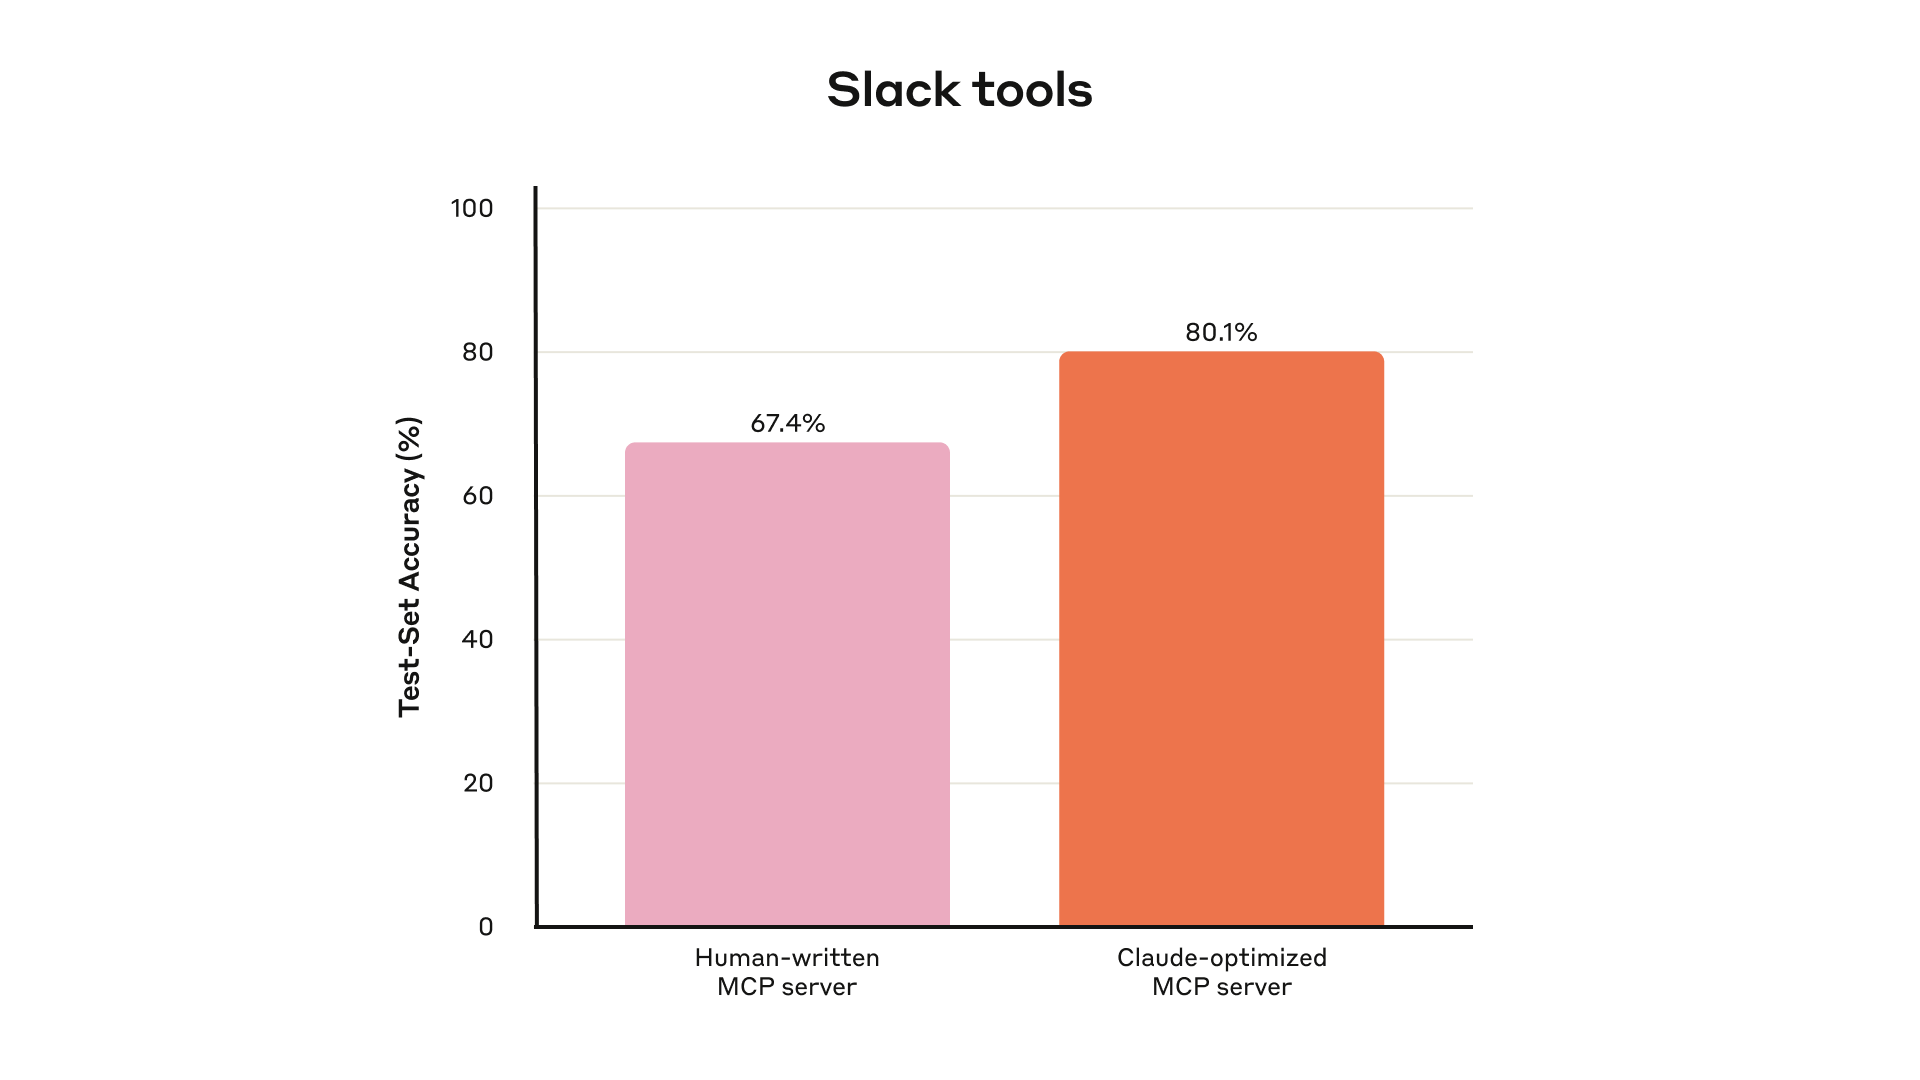
官方用两个内部工具集给出了留出测试集(held-out test set)上的结果:Slack 工具从人工编写的 67.4% 提升到 Claude 优化后的 80.1%;Asana 工具从 79.6% 提升到 85.7%。官方强调使用留出测试集是为了避免对”训练用”评估过拟合,且这一提升超过了研究专家手写的版本。
三、五条设计原则
1. 选对工具,而不是包装一切
工具越多不等于越好。常见错误是把现有软件功能或 API 端点逐个包成工具。官方建议按高价值工作流合并:与其做 list_users、list_events、create_event 三个工具,不如做一个 schedule_event(自动查空闲并预约);与其 read_logs,不如 search_logs 只返回相关行与上下文;与其 get_customer_by_id + list_transactions + list_notes,不如 get_customer_context 一次性汇总客户近期相关信息。
2. 命名空间划分边界
当 Agent 同时接入几十个 MCP server、上百个工具时,功能重叠会让 Agent 选错工具。按服务与资源加前缀/后缀命名(如 asana_search、jira_search、asana_projects_search)能划清边界。官方特别说明:前缀还是后缀命名对评测结果有非平凡影响,且效果随 LLM 不同而变化,应按自己的评估选择。
3. 返回高信号上下文,而非原始字段
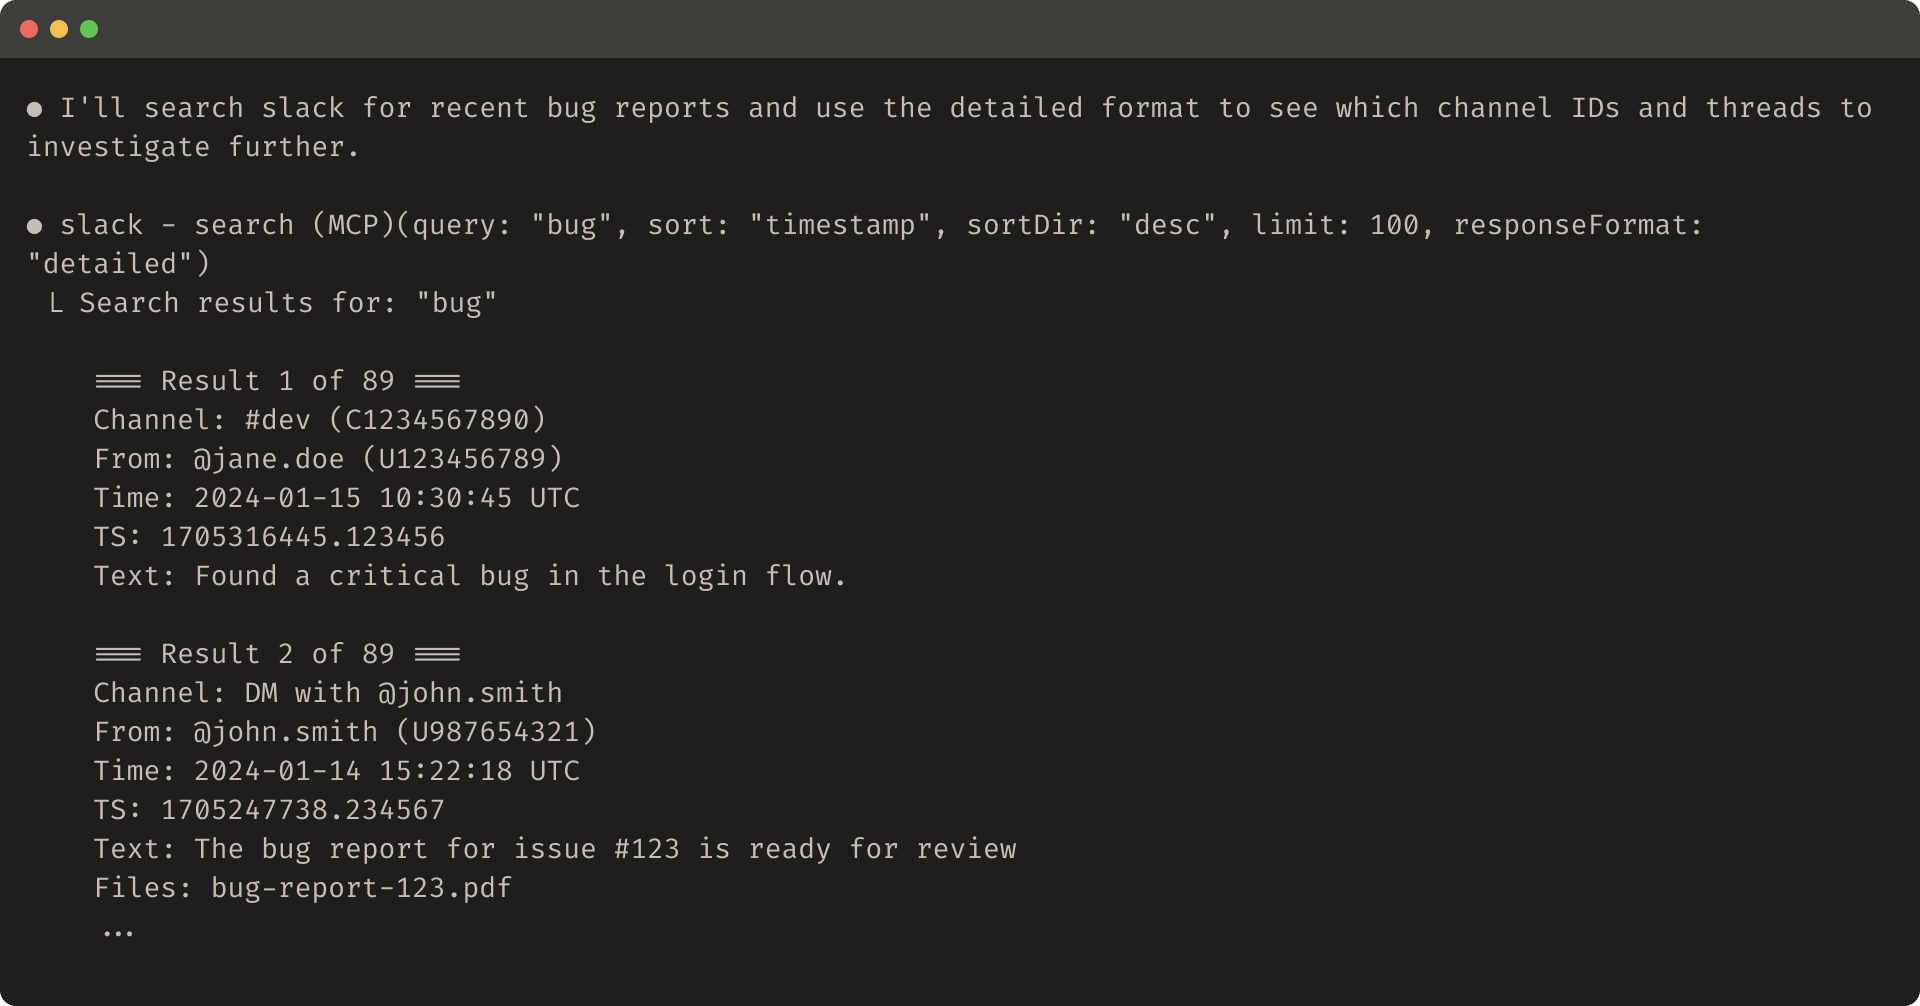
工具应只回传对下游动作有用的信息,避开 uuid、256px_image_url、mime_type 这类低层技术标识;把无意义的字母数字 UUID 解析成语义化名称(或 0 起始 ID)能显著提升检索精度、减少幻觉。官方用 response_format 枚举区分 detailed 与 concise:detailed 响应 206 token(含 channel_id、user_id、thread_ts 等后续调用所需 ID),concise 仅 72 token,约为前者的三分之一。
4. 为 token 效率优化响应量
可能撑爆上下文的响应要配合分页、范围选择、过滤、截断与合理默认值。官方披露 Claude Code 默认把工具响应限制在 25,000 token;截断时要用引导性文字劝 Agent 做多次小而准的搜索,而不是一次广撒网。错误响应也要可行动:给出合法 ID 示例与下一步调用建议,而不是丢一个 RESOURCE_NOT_FOUND 状态码。
5. 把工具描述当 prompt 工程来写
描述会被加载进 Agent 上下文,直接引导调用行为。参数名要无歧义(user 改为 user_id),隐式的查询格式、术语定义、资源关系都要写明。官方透露:在对工具描述做精确打磨后,Claude Sonnet 3.5 在 SWE-bench Verified 上达到了当时的 SOTA,错误率显著下降。
四、口径与局限
- 数字来自 Anthropic 内部工具与内部工作区:评估镜像了内部真实项目、文档与消息的复杂度,外部团队的任务分布、工具数量不同,67.4→80.1、79.6→85.7 不能直接照搬为预期收益;
- 优化者与被评估者同源:用 Claude 优化给 Claude 用的工具,存在协同偏差,换用其他模型效果需自行复测;
- 响应格式没有银弹:XML、JSON、Markdown 哪种更好取决于任务与模型训练分布,官方明确反对一刀切;
- 评测任务设计本身有门槛:过严的校验器会因格式、标点差异误杀正确答案,而过简的”沙盒任务”压不出工具的真实缺陷。
五、优势与适用人群
优势: 把”工具质量”从主观感觉变成可测量、可回归的评估问题;强调合并工具、压缩上下文、错误可行动,都是可直接落地的工程习惯;让 Agent 参与工具优化的闭环成本很低。
局限: 需要先有一批真实任务与校验器,小团队冷启动成本不低;内部数据不可复现;方法论对单工具、简单脚本类场景收益有限。
适合正在搭建 MCP 工具生态、多工具并行调用、且已经能跑出一批真实任务日志的团队。它的核心启示是:工具文档不是写给人看的说明书,而是喂给模型的 prompt,需要像调 prompt 一样用评估集反复调。